2026 年 AI Coding 工具怎麼選:Cursor、Claude Code、Codex 與雲端 Agent
這是「Agentic Engineering 實戰手冊」系列的第三篇。上一篇:工程師角色重新定義
我的信用卡帳單不會騙人,但規格表很快會過期
我的信用卡帳單上同時有 Cursor Pro、Claude Pro、GitHub Copilot 三筆訂閱。加上偶爾用的 Anthropic API,上個月光 AI coding 工具就花了快 $200 美金。
Cursor 和 Claude Code 是我長期放進 production 工作流的主力;Codex、Copilot 與幾種雲端 agent,我也實際拿任務測過,但使用時間沒有前兩者長。
我不想再做一張 context window、月費、模型名稱排得密密麻麻的表。這些數字改版一次就過期,而且「標稱能放多少 token」也不等於它在你的 repo 裡能記住多少。本文的產品狀態查核到 2026 年 7 月 14 日;價格與模型請以各家即時頁面為準。這裡只談比較耐用的東西:它怎麼工作、適合什麼任務、出了錯你能不能收拾。
我常用的四種工作方式
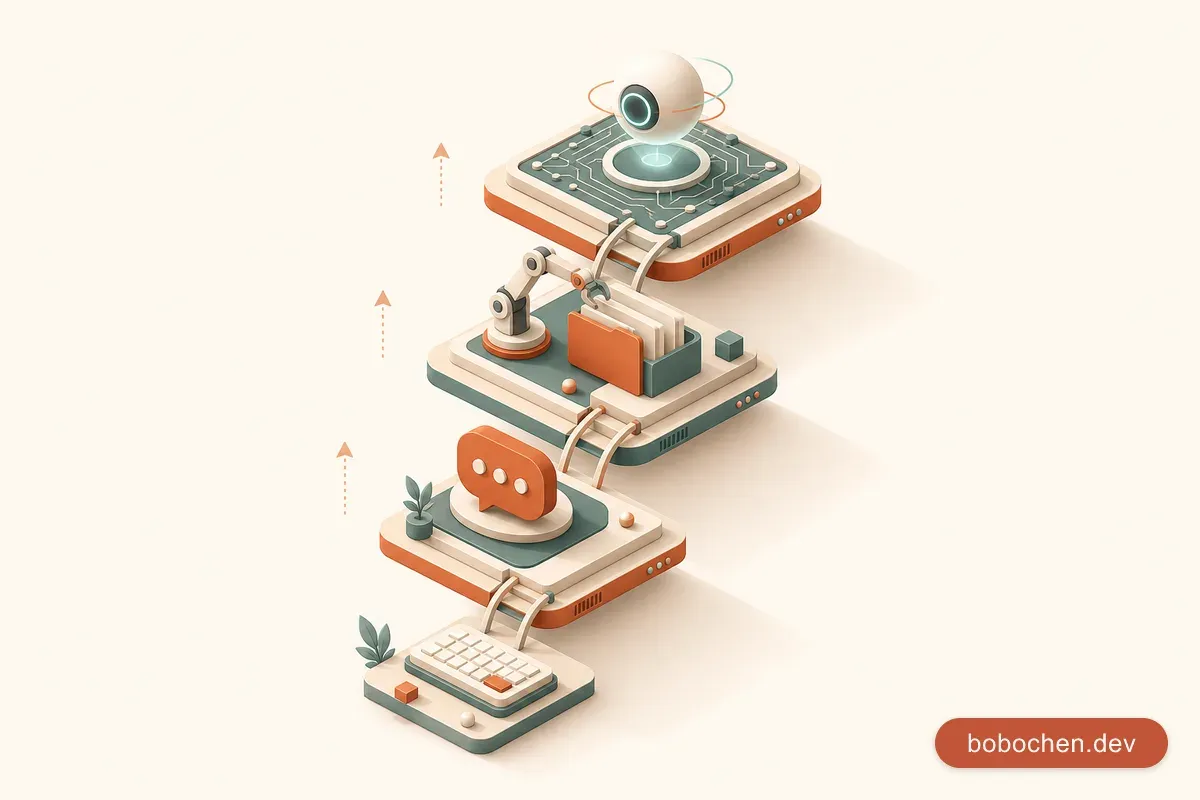
比較工具前,我會先看這次想怎麼工作。下面四種是我自己習慣的分法,同一個產品可能同時做得到其中兩三種。
Level 1:Autocomplete(自動補完)
最基本的一層。你在打字,AI 猜你接下來要寫什麼,按 Tab 接受。
代表工具:GitHub Copilot 的 tab completion、Cursor 的 tab prediction。
適用場景:重複性的 boilerplate code、已知 pattern 的實作。就像手機鍵盤的預測文字,方便,但不會幫你思考。
Level 2:Chat(對話式)
你可以問 AI 問題、請它解釋 code、或者讓它產生一段程式碼給你複製。
代表工具:Copilot Chat、Cursor Chat、ChatGPT、Gemini。
適用場景:理解不熟悉的 code、生成 snippet、brainstorm 解法。本質上還是你在主導,AI 是你的顧問。
Level 3:Agent(代理執行)
AI 可以直接操作你的 codebase——讀檔案、寫檔案、跑指令、修 bug。你給它任務,它自己去做。
代表工具:Claude Code、Cursor Composer Agent Mode、Codex CLI、Gemini CLI。
適用場景:完整的 feature 開發、bug fix、refactoring。這時我花比較多時間交代任務、檢查修改,而不是逐行輸入。
Level 4:Autonomous(全自主)
AI 不只執行你的指令,而是可以自主工作數小時甚至數天。你設定目標,它自己規劃、執行、測試、提交 PR。
代表工具:Devin、Codex cloud tasks,以及其他能在隔離環境中非同步執行任務的 cloud agent。
適用場景:長時間的 migration、大範圍的 test coverage 補全、independent project setup。但目前可靠性仍然有限。
我的日常大多落在 Level 2–3。Level 4 並非不能上 production,而是要挑可回滾、可客觀驗收的任務,並保留人工 review;「丟出去幾小時」不等於「回來可以直接 merge」。
我平常用得最多的是中間兩種,圖裡把它們框了起來:
flowchart TD
    L1["Level 1:自動補完<br/>GitHub Copilot tab completion<br/>Cursor tab prediction"] --> L2
    subgraph ME["我的日常落點:Level 2–3"]
        L2["Level 2:對話<br/>Copilot Chat、Cursor Chat<br/>ChatGPT、Gemini"]
        L3["Level 3:代理執行<br/>Claude Code、Codex CLI<br/>Cursor Composer Agent Mode<br/>Gemini CLI"]
        L2 --> L3
    end
    L3 --> L4["Level 4:全自主<br/>Devin、Codex cloud tasks"]
這兩種方式比較符合我的習慣:可以先問清楚,再讓 agent 改檔案;途中看到方向不對,也能隨時調整。至於交出去幾小時再回來看的任務,我會挑得更仔細。
Cursor、Claude Code、Codex CLI,我各拿來做什麼
下面是我的使用心得。Cursor 和 Claude Code 用得比較久,Codex 主要拿來做第二意見,不能把這些經驗當成所有專案都適用的排名。
Cursor
我用了多久:一年多。Cursor 是我 AI coding 的起點。
我覺得好用的地方:
- File-aware editing 是它最強的地方。在我日常的專案裡,它的 auto-complete 常能接上正在寫的內容。
- Tab prediction 有時候準到有點可怕。你才剛想到要寫什麼,它已經建議好了。
- Agent Mode 加入之後,它可以做一些簡單的 multi-file 修改。
- 對前端開發特別友好——React、CSS、HTML 的補完非常到位。
踩坑紀錄:
- 處理大型專案時,我仍常遇到它漏掉前面看過的檔案。這也是我不再用標稱 context window 判斷工具的原因。
- Agent Mode 對於複雜的跨檔案修改還是不夠可靠,常常改了 A 忘了更新 B。
- 方案、額度與模型選項改得很快,實際成本不容易只看月費預估。
最適合:日常 coding、快速 iteration、前端開發、pair programming 式的工作流。
Claude Code
我用了多久:重度使用九個月。現在是我的主力工具。
我覺得好用的地方:
- 處理複雜、多檔案任務是我最常用它的理由。那種需要先讀十幾個檔案、理解資料流,再修改與驗證的 bug,在我的專案裡成功率比較穩。
- Terminal-based 的操作方式看似原始,但其實更符合 agentic 工作流——你下指令,它自己去做,你不需要盯著 IDE 看。
- CLAUDE.md 配置系統讓你可以高度自訂 agent 的行為。這在後面的 CLAUDE.md 大師班 會深入討論。
踩坑紀錄:
- 成本可以很高,尤其是長 session、反覆讀大檔案或同時開 subagent 時。
- 偶爾會過度自信——修了 A 但沒注意到 A 的改動會影響 B。
- 沒有 IDE 的視覺化界面,新手上手曲線比較陡。
最適合:複雜問題(multi-file bugs、架構決策)、不熟悉的 codebase、需要深度推理的任務。
Codex CLI
我用了多久:斷斷續續用了幾個月,主要拿來做第二意見與獨立 review。
我覺得好用的地方:
- 本機執行邊界清楚。Codex CLI 會用作業系統提供的沙箱限制檔案與網路存取;macOS 與 Linux 的實作不同,並不是每個平台都跑在 Linux container 裡。
- 中途可以修正方向。長任務走偏時,我可以直接補限制,不必整段重來。
- 同一份 diff 交給另一個模型 review,常能抓到主力工具忽略的假設。
踩坑紀錄:
- 對於需要理解複雜架構的任務,我覺得推理能力略遜於 Claude Code。
- 規則檔、權限與工具設定和 Claude Code 不完全相同,兩套工作流要刻意維護,不能只複製檔名就期待行為一致。
- 模型、額度與產品介面更新很快,文章裡寫死版本通常撐不了多久。
最適合:需要高安全性的環境、想要 second opinion 的時候、OpenAI ecosystem 的使用者。
三工具對照表
| 維度 | Cursor | Claude Code | Codex CLI |
|---|---|---|---|
| 主要介面 | IDE 內操作 | 終端機 | 終端機 |
| 我最常拿來做 | 邊寫邊改、UI 微調 | 複雜多檔案任務 | 第二意見、獨立 review |
| 執行邊界 | 依模式與設定而異 | 權限規則;Bash 可另開 OS 級沙箱 | OS 級沙箱與核准策略 |
| 常見摩擦 | 大任務容易漏改相關檔案 | 長 session 成本與上手門檻 | 規則與權限要另維護 |
| 我的使用占比 | 約 15% | 約 80% | 約 5% |
安全性不能只看表格上的「有 sandbox」。你還要確認預設可寫哪些路徑、能不能連網、外部憑證是否可見,以及高風險命令需不需要核准。產品行為請回到 Claude Code sandbox 文件與 Codex 官方文件核對。
另外三種值得看的路線:Devin、Kiro、JetBrains Central
這三個我使用時間不長,以下是初步評估而非深度心得。
Devin
Cognition 把 Devin 定位成能在雲端工作環境中接任務、修改程式並提出 PR 的 agent。它和本機 CLI 最大的差別,不只是「更自主」,而是執行環境、任務佇列與協作介面都由服務代管。
我的觀察:適合規格清楚、環境可重建、驗收可自動化的任務。官方成功率或客戶案例可以參考,卻不能當成你的 merge rate;最可靠的做法仍是拿自己的 repo 做小型試點。
AWS Kiro
Kiro 的核心是 spec-driven workflow:先把需求、設計與工作項目落成檔案,再依 task 執行。它也不是「每個子任務都自動附好測試與驗收」;接受條件要先在 requirements 寫清楚,task 是否逐一或平行執行則由使用方式決定。官方 Specs 文件有現行結構。
我的觀察:Spec-driven 的方向很適合跨多檔案、需要留下決策紀錄的工作(下一篇 Spec-Driven Development 會細談)。是否適合你,應看它能否融入既有 repo、review 與 CI,而不是先看雲端品牌。
JetBrains Central
JetBrains 在 2026 年 3 月 24 日發表 Central,把它定位成 agentic software development 的控制平面,處理治理、agent 執行與共享的程式語意 context。
我的觀察:產品仍新,適合關注或做受控試點,還不適合只憑發表內容就全面遷移。尤其企業導入要先驗證權限、資料邊界與 audit log。
我的最終組合與為什麼
實戰一年下來,我的主力組合是:
- Claude Code 80%——所有需要「思考」的任務:複雜 bug、架構決策、multi-file 修改、不熟悉的 codebase。
- Cursor 15%——routine coding、快速 iteration、前端細節調整。當我需要「寫」多於「想」的時候。
- 其他 5%——Copilot 的 tab completion 偶爾用、Codex CLI 偶爾拿來做 second opinion。
換成實際任務,我大致這樣選:
| 任務類型 | 我選什麼 | 為什麼 |
|---|---|---|
| 複雜 bug fix | Claude Code | 需要深度推理和大 context |
| 新 feature 從零開始 | Claude Code | 需要架構決策 |
| UI 微調 / CSS 修改 | Cursor | 視覺回饋快,iteration 快 |
| 快速 boilerplate | Cursor / Copilot | Tab completion 最快 |
| 不熟悉的 repo 探索 | Claude Code | 我較習慣它的探索與摘要方式 |
| 需要 second opinion | Codex CLI | 不同 model 的另一個視角 |
選工具的五個常見錯誤
最後分享五個我看到(也犯過)的錯誤:
1. 功能多 ≠ 適合你
大部分時候 Level 3(agent)就夠了,你不一定真的需要 autonomous agent。先看目前的工具卡在哪,再決定要不要換。
2. Context window 大 ≠ 記得完整
Context window 是容量上限,不是理解保證。工具怎麼搜尋 repo、挑選檔案、壓縮舊對話,往往比最大 token 數更影響結果。用自己的大型任務測「會不會漏掉關聯檔」,比引用別人的單次實測可靠。
3. 價格低 ≠ 省錢
便宜的工具如果讓你花更多時間重做,總成本可能更高。可以用一個很樸素的公式比較:月費與 API 費 + review/返工時數 × 你的時間成本。兩週後再看數字,不要只看訂閱頁。
4. 跟風 ≠ 對
Twitter 上的 influencer 用某個工具用得很順,不代表你也會。你的 codebase、你的 tech stack、你的工作流都不一樣。唯一可靠的方式是自己試。
5. 一個工具打天下
沒有一個工具適合所有場景,但這不表示每個人都需要三份訂閱。先用一個主力工具建立穩定流程;只有當第二個工具能補上明確缺口,例如獨立 review 或 IDE 內快速修改,再增加它。
訂閱值不值得,還是得看自己的帳
我會把完成時間、review、重做和漏掉的問題一起記下來,過一陣子再看花的錢有沒有換到時間。我的使用比例只是目前的習慣;如果一個工具就能做好你的工作,也不用為了湊齊組合多付兩份訂閱。
上一篇:工程師角色重新定義 下一篇:Context Engineering 深度解析