Referer 一行 curl 就能偽造,圖片防盜連為什麼還靠它?
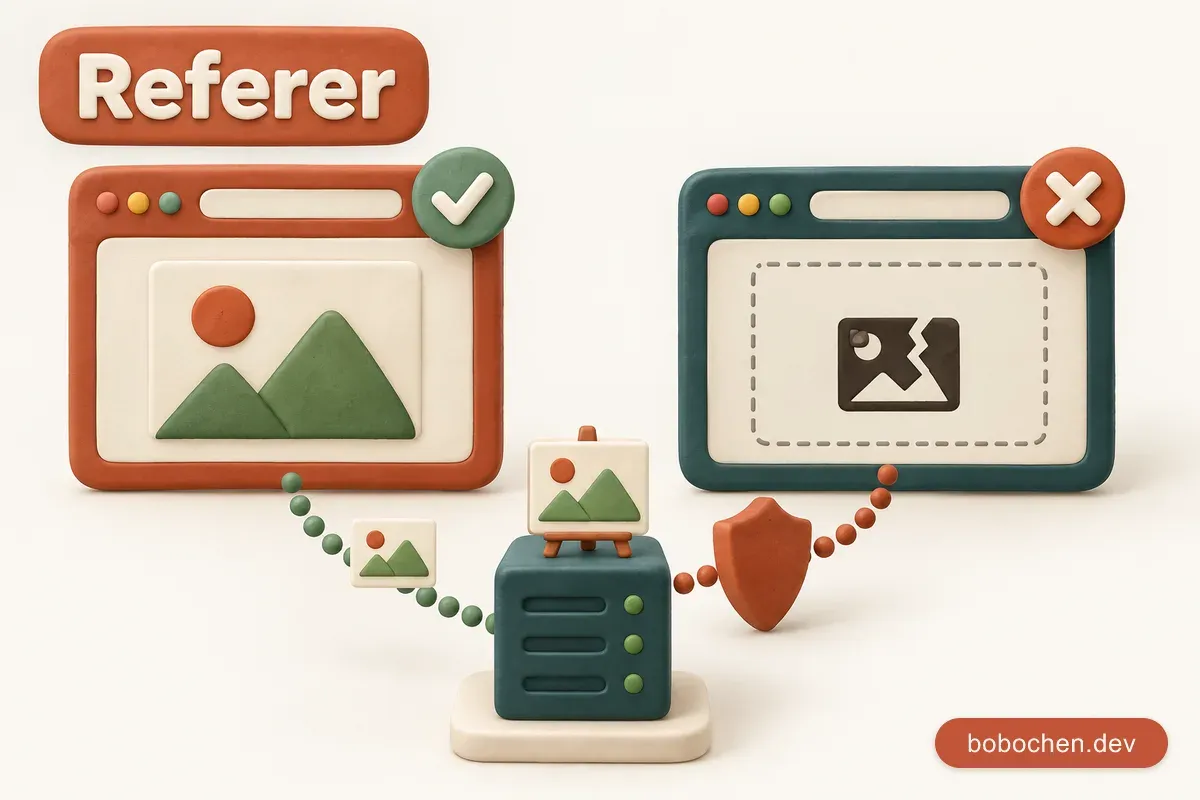
你辛苦做了一張圖,放在自己的網站上。某天發現它出現在別人的網站,對方沒下載、也沒重新上傳,只在他的網頁裡寫了一行:
<img src="https://你的網站/cat.jpg">這就叫盜連(hotlinking)。讀者打開的是他的網站,但那張圖,是讀者的瀏覽器直接跑來你的伺服器拿的。
換成開店來想比較好懂:你的倉庫裡放著商品照片;隔壁新開的店沒有倉庫,只在貨架上貼一張單子:「照片請到某某倉庫拿」。客人每經過那個貨架,就自己跑去你的倉庫搬一張回來看。客人以為在逛隔壁的店,運費全算你的。
聽起來只是一張圖,麻煩其實有三個:
- 流量是你在付。他的網頁被看一萬次,你的伺服器就出貨一萬次。主機或 CDN 按流量計費的,帳單算你的;有流量上限的,額度是被他吃掉的。
- 功勞是他的。讀者看到的是他的網站,自然以為圖也是他的。你花時間做的圖,變成在替別人衝人氣。
- 你管不到它出現在哪裡。你的圖可能被掛在任何網站、擺在任何內容旁邊,包括你一點都不想扯上關係的那種。
所以才有「防盜連」:圖只給自己的網頁用,別人的網頁要來拿,就不給。
先講結論:防盜連擋的不是下載,是別人的網頁叫你的伺服器出貨
要怎麼分辨「是不是自己的網頁來拿」?最常見的做法我一直知道個大概:HTTP 請求裡有個 Referer 欄位,記錄這個請求是從哪個網頁發出來的。伺服器檢查它,不是自己的網域就拒絕。
但這個欄位不是一行 curl 就能改嗎?我對一台開了防盜連的 nginx 試了一下。先老實報上盜連網站的網域,再謊稱自己是它自家的網頁:
$ curl -sI -e 'http://localhost:8082/' http://127.0.0.1:8081/cat.jpg
HTTP/1.1 403 Forbidden

$ curl -sI -e 'http://127.0.0.1:8081/' http://127.0.0.1:8081/cat.jpg
HTTP/1.1 200 OK
改一個字串就過了。那防盜連為什麼到現在還靠它?
我在筆電上用 nginx 架了一個圖床,另外開一個盜連網站,再用 Playwright 驅動 Chrome 跑了一輪。答案是:盜連的時候,發出請求的是讀者的瀏覽器,不是盜連的人。
盜連網站只寫得了 HTML,寫不了 header。它可以叫瀏覽器「別填」Referer,卻沒辦法叫瀏覽器「填假的」。所以整件事最後落在一個問題上:沒填 Referer 的請求,要不要放行?
先把重點濃縮成一張表:
| 你可能以為 | 其實是 |
|---|---|
| Referer 一行 curl 就能偽造,拿來防盜連沒用 | 盜連時發請求的是讀者的瀏覽器。我在盜連網站用 JavaScript 塞一個假的 Referer,Chrome 照樣送出盜連網站自己的網址 |
| Referer 會帶上完整網址,連讀者在看哪一篇都知道 | Chrome 85 之後,跨來源只送網域。我從盜連網站的 hotlink.html 發出請求,送到圖床的 Referer 只剩網域,路徑整段被剪掉 |
| CDN 的防盜連會擋掉沒有 Referer 的請求 | Cloudflare 的預設就是放行,因為直接開圖、從 App 點開本來就沒有 Referer。盜連網站只要在圖片標籤加一個 no-referrer 屬性,就從這個洞鑽過去 |
| 開了防盜連,別人就拿不走我的圖 | 防盜連擋的是「別的網頁直接嵌你的圖」,不是下載。連空 Referer 都擋的 Pixiv,curl 補上 Pixiv 自己的網域當 Referer,就拿到原圖 |
| 設了 CORP,被瀏覽器擋下的圖就不花流量 | 請求照樣打到伺服器,瀏覽器收到回應才喊停。我拿 10 MB 的檔案測六次,喊停前已經送出 64 KB 到 640 KB |
盜連是怎麼發生的:一個 <img>,等於叫讀者的瀏覽器跑一趟你家
開頭那個開店的比喻,換回網路的語言是這樣:
sequenceDiagram
    participant B as 讀者的瀏覽器
    participant H as 盜連的網站
    participant Y as 你的圖床
    B->>H: 打開文章頁
    H-->>B: HTML<br/>裡面有張圖指向你的圖床
    B->>Y: GET /cat.jpg<br/>Referer:盜連網站的網域
    Y-->>B: 200,整張圖<br/>流量算你的
    Note over H,Y: 盜連網站的伺服器<br/>從頭到尾沒碰過這張圖
盜連網站只出了一份 HTML。真正來敲你門的,是讀者的瀏覽器。
這不是漏洞,是 <img> 生來的設計。Marc Andreessen 在 1993 年 2 月提議這個標籤時,SRC 就是一個網址,讓瀏覽器自己「pull over the network」,從網路上抓回來嵌在文字裡。提案裡沒有任何「只能抓自己網站的圖」的限制。
這也決定了你能擋的範圍:你的伺服器只看得到這個請求本身,要哪個檔案、從哪個 IP 來,再加上瀏覽器自己附上的幾個 header。Referer 就是其中一個。
第一招:看 Referer,瀏覽器替你填好的「從哪裡來」
我用 Docker 跑一台 nginx 當圖床(http://127.0.0.1:8081),再用 Python 內建的 HTTP server 開一個盜連網站(http://localhost:8082)。對瀏覽器來說,127.0.0.1 跟 localhost 是兩個不同的網站。
nginx 的 access log 改成會記下 Referer,然後用 Chrome 從兩個地方載同一張 cat.jpg(log 只留下相關的欄位):
# 圖床自己的頁面 http://127.0.0.1:8081/index.html
"GET /cat.jpg" status=200 referer="http://127.0.0.1:8081/index.html"

# 盜連網站的頁面 http://localhost:8082/hotlink.html
"GET /cat.jpg" status=200 referer="http://localhost:8082/"
同一張圖、同一台伺服器,看 Referer 就分得出來。nginx 內建的 valid_referers 就是做這件事:
valid_referers none blocked server_names;

location / {
    if ($invalid_referer) {
        return 403;
    }
}
valid_referers 列出哪些 Referer 算自己人,對不上的,$invalid_referer 就會變成 1。這三個關鍵字在 nginx 官方文件裡的定義是:
server_names:Referer 裡有這台伺服器server_name設定的網域,比對時不管 port。none:請求裡根本沒有 Referer。blocked:有 Referer,但內容被防火牆或 proxy 刪掉了,也就是不以http://或https://開頭。
加上去重跑,盜連網站上的圖就破了:
"GET /cat.jpg" status=403 referer="http://localhost:8082/"先記住 none 這個字,後面的故事都跟它有關。
冷知識:Referer 是拼錯的,連 HTTP 標準都替它加註「原文如此」
正確的英文拼法是 referrer,兩個 r。現行的 HTTP 標準 RFC 9110 定義這個欄位時,自己先認了:
The “Referer” [sic] header field allows the user agent to specify a URI reference for the resource from which the target URI was obtained (i.e., the “referrer”, though the field name is misspelled).
[sic] 是「原文如此」,後面的括號直接講明:也就是 referrer,只是欄位名稱拼錯了。這個註記從 1997 年的 RFC 2068 一路標到現在,1996 年的 RFC 1945 還沒有。
有人在郵件論壇上抓到這個錯字,是 1995 年 3 月。HTTP 工作小組裡,Northwestern 大學的 John Franks 問:「有沒有人發現 HTTP 的 Referer: 拼錯了?」有人猜是英式拼法;RFC 1945 的共同作者 Roy Fielding 則回了 Franks 一句:
That’s okay, neither one (referer or referrer) is understood by “spell” anyway. I say we should just blame it on France. ;-)
— Roy T. Fielding,ietf-http-wg 郵件論壇,1995 年 3 月
翻成白話:沒差啦,反正 spell 兩種拼法都不認得,就怪法國吧。spell 是 Unix 上檢查拼字的指令。後來 IBM 英國實驗室的 Mike Cowlishaw 出面否認英式拼法的說法:「才不是,我們英國人總共拼四個 R。」
那到底是誰拼錯的?維基百科說,錯字出自提議這個欄位的 Phillip Hallam-Baker 的原始提案。但那份提案,按他自己的說法,是一封寄給 Tim 的建議信(HTTP 的發明人 Tim Berners-Lee,信裡只寫了 Tim),網路上找不到。他本人的說法也前後不一:
- 1995 年,就在同一串討論裡,他說這個應該算 Tim 的:「我寄了建議給他,但印象中沒替欄位取名字。」
- 1997 年,他在同一個論壇寫下「A while back I suggested (and mispelt) the referer field」,改口說是自己拼錯的。
- 2000 年,他在 Usenet 上開玩笑:
I am now attempting to get the spelling corrected in the OED since my spelling is used several billion times a minute more than theirs.
— Phillip Hallam-Baker,alt.folklore.computers,2000 年 9 月
意思是:他正在想辦法讓牛津英語詞典改拼法,因為他的拼法每分鐘被用的次數,比詞典那個多了好幾十億次。
還有一個小細節:他 1995 跟 1997 年那兩封信裡的「拼錯」,寫成了 mispell 跟 mispelt,也都少了一個 s。
2020 年之後,Referer 只剩網域
仔細看剛剛那行 log:盜連頁面的網址是 http://localhost:8082/hotlink.html,送到圖床的 Referer 卻只有 http://localhost:8082/,路徑不見了。
這是瀏覽器刻意剪掉的。管這件事的規則叫 Referrer Policy,Chrome 從 85 版(2020 年 8 月的穩定版)開始把預設值改成 strict-origin-when-cross-origin(Chrome 官方公告),Firefox 87(2021 年 3 月)跟進,Safari 背後的 WebKit 也在 2021 年 7 月改了同一個預設值。
名字很長,拆開是三條規則:
| 請求往哪裡送 | Referer 送什麼 | 我的實測 |
|---|---|---|
| 同一個來源(協定、網域、port 全部一樣) | 完整網址 | http://127.0.0.1:8081/index.html |
| 不同來源,安全等級一樣 | 只送「協定+網域+port」 | http://localhost:8082/ |
| 從 HTTPS 頁面去要 HTTP 的東西 | 什麼都不送 | 這次沒測 |
「不同來源」的門檻比想像中低。我另外從 http://127.0.0.1:8083 的頁面載 8081 的圖,只差一個 port,Referer 一樣被剪成 http://127.0.0.1:8083/。
瀏覽器願意主動少講,是因為網址常藏著不該外流的東西,而以前的 Referer 會把完整網址送給頁面上每一個外站資源。2015 年美聯社報導、EFF 獨立確認:美國健保網站 HealthCare.gov 的網址裡帶著郵遞區號、收入、有沒有抽菸、有沒有懷孕,這些資料經由 Referer 送到了至少 14 個第三方網域。Firefox 87 的公告也直說,剪掉路徑跟查詢字串,是為了避免網站不小心洩漏使用者的敏感資料。
對防盜連來說這個改變影響不大,本來就只需要比對網域。受影響的是另一種需求:如果你想「只讓某一篇文章嵌這張圖」,現在的瀏覽器預設不會告訴你是哪一篇。
冷知識:隱私問題,Referer 一出生就被點名了
Tim Berners-Lee 1993 年 11 月提交給 IETF 的第一版 HTTP 草案裡,Referer 已經在了。當時寫的用途很單純:讓伺服器產生「有誰連到我」的反向連結清單,順便追查壞掉的連結。
同一份草案的安全考量段也點名了它:Referer 能拿來研究讀者的閱讀習慣,很有用,但也可能被濫用;就算拿掉了個人資訊,它本身也可能是一份機密文件的網址。這段的最後一句是:
A method of suppressing the Referer information in such cases may be the subject of further study.
— Tim Berners-Lee,HTTP Internet Draft,1993 年 11 月
意思是:遇到這種情況要怎麼不送 Referer,可以之後再研究。這個「之後」一等就是二十幾年:Referrer Policy 的第一版草案出現在 2014 年,Chrome 改預設值已經是 2020 年。
後來這些新東西全都拼對了:Referrer-Policy、referrerpolicy,還有 JavaScript 的 document.referrer(1998 年的 DOM Level 1 就是兩個 r)。Referrer Policy 規格還特地加了一行註解:
Note: The header name does not share the HTTP Referer header’s misspelling.
— W3C,Referrer Policy
更早的 CSP 1.1 草案(2014 年)也寫過同樣意思的註解,說它的 referrer 指令沒有沿用 HTTP header 的拼錯。結果同一段的開頭,自己把 referrer 打成了 refererrer。
Referer 能偽造,但盜連的人偽造不了
開頭那兩行 curl 證明了一件事:Referer 就是一行文字,誰發請求誰就能寫。nginx 只是在比對字串,分不出這行字是瀏覽器填的還是人手寫的。curl 的官方文件介紹 -e 時,範例直接就填 https://fake.example。
真實網站也一樣。Pixiv 的圖床連「沒有 Referer」都擋,但 curl 補上 -e https://www.pixiv.net/,就拿到一張 1.3 MB 的原圖。
nginx 自己在文件裡也講白了:
It should be kept in mind that fabricating a request with an appropriate “Referer” field value is quite easy, and so the intended purpose of this module is not to block such requests thoroughly but to block the mass flow of requests sent by regular browsers.
— nginx,Module ngx_http_referer_module
意思是:造一個帶著「正確」Referer 的請求很容易,所以這個模組本來就不打算把這種請求擋乾淨,它要擋的是一般瀏覽器送來的大量請求。
這句話就是防盜連能成立的原因。盜連的人站不到 curl 這個位置:他能控制的只有自己網頁裡的 HTML 跟 JavaScript,真正發請求的是讀者的瀏覽器,而瀏覽器不讓網頁亂寫這一欄。Fetch 規格把 Referer 列為網頁程式不能自己設定的標頭,理由是讓瀏覽器對它保有完全的控制權。
fetch() 倒是留了一個 referrer 選項可以改 Referer,但規格限定只能填「同一個來源」的網址。我在盜連網站寫了這段,試著冒充圖床自己的頁面:
fetch('http://127.0.0.1:8081/cat.jpg', {
  mode: 'no-cors',
  referrer: 'http://127.0.0.1:8081/', // 冒充圖床自己的頁面
});
console 沒有任何錯誤,但圖床收到的是:
"GET /cat.jpg" referer="http://localhost:8082/" sec_fetch_site="cross-site"Chrome 默默把假的值換回盜連網站自己的網域。規格就是這樣寫的:填了跨來源的網址不會報錯,而是悄悄換回預設值。
所以在瀏覽器裡,盜連網站對 Referer 只有兩個選擇:照實填,或者不填。
最大的洞:沒填 Referer 的請求,要不要放行?
「不填」聽起來很可疑,但正常情況下沒有 Referer 的請求多得是:
- 直接把圖片網址貼到網址列。我用 Chrome 直接開那張圖,log 上的 Referer 是
-,也就是沒有。 - 從書籤、App、email 點開。
- 瀏覽器的隱私設定、外掛,或是公司的 proxy 把它拿掉了。後者就是 nginx
blocked在處理的情況。
HTTP 標準講到「拿 Referer 擋別的網站」這個用法時,也順手點出了這個弱點:
Some servers use the Referer header field as a means of denying links from other sites (so-called “deep linking”) or restricting cross-site request forgery (CSRF), but not all requests contain it.
意思是:有些伺服器拿 Referer 來擋別的網站連進來,或是防 CSRF,但不是每個請求都會帶它。
要是把沒帶 Referer 的請求一律擋掉,上面列的那些讀者全都看不到圖。所以 Cloudflare 的 Hotlink Protection 預設放行,文件寫得很清楚:
Technically, this means that Hotlink Protection denies access to requests when the HTTP referer does not include your website domain name (and is not blank).
— Cloudflare Docs,Hotlink Protection
重點在最後那個括號:「而且不是空白」。Referer 空白的,一律放行。Bunny CDN 則是要另外打開「Block Direct URL File Access」這個選項,才會擋掉空 Referer,文件也提醒這可能誤傷 email 用戶端、部分手機 App 跟注重隱私的瀏覽器。
問題是,這個洞盜連網站也鑽得進去。它只要在 <img> 上加一個屬性:
<img src="http://127.0.0.1:8081/cat.jpg" referrerpolicy="no-referrer">或是在頁面的 <head> 放一行 <meta name="referrer" content="no-referrer">。我對剛剛開好防盜連的 nginx 各試一次,兩張圖都照樣出現:
"GET /cat.jpg" status=200 referer="-"
"GET /cat.jpg" status=200 referer="-"
瀏覽器照盜連網站的指示乖乖不填,nginx 把它當成「直接開圖」放行了。這招在中文技術社群流傳很久,從 2019 年 V2EX 上教人嵌微博圖床的討論,到 2023 年張鑫旭的文章都還在教。
真實世界的網站在這題上各自選了邊。我用 curl 對幾個圖床各打三次:不帶 Referer、帶它自家網域、帶一個不相干的 https://example.com/:
| 圖床 | 不帶 Referer | 帶自家網域 | 帶 example.com |
|---|---|---|---|
| Pixiv 圖床 i.pximg.net | 403 | 200 | 403 |
| 微博圖床 sinaimg.cn | 200 | 200 | 403 |
| 維基共享資源 upload.wikimedia.org | 200 | 200 | 200 |
| 我的部落格 bobochen.dev | 200 | 200 | 200 |
Pixiv 選了最嚴格的路:沒帶 Referer 一律 403,連 none 這扇門都關了。微博是 none 加白名單,第一次看會覺得邏輯顛倒:什麼都不帶反而過,帶一個看起來很正常的網域反而被擋。它回 403 時還附了一個 x-exception-info: deny code 68 的標頭。維基共享資源完全不擋。我自己的部落格也完全沒開,這點後面再講。
補洞一:Sec-Fetch-Site,瀏覽器另外蓋的「跨站」章
回頭看那兩行繞過成功的 log,nginx 其實還記了別的欄位,完整一點是這樣:
"GET /cat.jpg" status=200 referer="-" sec_fetch_site="cross-site" sec_fetch_dest="image"Referer 沒了,但 Chrome 另外附了兩個 header,老實交代:這是一個跨站(cross-site)的請求,要的是一張圖(image)。
這組 header 叫 Fetch Metadata,一共三個。表格裡的值都是我這次實測記到的:
| header | 意思 | 盜連(有沒有 no-referrer 都一樣) | 直接在網址列開圖 |
|---|---|---|---|
Sec-Fetch-Site | 發起請求的頁面跟目標是什麼關係 | cross-site | none |
Sec-Fetch-Mode | 請求的模式 | no-cors | navigate |
Sec-Fetch-Dest | 拿回去要當什麼用 | image | document |
它跟 Referer 有兩個關鍵差別。
第一,網頁關不掉它。referrerpolicy 只管 Referer,管不到這組 header。Fetch Metadata 規格算 Sec-Fetch-Site 的時候,只比對「發起請求的來源」跟「目標網址」是不是同一個網站,跟 Referrer Policy 完全無關。
它對「同一個網站」的定義也比 Referrer Policy 寬。前面那個只差一個 port 的 8083 頁面,Referer 被當成外人剪掉路徑,Sec-Fetch-Site 卻是 same-site。所以圖放在 img.example.com、文章在 www.example.com,自己的頁面不會被當成跨站。
第二,網頁也改不了它。Sec- 開頭的 header 名稱是特地保留下來的,MDN 的說法是:為了讓新的 header 不會被 fetch() 這類「允許開發者控制 header」的 API 碰到。
所以可以在 nginx 多加一道關:Referer 過關了,但瀏覽器說這是「跨站的圖片請求」,一樣擋。
map "$http_sec_fetch_site:$http_sec_fetch_dest" $cross_site_image {
    default            0;
    "cross-site:image" 1;
}

server {
    # …valid_referers 照舊

    location / {
        if ($invalid_referer)  { return 403; }
        if ($cross_site_image) { return 403; }
    }
}
重跑一輪:
| 情境 | 只有 Referer 白名單 | 再加 Sec-Fetch-Site |
|---|---|---|
| 圖床自己的頁面 | 200 | 200 |
| 別的網站直接盜連 | 403 | 403 |
| 盜連網站在圖片標籤加 no-referrer 屬性 | 200(繞過) | 403 |
| 盜連網站在頁面放 no-referrer 的 meta 標籤 | 200(繞過) | 403 |
| 直接在網址列開圖 | 200 | 200 |
直接開圖還是過得了,因為那時的 Sec-Fetch-Dest 是 document 不是 image。這條規則只命中「被別的網頁當成圖片嵌進去」這一種情況。
把兩道關畫在一起:
flowchart TD
    REQ["有人來要 cat.jpg"] --> Q1{"Referer 是空的,<br/>或是自己的網域?"}
    Q1 -- "不是" --> NO1["403<br/>別的網站直接盜連"]
    Q1 -- "是" --> Q2{"Sec-Fetch-Site 是 cross-site<br/>而且 Dest 是 image?"}
    Q2 -- "是" --> NO2["403<br/>盜連網站加了 no-referrer"]
    Q2 -- "不是,或根本沒送" --> OK["200 放行<br/>自己的頁面、直接開圖<br/>也包括什麼都不送的 curl"]
最下面那個方塊,就是這道補丁的極限。
Sec-Fetch-* 只有瀏覽器會送,而且只送給 HTTPS 或本機(localhost、127.0.0.1)的網址。curl 跟爬蟲根本不帶,規則只能「沒送就放行」,否則所有非瀏覽器的正常用途都會被誤殺。我用什麼 header 都不帶的 curl 去打這台兩道關的 nginx,直接 200。舊瀏覽器也一樣:Firefox 90(2021 年 7 月)才開始送,Safari 要等到 2023 年 3 月的 16.4 版,更舊的版本加上 no-referrer 照樣能過。
還有一件事:Google 在 web.dev 介紹這組 header 的文章,是把它當成防 CSRF、XS-Leaks 這類攻擊的工具,而且明講圖片這類公開、不需要登入的資源,可以直接豁免在規則之外。
換句話說,拿它補防盜連的洞是我自己的延伸用法。我沒找到哪家 CDN 把它包裝成防盜連功能,不過 Cloudflare WAF 的自訂規則讀得到任何 request header,包括 sec-fetch-site,要自己寫是寫得出來的。
補洞二:CORP,叫瀏覽器自己不准顯示
另一條路完全不用伺服器判斷,只要在圖片的回應裡多加一個 header:
add_header Cross-Origin-Resource-Policy same-site always;意思是「這張圖只給同一個網站的頁面用」。擋的人不是伺服器,是讀者的瀏覽器。
我拿盜連網站去載一張有這個 header 的圖。nginx 那邊一切正常,287 bytes 的小圖整張送了出去:
"GET /corp/cat.jpg" status=200 bytes_sent=287 referer="http://localhost:8082/"盜連網站上的圖卻是破的,Chrome 的 console 寫著:
Failed to load resource: net::ERR_BLOCKED_BY_RESPONSE.NotSameSiteCORP 是 2018 年 Spectre、Meltdown 這兩個 CPU 漏洞曝光之後才發展出來的,用途是讓網站直接擋掉別人用 <img>、<script> 這類標籤,把自己的資源拉進別的頁面。拿來防盜連剛好對得上。
它的好處是簡單:伺服器不用判斷任何東西,每張圖都回一樣的 header,放在 CDN 上快取也沒問題。代價寫在 MDN 裡:
As this policy is expressed via a response header, the actual request is not prevented—rather, the browser prevents the result from being leaked by stripping the response body.
意思是:請求照樣發生,瀏覽器只是把拿到的內容丟掉,不交給頁面。
那流量到底花掉了沒有?我做了一個 10 MB 的測試檔(前面是一張真的小 JPEG,後面接 10 MB 隨機資料),讓盜連網站載六次,看 nginx 每次實際送出多少:
| 第幾次 | nginx 限速 | 開頁到請求失敗 | 已經送出 |
|---|---|---|---|
| 1 | 每秒 256 KB | 22 毫秒 | 64 KB(0.63%) |
| 2 | 每秒 256 KB | 沒記到 | 256 KB(2.5%) |
| 3 | 每秒 256 KB | 81 毫秒 | 64 KB(0.63%) |
| 4 | 不限速 | 61 毫秒 | 256 KB(2.5%) |
| 5 | 不限速 | 24 毫秒 | 512 KB(5%) |
| 6 | 不限速 | 14 毫秒 | 640 KB(6.25%) |
從打開盜連頁面算起,最快 14 毫秒、最慢 81 毫秒,請求就被 Chrome 判定失敗,六次都沒讓 10 MB 送完。第 2 次是我的測試腳本漏接了失敗事件,但 Chrome 一樣記下了 NotSameSite,nginx 也只送出 256 KB。
所以 CORP 在大檔案上確實省下大部分流量,但省不到零:瀏覽器得先收到回應才知道要擋,喊停之前送出去的就是你的。我在本機測到的是 64 KB 到 640 KB,換到真實網路,數字會跟著延遲跟連線狀況變,但道理一樣。圖如果比這還小,就可能在喊停前整張送完,那張 287 bytes 的小圖就是這樣。這種情況下,CORP 擋掉的只是「別人顯示你的圖」,不是你的流量。
跟 Sec-Fetch-Site 一樣,CORP 只管瀏覽器。curl 不看這個 header,照樣拿到整張圖。
最硬的一招:簽名網址,網址自己會過期
前面三招都在問瀏覽器:「你從哪裡來?」對方不是瀏覽器,或者瀏覽器不肯說,就問不出來。
簽名網址換了一個問法:「你的通行證呢?」
做法是讓網站跟圖床共享一把密鑰。網站產生圖片網址時,把「路徑+到期時間+密鑰」算成一個雜湊值,一起放進網址;圖床收到請求時用同一把密鑰重算一次,算出來一樣、而且還沒過期,才給圖。
nginx 內建的 secure_link 模組就能做:
location /private/ {
    secure_link $arg_md5,$arg_expires;
    secure_link_md5 "$secure_link_expires$uri hotlinklabsecret";

    if ($secure_link = "")  { return 403; }  # 雜湊對不上
    if ($secure_link = "0") { return 410; }  # 雜湊對,但過期了
}
hotlinklabsecret 就是那把密鑰,只有網站跟圖床知道。網址這樣產生:
expires=$(( $(date +%s) + 3600 ))   # 一小時後過期
printf '%s' "${expires}/private/cat.jpg hotlinklabsecret" \
  | openssl md5 -binary | openssl base64 | tr '+/' '-_' | tr -d '='
我產了一個一小時後過期的網址,再故意動手腳:
| 測試 | 網址怎麼動 | 結果 |
|---|---|---|
| 1 | 原封不動 | 200 |
| 2 | 簽名不動,路徑從 cat.jpg 改成 other.jpg | 403 |
| 3 | 用過去的時間,正確簽一個 | 410 |
| 4 | 簽名不動,把 expires 參數往後改 | 403 |
| 5 | 拿掉簽名參數 | 403 |
第 4 個是重點:到期時間也在簽名的範圍裡,想自己把期限往後延,雜湊就對不上。
sequenceDiagram
    participant S as 你的網站
    participant B as 讀者的瀏覽器
    participant C as 圖床
    S->>B: 頁面裡的圖片網址<br/>cat.jpg?md5=…&expires=…
    B->>C: GET 這個網址
    C->>C: 用同一把密鑰重算雜湊<br/>對得上、也還沒過期
    C-->>B: 200 圖片
    Note over B,C: 網址被抄去別的地方<br/>過期前照樣能用,過期後 410<br/>改一個字就 403
這是前面幾招都做不到的:驗證完全在伺服器端,不管對方是不是瀏覽器、肯不肯說自己從哪裡來。curl 拿不到有效的網址,一樣進不來。
代價有三個:
- 網址得由伺服器現場產生,純靜態的網站很難做。
- 有效期間內,拿到網址的人一樣能用。它是限時通行證,不是身分證。CloudFront 的進階用法可以再限定 IP 範圍。
- nginx 內建的只有 MD5 版本,拿來示範原理夠用。雲端服務用的是更正式的做法,例如 Google Cloud CDN 用 HMAC-SHA1,CloudFront 要求用 RSA 2048 或 ECDSA 256 的私鑰簽名。
你很可能每天都在用簽名網址,只是沒注意過。Discord 在 2023 年 11 月宣布替附件網址加上 ex、is、hm 三個參數。照 Discord 開發者文件的說明,它們分別是到期時間、簽發時間,跟一個到期前都有效的簽章。貼到 Discord 以外的連結,24 小時後就失效。Discord 的目的不是防盜連,是不讓人把它的 CDN 當成散布惡意程式的免費空間,但原理相同:網址帶著到期時間跟簽章,過期就失效。
主流 CDN 的防盜連選單
| 服務 | Referer 規則 | 簽名網址 |
|---|---|---|
| Cloudflare | Hotlink Protection 開關,空 Referer 放行;也能自己寫 WAF 規則 | WAF 規則裡的 is_timed_hmac_valid_v0 函式(Pro 以上方案),或用 Workers 自己驗 HMAC |
| Bunny CDN | Hotlink protection 白名單;要另外打開 Block Direct URL File Access 才會擋空 Referer | Token Authentication |
| AWS CloudFront | 沒有一鍵開關,官方教你搭配 AWS WAF 比對 Referer | Signed URL、Signed cookie |
| 阿里雲 CDN | Referer 防盜鏈,白名單、黑名單都有 | URL 鑑權,有 Type A、Type B 等幾種網址格式 |
| 騰訊雲 CDN | Referer 防盜鏈,可選「允許」或「拒絕」空 Referer | URL 鑑權 TypeA 到 TypeD |
| 自己架 nginx | valid_referers | secure_link |
幾個細節:
- Cloudflare 的 Hotlink Protection 只認五種副檔名:
gif、ico、jpg、jpeg、png,沒有 webp,也沒有 avif。想讓某些圖可以被外站引用,把它們放進任何一個叫hotlink-ok的資料夾就行。 - 阿里雲的做法跟 Cloudflare 相反:放行空 Referer 的選項預設沒勾。那個選項的名稱寫的是「允许通过浏览器地址栏直接访问资源URL」,等於把「沒有 Referer 的都是誰」直接寫在選項上。
- 檢查要放在 CDN 的邊緣,不要放在源站。
第三點值得多講一句。CDN 會把圖存在邊緣節點,後面的請求多半在邊緣就被打發掉,根本不會回到源站。我在拆 CDN 那篇用 nginx 架過一台迷你 CDN,100 個同時進來的請求,只有 1 個真的打到源站。AWS 的官方部落格也講得很直白:
If you’re using a CDN such as CloudFront to speed up your site’s delivery of content, validating the Referer header at the web server becomes less practical.
— AWS Security Blog,How to prevent hotlinking by using AWS WAF, Amazon CloudFront, and referer checking
意思是:用了 CDN,源站那邊再怎麼檢查 Referer,都擋不到快取裡那一份。前面在 nginx 上做的每一道關都一樣,真的上線要搬到 CDN 的規則裡做。
怎麼選:先想清楚你要防的是誰
flowchart TD
    START["想保護網站上的圖"] --> Q1{"是付費或私密內容?"}
    Q1 -- "是" --> SIGN["簽名網址+短效期<br/>伺服器端驗證<br/>curl 也擋得住"]
    Q1 -- "不是" --> Q2{"怕的是別的網站<br/>嵌圖吃流量?"}
    Q2 -- "是" --> REF["Referer 白名單<br/>放行空 Referer"]
    Q2 -- "不是,怕被整批抓走" --> BOT["限流、Bot 管理<br/>header 檢查全都沒用"]
    REF --> Q3{"連 no-referrer<br/>也要擋?"}
    Q3 -- "要,而且想省流量" --> SFS["伺服器檢查<br/>Sec-Fetch-Site"]
    Q3 -- "要,別人顯示不出來就好" --> CORP["回應加上<br/>CORP: same-site"]
大多數個人網站停在「Referer 白名單、放行空 Referer」就夠了,這也是 Cloudflare 那個開關的預設行為。會被 no-referrer 繞過的,通常是刻意要用你的圖的人,這時要不要再往下加,看你在乎的是流量還是版權。
3 分鐘自己動手
三行 curl,看一個網站有沒有防盜連
IMG='貼上你想測的圖片網址'
curl -s -o /dev/null -w '%{http_code}\n' "$IMG"
curl -s -o /dev/null -w '%{http_code}\n' -e 'https://它自己的網域/' "$IMG"
curl -s -o /dev/null -w '%{http_code}\n' -e 'https://example.com/' "$IMG"
三個數字依序是:沒帶 Referer、帶它自家網域、帶別人的網域。我拿一張 Pixiv 作品的原圖來測,是 403、200、403;換成微博的圖是 200、200、403。第一個數字就是它對「沒填 Referer」的態度。
20 行設定,在自己電腦重演一次盜連
開一個資料夾,放三樣東西:
hotlink-lab/
├── default.conf       # nginx 設定
├── html/cat.jpg       # 隨便一張圖
└── thief/index.html # 盜連網站default.conf,也就是前面兩道關合在一起,再加上一個會印出 Referer 跟 Fetch Metadata 的 log 格式:
log_format hotlink '"$request" $status referer="$http_referer" '
                   'site="$http_sec_fetch_site" dest="$http_sec_fetch_dest"';

map "$http_sec_fetch_site:$http_sec_fetch_dest" $cross_site_image {
    default            0;
    "cross-site:image" 1;
}

server {
    listen 80;
    server_name 127.0.0.1;
    root /usr/share/nginx/html;
    access_log /dev/stdout hotlink;
    add_header Cache-Control no-store;

    valid_referers none blocked server_names;

    location / {
        if ($invalid_referer)  { return 403; }  # 第一道:Referer 有填,而且不是自己的網域
        if ($cross_site_image) { return 403; }  # 第二道:沒填 Referer,但瀏覽器說這是跨站的圖
    }
}thief/index.html,網址後面的 ?1、?2 是為了讓兩張圖各自發一次請求:
<!doctype html>
<meta charset="utf-8">
<p>直接盜連:<img src="http://127.0.0.1:8081/cat.jpg?1" width="160"></p>
<p>加上 no-referrer:<img src="http://127.0.0.1:8081/cat.jpg?2" width="160" referrerpolicy="no-referrer"></p>
在 hotlink-lab/ 底下開兩個終端機:
# 終端機 1:圖床
docker run --rm -p 8081:80 \
  -v "$PWD/default.conf:/etc/nginx/conf.d/default.conf:ro" \
  -v "$PWD/html:/usr/share/nginx/html:ro" \
  nginx:stable

# 終端機 2:盜連網站
python3 -m http.server 8082 --directory thief
用 Chrome 打開 http://localhost:8082/,兩張圖都是破的,終端機 1 會印出:
"GET /cat.jpg?1 HTTP/1.1" 403 referer="http://localhost:8082/" site="cross-site" dest="image"
"GET /cat.jpg?2 HTTP/1.1" 403 referer="-" site="cross-site" dest="image"
第一張是被 Referer 那關擋下的;第二張沒有 Referer,是被 Sec-Fetch-Site 那關擋下的。
接著在 if ($cross_site_image) 那行前面加一個 #,到終端機 1 按 Ctrl+C、再跑一次同一行 docker run,回到 Chrome 重新整理,第二張圖就出現了:
"GET /cat.jpg?1 HTTP/1.1" 403 referer="http://localhost:8082/" site="cross-site" dest="image"
"GET /cat.jpg?2 HTTP/1.1" 200 referer="-" site="cross-site" dest="image"
這就是 no-referrer 那個洞。最後把 http://127.0.0.1:8081/cat.jpg 直接貼到網址列,會看到一行 site="none" dest="document" 的 200;改用 curl -sI 去打,則是三個欄位全是 - 的 200。
反思:防盜連是在跟讀者的瀏覽器合作
技術面
把整篇拆過的手段排在一起:
| 手段 | 誰來判斷 | 擋得住 | 擋不住 |
|---|---|---|---|
| Referer 白名單 | 伺服器 | 別的網站直接嵌圖 | 加了 no-referrer 的盜連、curl |
| Sec-Fetch-Site | 伺服器 | 加了 no-referrer 的盜連 | 舊瀏覽器、curl |
| CORP | 讀者的瀏覽器 | 別的網站顯示你的圖 | 喊停前已經送出的流量、curl |
| 簽名網址 | 伺服器 | 過期或被竄改的網址,包括 curl 來的 | 有效期間內拿到網址的人 |
如果只能帶走一句話:Referer 防的從來不是「偽造」,是「嵌入」。它有效,是因為填這一欄的是讀者的瀏覽器。
心態面
前三招有一個共同前提:讀者的瀏覽器會說實話。這個前提其實很穩,因為瀏覽器不是盜連網站的,是讀者的;寫規格的人也站在「不讓網頁冒充別人」這一邊。防盜連與其說是跟盜連的人鬥智,不如說是跟讀者的瀏覽器合作。
真的不能靠瀏覽器配合的場合,例如付費內容,就別再問「你從哪裡來」,改問「你的通行證呢」。
有趣發現
- 微博圖床不帶 Referer 反而過,帶了別人的網域才擋;Pixiv 剛好相反,沒帶 Referer 直接 403。
- 我自己的部落格完全沒開防盜連。就算打開 Cloudflare 那個開關也沒用:它只認 gif、ico、jpg、jpeg、png,而我抽查首頁跟一篇文章頁,上面的圖全部是 Astro 轉出來的 webp。
- Apache 官方文件的防盜連範例,除了直接回 403,還有一個版本是把盜連的圖換成
/images/go-away.png。2.2 版的文件甚至說,換圖或導走比直接擋更有效,因為對方看不到他想要的那張圖。 - 第一次寫
valid_referers時,我在server_names後面又補了一次127.0.0.1,nginx 直接拒絕啟動:conflicting parameter "127.0.0.1"。server_names已經包含server_name裡的網域,重複寫反而是錯的。
說到底,防盜連能成立,靠的不是伺服器有多聰明,而是讀者的瀏覽器不肯替別人說謊。