MySQL 為什麼要設 utf8mb4_unicode_ci?utf8mb4 是必須,unicode_ci 卻會讓壽司等於啤酒
先講答案
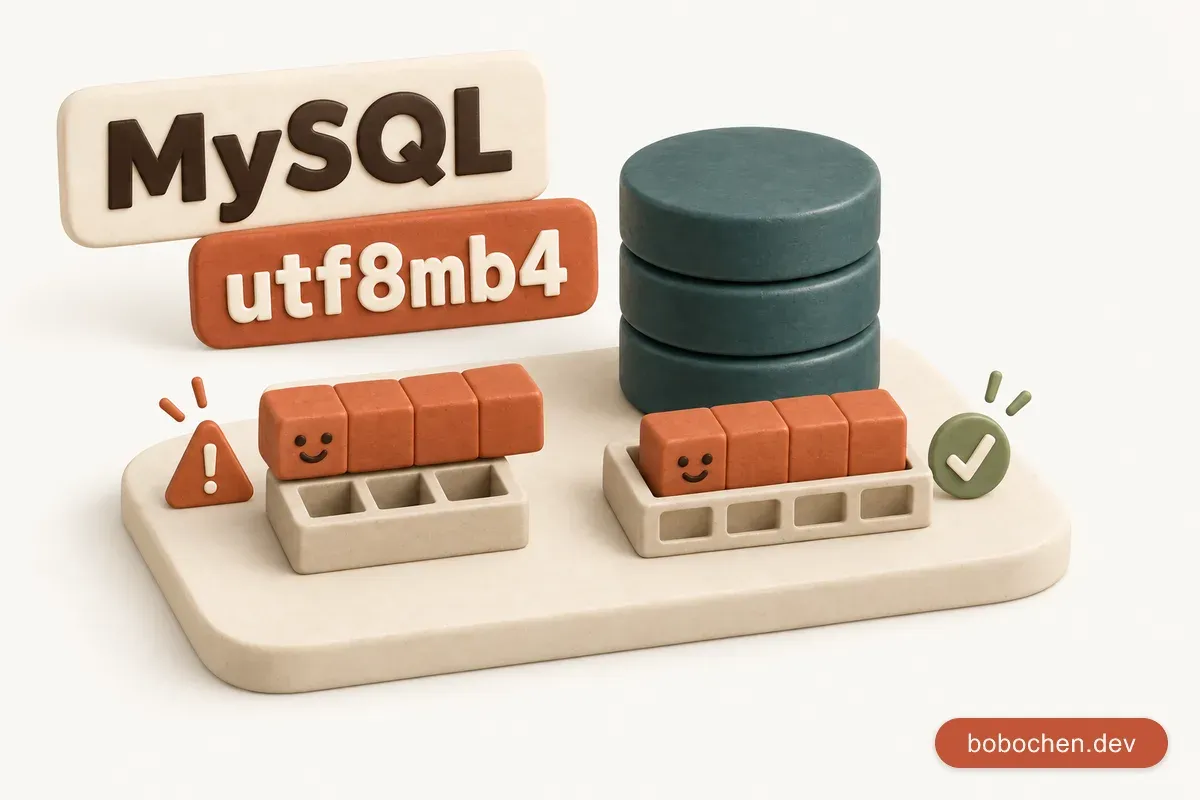
「MySQL 要設 utf8mb4 + utf8mb4_unicode_ci」這句建議很常見。前半句完全正確,後半句只對一半,因為這句話背後藏著兩個常見的誤會。
誤會一:MySQL 的 utf8 就是 UTF-8
不是。MySQL 的 utf8 是 utf8mb3 的別名,每個字元最多只存 3 bytes,只涵蓋 Unicode 的基本多文種平面(BMP)。
原因要追到 2002 年:MySQL 原本照當時的規格實作了最長 6 bytes 的版本,還沒發布就用一個 commit 把上限改成 3 bytes,從此 utf8 就一直是殘缺版。大部分 emoji 和擴充區漢字(例如 𠮷)都要 4 bytes,放不進 utf8mb3:strict 模式下整筆 INSERT 會失敗,非 strict 模式下那個字會被靜靜換成 ?。
完整的 UTF-8 在 MySQL 裡叫 utf8mb4。
誤會二:utf8mb4_unicode_ci 是最正確的 collation
也不是。它會這麼普遍,是因為它比舊的 utf8mb4_general_ci 正確(例如 ß 等於 ss、全形 A 等於 A),MySQL 5.7、8.x 和 MariaDB 都認得,Laravel 也拿它當預設值。
但它有一個大坑:MySQL 實作它的時候,把所有補充平面的字元給了同一個權重,結果所有 emoji 和擴充區漢字都被當成同一個字。😀 等於 🐶,兩個不同的擴充區漢字也相等,放進 UNIQUE 欄位就會撞在一起。
正確答案
- 字元集:一律
utf8mb4,伺服器、資料庫、資料表、欄位、連線五層都要是。 - collation:只跑 MySQL 8.0 以上,用
utf8mb4_0900_ai_ci(MySQL 8 的預設值);要相容 MySQL 5.7 或 MariaDB,用utf8mb4_unicode_520_ci。 - 沿用
utf8mb4_unicode_ci也可以(例如 Laravel 的預設),但要知道 emoji 和擴充區漢字會互撞。 - 不管選哪個 collation,整個資料庫要統一,混用會碰到
Illegal mix of collations。
下面用實驗一項一項說明。文中的結果都是用 Docker 跑 MySQL 5.7.44、8.4.11 和 MariaDB 11.4.13 實測的,想自己重現只要一行:
docker run -d --name lab84 -e MYSQL_ROOT_PASSWORD=lab mysql:8.4一個 emoji,讓整筆 INSERT 失敗
先看一段在 MySQL 8.4 上實際跑出來的結果。欄位宣告成 utf8mb3(也就是很多舊專案裡寫的 utf8),塞一句中間夾了 emoji 的字串:
CREATE TABLE t3 (s VARCHAR(50) CHARACTER SET utf8mb3);
INSERT INTO t3 VALUES ('你好😀世界');
ERROR 1366 (HY000): Incorrect string value: '\xF0\x9F\x98\x80\xE4\xB8...' for column 's' at row 1\xF0\x9F\x98\x80 就是 😀 的 UTF-8 編碼,一共 4 個 bytes。前面的「你」「好」各 3 bytes,都沒事,偏偏卡在這個 4 bytes 的字上。
欄位明明寫著 UTF-8(utf8mb3 就是舊專案裡的 utf8),卻存不了 UTF-8 的字,這就是誤會一的實際樣子。
MySQL 的 utf8 只收到 3 bytes
UTF-8 是變長編碼,一個字元用 1 到 4 個 bytes 表示。現行規格 RFC 3629 的分段是這樣:
| Code point 範圍 | UTF-8 長度 | 例子 |
|---|---|---|
| U+0000 – U+007F | 1 byte | A、1 |
| U+0080 – U+07FF | 2 bytes | é、ß |
| U+0800 – U+FFFF | 3 bytes | 你、❤ |
| U+10000 – U+10FFFF | 4 bytes | 😀、𠮷 |
前三列加起來就是 Unicode 的基本多文種平面(Basic Multilingual Plane,BMP),也就是 Plane 0。第四列是 BMP 以外的補充平面,大部分 emoji 和一大批罕用漢字都在那裡。
MySQL 的 utf8mb3 只做到第三列。官方手冊的描述是:
Requires a maximum of three bytes per multibyte character. Supports BMP characters only (no support for supplementary characters)
名字裡的 mb3 就是「每個字元最多 3 bytes」。對照組 utf8mb4 最多 4 bytes,這才是完整的 UTF-8。至於 utf8 這個名字,在 MySQL 8.4 裡只是 utf8mb3 的別名。建一張表就看得出來:
CREATE TABLE t_alias (s VARCHAR(20) CHARACTER SET utf8);
SHOW WARNINGS;
Warning | 3719 | 'utf8' is currently an alias for the character set UTF8MB3, but will be an alias for UTF8MB4 in a future release. Please consider using UTF8MB4 in order to be unambiguous.SHOW CREATE TABLE 也不再顯示 utf8,直接寫出本名:
`s` varchar(20) CHARACTER SET utf8mb3 COLLATE utf8mb3_general_ci DEFAULT NULL這個別名要改成什麼,已經喊了好幾年。8.4 的警告說「未來會變成 utf8mb4 的別名」;到了 MySQL 9.7 的手冊,utf8 代表什麼改由一個新的 SQL mode INTERPRET_UTF8_AS_UTF8MB4 決定,預設沒開,所以仍然是 utf8mb3。官方的建議很直接:
To avoid behavior that depends on the SQL mode, it is recommended to specify utf8mb3 or utf8mb4 explicitly.
所以不要再寫 utf8,明確寫 utf8mb4。
一個字元寫進 utf8mb3 欄位時會發生什麼事,可以畫成這樣:
flowchart TD
    A["要寫入的字元"] --> B{"code point 在<br/>U+FFFF 以內?"}
    B -->|"是,在 BMP"| C["1~3 bytes<br/>utf8mb3 存得下"]
    B -->|"否,在補充平面"| D["需要 4 bytes<br/>utf8mb3 放不下"]
    D --> E{"sql_mode<br/>有 strict?"}
    E -->|"有"| F["ERROR 1366<br/>整筆 INSERT 失敗"]
    E -->|"沒有"| G["Warning 1366<br/>該字被換成問號<br/>原資料永久遺失"]
右下角那條路徑後面會再回來講,它比報錯可怕得多。
哪些字存不進去:不只 emoji
emoji:大部分不行,少數可以
有一部分符號本來就在 BMP 裡。把 ❤☀☺ 塞進 utf8mb3 欄位,完全沒有錯誤:
| s | HEX(s) |
|---|---|
| ❤☀☺ | E29DA4E29880E298BA |
三個字元分別是 U+2764、U+2600、U+263A,各 3 bytes。但 😀(U+1F600)這類表情符號都在 Plane 1,一律 4 bytes。這也是為什麼有些系統「明明存過愛心」,換成笑臉就出事。
另外,看起來是「一個」emoji 的東西,在資料庫眼中可能是好幾個字元。👨👩👧 是三個人物 emoji 用兩個零寬連接符(ZWJ,U+200D)黏起來的;👍🏽 是大拇指加上一個膚色修飾符。放進 utf8mb4 欄位量一下:
| s | LENGTH(bytes) | CHAR_LENGTH(字元) |
|---|---|---|
| 你好😀世界 | 16 | 5 |
| 𠮷野家 | 10 | 3 |
| 👨👩👧 | 18 | 5 |
| 👍🏽 | 8 | 2 |
家庭 emoji 佔 5 個字元、18 bytes,所以 VARCHAR(3) 的欄位連一個家庭 emoji 都放不下:
ERROR 1406 (22001): Data too long for column 's' at row 1這跟 utf8mb4 本身無關,但替暱稱、狀態這類欄位設長度時要記得:VARCHAR(n) 的 n 算的是 code point,不是使用者眼中的「一個字」。
中文:常用字沒事,擴充區的字會出事
常用漢字都在 BMP 裡,3 bytes,utf8mb3 存得下。但 Unicode 3.1(2001 年)第一次在 BMP 以外收字,一口氣在 Plane 2 放進 42,711 個「擴充 B 區」漢字,後來的擴充 C、D、E 等區也都在 BMP 以外。
兩個查得到出處的例子:
- 𠮷(U+20BB7):「吉」的異體字,上半部是「土」不是「士」。Unicode 的 Unihan 資料庫把它標為
kSpoofingVariant: U+5409 吉,也就是外觀容易跟「吉」混淆的字。它常被拿來當 4 bytes 字元的測試案例,據說日本吉野家招牌上的就是這個字(這個說法流傳很廣,但我沒找到吉野家官方的出處)。 - 𨋢(U+282E2):粵語的「電梯」,Unihan 的定義是
(Cant.) an elevator (from the British 'lift'),讀音 lip1。
WordPress 4.2 在 2015 年開始把網站升級到 utf8mb4,官方公告特別提到漢字:
utf8 can only store characters in the Basic Multilingual Plane, while utf8mb4 can store any Unicode character. This greatly expands the language usability of WordPress, especially in countries that use Han character sets.
對中文系統來說,這代表人名、地名只要用到擴充區的字,在 utf8mb3 上就存不進去。
比報錯更糟的是不報錯
開頭那個 ERROR 1366 是在 strict 模式下發生的。MySQL 8.4 預設的 sql_mode 有 STRICT_TRANS_TABLES:
ONLY_FULL_GROUP_BY,STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_ENGINE_SUBSTITUTION如果把 sql_mode 清空,同一句 INSERT 會「成功」:
SET SESSION sql_mode = '';
INSERT INTO t4a VALUES ('你好😀世界');
-- Query OK, 1 row affected, 1 warning
但存進去的東西長這樣:
| s | HEX(s) | CHAR_LENGTH(s) |
|---|---|---|
| 你好?世界 | E4BDA0E5A5BD3FE4B896E7958C | 5 |
中間那個 3F 是 ASCII 的問號。emoji 被換成 ?,只留下一個 warning;𠮷野家 同樣變成 ?野家。MySQL 5.7.44 和 8.4.11 的行為一模一樣。
應用程式收到的是「寫入成功」,原始資料卻已經不見了,事後沒有任何辦法還原。報錯至少會讓你當下發現;這種情況可能要等到使用者抱怨,才有人發現資料庫裡多了一堆問號。
考古:MySQL 為什麼只給 3 bytes
UTF-8 規格一開始就不只 3 bytes。1998 年的 RFC 2279 允許最長 6 bytes:
In UTF-8, characters are encoded using sequences of 1 to 6 octets.
MySQL 一開始也是照這份規格做的。GitHub 上的 mysql-server repo 保留了完整歷史:2002 年 3 月 28 日有一個標題為「New UTF8 charset」的 commit,而半年後的 2002 年 9 月 27 日,有另一個 commit 只改了一個數字:
Subject: [PATCH] UTF8 now works with up to 3 byte sequences only

-    6,			/* mbmaxlen     */
+    3,			/* mbmaxlen     */
mbmaxlen 是「每個字元最多幾個 bytes」,從 6 改成 3,commit 訊息就這一句。
把時間點排在一起看:
| 時間 | 事件 |
|---|---|
| 1992 年 9 月 | Ken Thompson 與 Rob Pike 設計出 UTF-8 |
| 1998 年 1 月 | RFC 2279:UTF-8 最長 6 bytes |
| 2001 年 | Unicode 3.1 第一次在 BMP 以外收字,包含 42,711 個擴充 B 區漢字 |
| 2002 年 3 月 | MySQL 加入 UTF-8 支援,最長 6 bytes |
| 2002 年 9 月 | MySQL 把 utf8 的上限改成 3 bytes |
| 2003 年 | MySQL 4.1.0 alpha 發布,utf8 第一次公開,已經是 3 bytes 版本 |
| 2003 年 11 月 | RFC 3629:UTF-8 改成最長 4 bytes,範圍到 U+10FFFF 為止 |
| 2010 年 3 月 | MySQL 5.5.3 加入 utf8mb4 |
| 2015 年 4 月 | WordPress 4.2 為了支援 emoji,開始把網站升級到 utf8mb4 |
| 2017 年 4 月 | MySQL 8.0.1 把預設字元集從 latin1 改成 utf8mb4 |
| 2022 年 7 月 | MySQL 8.0.30 把 utf8_xxx collation 全部改名為 utf8mb3_xxx |
MySQL 決定只收 3 bytes 的時候,BMP 以外已經有四萬多個漢字;而且它比一年後才定案的 4 bytes 規格還少收了一個 byte。所以這不是「照舊規格做、後來規格變了」的故事,是 MySQL 自己選擇只做一部分。
為什麼要改成 3?commit 沒寫。Adam Hooper 在 2016 年寫過一篇流傳很廣的〈In MySQL, never use “utf8”. Use “utf8mb4”.〉,他也翻過這段歷史,結論是:
Who asked for this change? Why? I can’t tell.
他的猜測跟 CHAR 欄位有關。當年 MySQL 的資料表如果每一列都是固定長度,查詢會比較快,所以有人會把文字欄位宣告成 CHAR。固定長度就得替每個字元預留「最長可能」的空間,每字 6 bytes 的話,CHAR(1) 要 6 bytes、CHAR(2) 要 12 bytes。砍到 3 bytes,空間就省下一半。他還特別指出,那個正確的 6 bytes 版本「was never released」,使用者從頭到尾只拿到 3 bytes 版本。
不過這只是他的推測,文中也明說是猜的;我沒有找到任何 MySQL 開發者對這個決定的第一手說明。
utf8mb4 才是完整的 UTF-8
utf8mb4 在 MySQL 5.5.3(2010 年)加入,完整支援 1 到 4 bytes。很多人擔心換過去會讓資料變大,官方手冊寫得很清楚:
For a BMP character, utf8mb4 and utf8mb3 have identical storage characteristics: same code values, same encoding, same length.
一般的中文、英文在兩種字元集裡儲存方式完全相同,只有 4 bytes 的字元才會用到第 4 個 byte。從 utf8mb3 換到 utf8mb4,既有資料一個 byte 都不會變。
MySQL 8.0.1 起,伺服器預設就是 utf8mb4:
The default value of the character_set_server and character_set_database system variables has changed from latin1 to utf8mb4.
實測 5.7.44 的 Docker image,character_set_server 還是 latin1;8.4.11 已經是 utf8mb4。
唯一的代價:索引長度與 Laravel 的 191
真正會咬人的是索引。InnoDB 的索引鍵長度有上限,舊的 COMPACT、REDUNDANT row format 是 767 bytes。MySQL 計算時用的是最壞情況,VARCHAR(255) 在 utf8mb4 下就是 255 × 4 = 1020 bytes,超過了:
-- MySQL 5.7.44
CREATE TABLE t_idx (name VARCHAR(255) CHARACTER SET utf8mb4, KEY(name)) ROW_FORMAT=COMPACT;
ERROR 1071 (42000): Specified key was too long; max key length is 767 bytes767 ÷ 4 = 191.75,所以 VARCHAR(191) 剛好放得下,實測也能建立。Laravel 5.3 的預設還是 utf8 搭 utf8_unicode_ci,5.4 改成 utf8mb4,文件裡那行神祕的 191 就是這樣來的:
Laravel uses the utf8mb4 character set by default, which includes support for storing “emojis” in the database. If you are running a version of MySQL older than the 5.7.7 release or MariaDB older than the 10.2.2 release, you may need to manually configure the default string length generated by migrations in order for MySQL to create indexes for them.
Schema::defaultStringLength(191);現在這個問題基本上已經消失。DYNAMIC row format 的上限是 3072 bytes,而它在 5.7 和 8.4 都是預設值(實測兩邊的 innodb_default_row_format 都是 dynamic)。同樣的 VARCHAR(255) 改用 ROW_FORMAT=DYNAMIC 就能建立索引;在 8.4 上要到 VARCHAR(769) 才會撞到新上限:
ERROR 1071 (42000): Specified key was too long; max key length is 3072 bytes如果你的 AppServiceProvider 裡還留著 defaultStringLength(191),資料庫版本也夠新,確認既有資料表都是 DYNAMIC 之後,那行就可以拿掉了。已經建好的欄位不會因此變長,只影響之後的 migration。
collation:字存進去之後怎麼比
字元集(character set)決定能存哪些字、怎麼編碼;collation 決定兩個字串怎麼比較、怎麼排序。WHERE name = ?、ORDER BY、GROUP BY、UNIQUE 索引,全部都看 collation。
MySQL 的 collation 名稱可以拆開讀。以 utf8mb4_0900_ai_ci 為例:
| 片段 | 意思 |
|---|---|
utf8mb4 | 字元集 |
0900 | 依據 Unicode Collation Algorithm(UCA)9.0.0 |
ai | accent-insensitive,不分重音,é 等於 e |
ci | case-insensitive,不分大小寫,a 等於 A |
其他常見的後綴還有 as(分重音)、cs(分大小寫)、ks(分平假名片假名)、bin(直接比 code point)。名稱裡沒有版本號的 utf8mb4_unicode_ci 用的是 UCA 4.0.0,utf8mb4_unicode_520_ci 是 UCA 5.2.0;utf8mb4_general_ci 則不是照 UCA 實作,是 MySQL 自己的簡化規則。
用同一組字串去比,差異很明顯(MySQL 8.4.11 實測,= 代表比較結果相等):
| 比較 | general_ci | unicode_ci | unicode_520_ci | 0900_ai_ci | bin |
|---|---|---|---|---|---|
😀 與 🐶 | = | = | ≠ | ≠ | ≠ |
𠮷 與 𡃁 | = | = | ≠ | ≠ | ≠ |
a 與 A | = | = | = | = | ≠ |
é 與 e | = | = | = | = | ≠ |
ß 與 ss | ≠ | = | = | = | ≠ |
A 與 A(全形) | ≠ | = | = | = | ≠ |
あ 與 ア | ≠ | = | = | = | ≠ |
'a ' 與 'a'(結尾空白) | = | = | = | ≠ | = |
表中的 collation 都省略了 utf8mb4_ 前綴,bin 指的是 utf8mb4_bin。從表裡可以看出三件事:
general_ci最粗糙:ß不等於ss,全形A也不等於A。官方手冊直接稱它是 legacy collation,只能一個字元對一個字元比,不支援展開、縮合這類規則。0900系列會把結尾空白當成有意義的字元,'a '和'a'不相等,官方稱為 NO PAD。其他幾個舊 collation 都是 PAD SPACE,比較時忽略結尾空白,連utf8mb4_bin也是。- 最上面兩列才是重點:在
general_ci和unicode_ci底下,😀 等於 🐶,𠮷 等於 𡃁(另一個擴充 B 區的字,U+210C1)。
壽司等於啤酒:unicode_ci 眼中所有 emoji 都一樣
手冊裡寫得很明白:
For supplementary characters in UCA 4.0.0 collations, their collating weight is 0xfffd. That is, to MySQL, all supplementary characters are equal to each other, and greater than almost all BMP characters.
MySQL 實作 UCA 4.0.0 的 collation 時,把所有補充平面的字元一律給同一個權重 0xfffd,general_ci 也是同樣處理。換句話說,這是 MySQL 實作上的限制,不是 bug。結果就是:所有 emoji、所有擴充區漢字,在比較時全部是「同一個字」。
MySQL 官方部落格甚至寫過一篇文章,標題就叫〈Sushi = Beer ?!〉:
The default collation of utf8mb4 in 5.7 and earlier is utf8mb4_general_ci. This is an quite old collation and it treats all characters in SMP as equal! Therefore we have the reported Sushi = Beer problem.
實際的後果比一個比較運算子嚴重得多。UNIQUE 索引會把不同的 emoji 當成重複:
CREATE TABLE t_u_unicode (
  name VARCHAR(20) CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci,
  UNIQUE KEY (name)
);
INSERT INTO t_u_unicode VALUES ('😀');  -- OK
INSERT INTO t_u_unicode VALUES ('🐶');
ERROR 1062 (23000): Duplicate entry '?' for key 't_u_unicode.name'錯誤訊息裡的 emoji 變成 ? 也有原因:MySQL 組錯誤訊息時用的還是 utf8mb3,手冊寫著「The message template uses UTF-8 (utf8mb3)」。
GROUP BY 也會把它們併成同一組。塞進 🍺、🍣、😀、🐶、apple 五筆資料:
| collation | GROUP BY 結果 |
|---|---|
utf8mb4_unicode_ci | apple 1 筆、🍺 4 筆 |
utf8mb4_0900_ai_ci | 五個值各 1 筆 |
四種不同的 emoji,被算成 4 個 🍺。暱稱欄位加了 UNIQUE、用 emoji 當標籤、統計各種表情符號的使用次數,這些在 unicode_ci 底下都會算錯。中文也一樣,兩個不同的擴充區罕用字,會被當成同一個名字。
那為什麼大家還是寫 utf8mb4_unicode_ci
既然 unicode_ci 有這個坑,為什麼它還是最常見的設定?原因大概有三個。
原因一:它是 5.x 年代比較正確的選擇
當年能選的主要是 general_ci 和 unicode_ci。前者比較快但規則粗糙,後者支援 ß = ss 這類展開規則。MySQL 5.7 的 utf8mb4 預設 collation 是 general_ci(實測 5.7.44 的 collation_connection 就是 utf8mb4_general_ci),想要正確一點的人就會手動改成 unicode_ci。跟 general_ci 比,它確實是比較好的那一個。
原因二:相容性
utf8mb4_0900_ai_ci 是 MySQL 8.0 才有的。把 8.0 以後的 dump 倒進 5.7,會直接失敗:
ERROR 1273 (HY000): Unknown collation: 'utf8mb4_0900_ai_ci'MariaDB 則走自己的路線,它的新版 collation 叫 utf8mb4_uca1400_ai_ci(UCA 14.0.0),實測 11.4.13 的預設值就是這個。舊版 MariaDB 不認得 MySQL 的 0900 系列,比較新的版本已經可以接受,實測 11.4.13 用 utf8mb4_0900_ai_ci 建表可以成功。
unicode_ci 則是 MySQL 5.x、8.x 和 MariaDB 全部都認得的最大公約數。
原因三:框架的預設值
Laravel 的 config/database.php 到今天仍然是:
'charset' => env('DB_CHARSET', 'utf8mb4'),
'collation' => env('DB_COLLATION', 'utf8mb4_unicode_ci'),
Laravel 11 其實試過把預設改成 utf8mb4_0900_ai_ci。Laravel 11 在 2024 年 3 月 12 日發布,兩天後就合併了一個標題為「[11.x] Revert collation change」的 PR #6372,改回 utf8mb4_unicode_ci。
WordPress 則多走了一步。它的 wpdb::determine_charset() 裡有這段,只要伺服器支援,就把 unicode_ci 自動升級成 unicode_520_ci:
// _unicode_520_ is a better collation, we should use that when it's available.
if ( $this->has_cap( 'utf8mb4_520' ) && 'utf8mb4_unicode_ci' === $collate ) {
    $collate = 'utf8mb4_unicode_520_ci';
}對照前面的表,unicode_520_ci 已經能分辨不同的 emoji 和擴充區漢字,而且 MySQL 5.7 和 MariaDB 都有。
比選哪個更重要的是統一
選哪一個是其次,混用才是真正的麻煩。MySQL 8 伺服器的預設是 0900_ai_ci,而 Laravel 的 migration 建表時,會把設定檔裡的 collation 明確寫進 CREATE TABLE。如果同一個資料庫裡,有 Laravel 建的表,也有別的工具照伺服器預設建的表,兩邊的字串欄位一 JOIN 就會:
ERROR 1267 (HY000): Illegal mix of collations (utf8mb4_unicode_ci,IMPLICIT) and (utf8mb4_0900_ai_ci,IMPLICIT) for operation '='拿欄位去跟不同 collation 的變數比較,也是同一個錯誤。
我會怎麼選
flowchart TD
    A["新資料庫要選 collation"] --> B{"框架或既有資料表<br/>已經定了 collation?"}
    B -->|"是"| C["跟著既有設定走<br/>避免 Illegal mix<br/>但要知道它的坑"]
    B -->|"否"| D{"只會跑在<br/>MySQL 8.0 以上?"}
    D -->|"是"| E["utf8mb4_0900_ai_ci"]
    D -->|"否,要相容<br/>5.7 或 MariaDB"| F["utf8mb4_unicode_520_ci"]
具體一點:
- 新專案、確定只跑 MySQL 8.0 以上:
utf8mb4搭utf8mb4_0900_ai_ci。它是 MySQL 8 的預設值,emoji 和擴充區漢字都分得開,Django 的文件也是以它為預設來說明。 - 要相容 MySQL 5.7 或 MariaDB:
utf8mb4_unicode_520_ci,也就是 WordPress 的選擇。 - Laravel 專案:預設的
unicode_ci可以用,重點是整個資料庫一致。如果有會存 emoji 或罕用字、又需要 UNIQUE 的欄位,可以在 migration 裡替那個欄位單獨指定,例如$table->string('nickname')->collation('utf8mb4_0900_ai_ci'),但要記得這個欄位之後跟其他欄位比較時,會碰到上一節的 Illegal mix。 - 需要區分大小寫的欄位(token、hash 之類):用
utf8mb4_bin或utf8mb4_0900_as_cs。注意utf8mb4_bin仍然會忽略結尾空白,見前面表格的最後一列。
連線也要是 utf8mb4
欄位是 utf8mb4 還不夠。客戶端送來的 SQL 是什麼編碼,由連線層的 character_set_client 決定;如果連線還是 utf8mb3,emoji 在進到欄位之前就先被擋下來:
SET NAMES utf8mb3;
INSERT INTO t10 VALUES ('你好😀世界');  -- t10.s 是 utf8mb4
Warning | 1300 | Invalid utf8mb3 character string: 'F09F98'
Error | 1366 | Incorrect string value: '\xF0\x9F\x98\x80\xE4\xB8...' for column 's' at row 1連線如果是 latin1 更糟,不會報錯。伺服器把收到的 UTF-8 bytes 當成 latin1 字元,再轉成 utf8mb4 存進去,結果是經典的亂碼:
| s | HEX(s) | CHAR_LENGTH(s) | LENGTH(s) |
|---|---|---|---|
| ä½ å¥½ | C3A4C2BDC2A0C3A5C2A5C2BD | 6 | 12 |
「你好」原本是 6 bytes,被雙重編碼成 12 bytes、6 個字元。
幾個常見環境的設定方式:
# my.cnf
[mysqld]
character-set-server = utf8mb4
collation-server     = utf8mb4_0900_ai_ci

[client]
default-character-set = utf8mb4- PHP PDO:DSN 加上
charset=utf8mb4,例如mysql:host=localhost;dbname=app;charset=utf8mb4。 - Laravel:
config/database.php的charset就是連線編碼,維持utf8mb4。 - Java(Connector/J):官方文件說
characterEncoding=UTF-8會對應到 utf8mb4:「When UTF-8 is used for characterEncoding in the connection string, it maps to the MySQL character set name utf8mb4.」
設定完用這兩行檢查:
SHOW VARIABLES LIKE 'character_set%';
SHOW VARIABLES LIKE 'collation%';
裡面的 character_set_system 會顯示 utf8mb3,這是正常的。它是伺服器存表名、欄位名這類識別字用的,手冊寫著「The value is always utf8mb3」,不用改,也改不了。
舊資料庫怎麼轉
先找出還在用 3 bytes 版本的欄位(5.7 會顯示成 utf8,較新的 8.0 起顯示成 utf8mb3):
SELECT table_name, column_name, character_set_name, collation_name
FROM information_schema.columns
WHERE table_schema = 'your_db'
  AND character_set_name IN ('utf8', 'utf8mb3');
改資料庫預設值,這只影響之後新建的表:
ALTER DATABASE your_db CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;再逐表轉換:
ALTER TABLE posts CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;轉之前有幾件事要知道:
CONVERT TO會自動把 TEXT 類型升級,確保能存的字元數不變。實測一張有TEXT和TINYTEXT欄位的 utf8mb3 表,轉完變成MEDIUMTEXT和TEXT。不想讓型別被改掉,就得用MODIFY逐欄指定。- 舊表如果還是
COMPACTrow format,VARCHAR(255)上的索引會因為 767 bytes 的限制轉換失敗,要先改成ROW_FORMAT=DYNAMIC。 - 轉換字元集會重建整張表,官方的 Online DDL 對照表寫明這個操作不允許同時寫入。大表要排維護時段,先在 staging 演練一次,並且先備份。
- 連線設定要一起改。欄位轉好了、連線還是 utf8mb3,emoji 照樣存不進去。
結語:一張檢查清單
回到開頭的兩個誤會。
MySQL 的 utf8 不是 UTF-8。它從 2002 年起就是只收 3 bytes 的殘缺版本,emoji 和擴充區漢字存不進去,非 strict 模式下還會默默變成問號,所以字元集一律用 utf8mb4。
utf8mb4_unicode_ci 也不是最正確的 collation。它是「相容性最好、比 general_ci 正確」的歷史選擇,但會把所有 emoji 和擴充區漢字當成同一個字;如果只跑 MySQL 8.0 以上,utf8mb4_0900_ai_ci 是更好的答案。
- 不寫
utf8,一律寫utf8mb4。 - 伺服器、資料庫、資料表、欄位、連線,五層都是 utf8mb4。
- collation 全庫統一。MySQL 8.0 以上的新專案用
0900_ai_ci,要相容舊版用unicode_520_ci,沿用unicode_ci就要知道 emoji 會互撞。 sql_mode保留 strict,寧可報錯,也不要資料默默變成?。- 還留著
defaultStringLength(191)的專案,確認 row format 之後可以拿掉。