Multi-Agent 記憶架構:讓你的 AI Agents 不再各自為政
工具各自有紀錄,卻接不上彼此的進度
我的日常工作流裡有四個 AI agent,各自住在不同的環境,各自維護自己的記憶:
| Agent | 位置 | 負責什麼 | 記憶怎麼存 |
|---|---|---|---|
| Claude Code | MacBook(本地) | coding、專案管理 | ~/.claude/projects/*/memory/MEMORY.md |
| OpenClaw | VPS | daily briefing、聊天式更新、自動調研 | MEMORY.md + daily logs |
| n8n | VPS | webhook automation、Slack 通知 | workflow state |
| Notion | Cloud | 結構化資料庫(專案、OKR、影片企劃) | databases |
各自的工作能跑,但資訊沒有同步。
每天早上 OpenClaw 幫我整理好 briefing,但我打開 Claude Code 開始寫程式時,它完全不知道今天的重點是什麼。反過來也一樣,昨天 coding session 做完的進度,OpenClaw 隔天的 briefing 裡完全沒有。
我得另外安排交接,才不用每次自己搬資料。
每次開工,都要重新補背景
Context switching 最貴的部分,不是切換視窗,而是「腦中的狀態要重新載入」。
對人類來說是這樣,對 AI agent 也是。每次開一個新的 Claude Code session,我得花前五分鐘把「現在這個專案做到哪了」「今天最重要的事是什麼」「有哪些 blocker」重新餵一遍。有些是 MEMORY.md 已經記了的,但更多是散落在 OpenClaw 的對話紀錄、Notion 的專案頁面、甚至昨天 Slack 的某則通知裡。
我開始想:有沒有可能讓 agent 之間共享 context,像一個團隊共用一份會議紀錄?
我參考了哪些做法
在動手設計之前,我花了時間研究社群裡其他人怎麼解決這個問題。幾個有趣的發現:
1. Markdown as Shared Memory
其中一種做法是把共享資訊存成 Markdown,方便直接讀取和修改:
- 可讀:人和 AI 都能直接讀
- 可版控:丟進 git 就有完整歷史
- Agent 原生支援:幾乎所有 AI agent 都能讀寫 Markdown
2. Per-Repo 文檔 + INDEX.md Master Registry
一個常見的結構是在每個 repo 底下維護 workspace/projects/ 目錄,每個專案一組文件,再用 INDEX.md 當全域索引。Agent 啟動時讀 INDEX 就知道有哪些活躍專案。
3. Hot / Warm / Cold 三層記憶
不是所有資訊都值得永久保存。一個實用的分層是:
- Hot:MEMORY.md,最近 7 天的 context,每次 session 直接載入
- Warm:每 6 小時自動 consolidate,把細節壓縮成摘要
- Cold:Daily logs,永久保存但不主動載入,需要時再查
4. n8n Data Table 當記憶層
Agent One 案例裡,用 n8n 的 Data Table(就 5 欄)取代了整套 vector DB。欄位大概是 key、value、category、timestamp、ttl。夠用、好維護、不需要額外基礎設施。
5. AGENTS.md 跨工具標準
Linux Foundation 正在維護的 AGENTS.md 規範,嘗試定義一個讓不同 AI agent 都能讀的專案描述格式。雖然還在早期,但方向值得關注。
各工具負責哪些資料
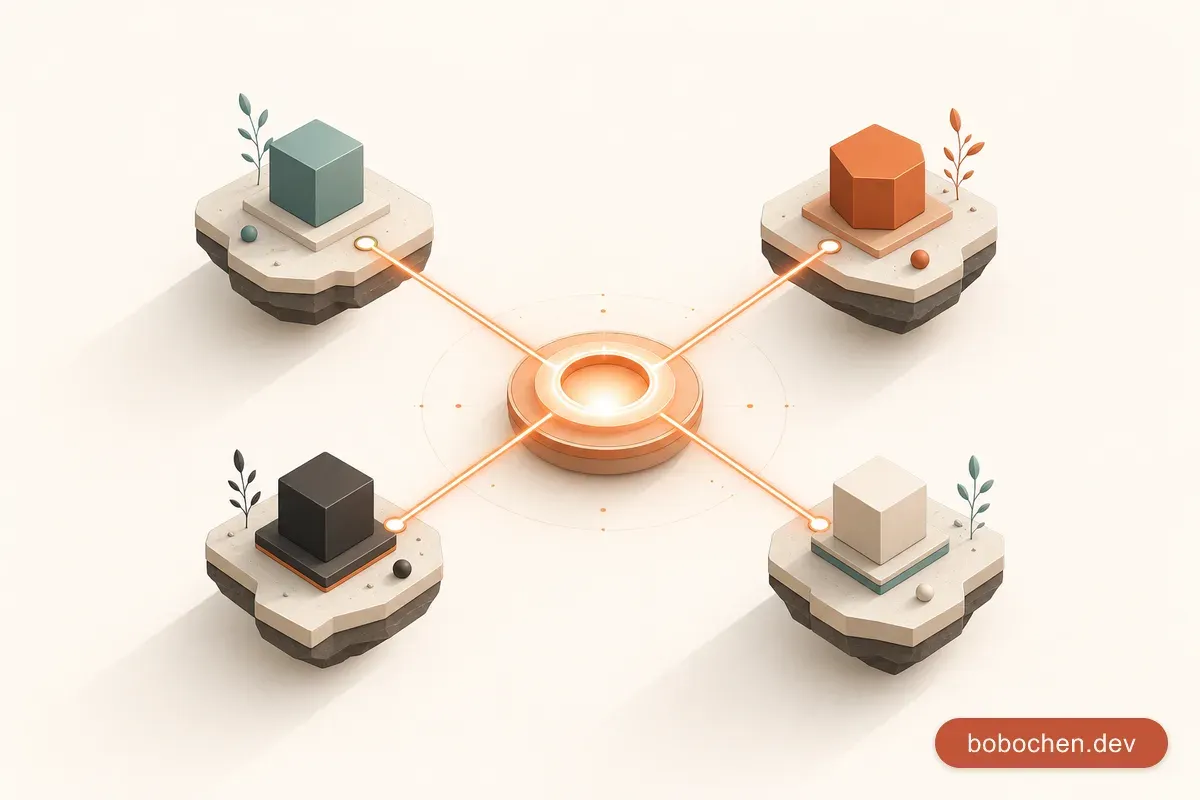
研究完之後,我決定不走「單一 hub」路線(例如全部丟 Notion 或全部丟某個 vector DB),而是讓每個工具做它最擅長的事:
flowchart TD
    N["Notion<br/>結構化資料 Source of Truth<br/>專案、OKR、ideas、影片企劃"]
    E["n8n<br/>Event Bus / 調度層<br/>觸發同步、通知、webhook 串接"]
    O["OpenClaw<br/>24/7 Agent"]
    G["Git Repo<br/>Memory Exchange Layer"]
    S["Slack<br/>通知"]
    C["Claude Code<br/>Deep Work Agent"]
    N -->|"API sync"| E
    E --> O
    E --> G
    E --> S
    O <--> G
    G <--> C
    O --> C
為什麼是混合式? 因為每個工具的強項不同:
- Notion 擅長結構化資料,拿來當 project 和 OKR 的 source of truth 最合適
- Git repo 是天然的版控系統,當 memory exchange layer 不需要額外建設
- n8n 本來就在做 event-driven automation,讓它當 message bus 順理成章
- OpenClaw 是 24/7 跑著的 autonomous agent,適合做 briefing 和主動調研
- Claude Code 是 deep work 時段的主力,專注在 coding 和架構設計
先做哪一段同步
完整流程還有不少部分要串,所以我先縮小第一版的範圍。
為什麼 MVP 先做 OpenClaw → Claude Code 單向同步?
因為這是最痛的方向。每天早上的 context loading 是最頻繁、最浪費時間的瞬間。如果 Claude Code 一啟動就知道今天 briefing 的重點,光這個就能省下大量的「暖機時間」。
為什麼用 Git repo 而不是 Notion 作為 exchange layer?
兩個原因:
- Agent 原生支援 git——Claude Code 可以直接讀 repo 裡的檔案,不需要任何 adapter
- Notion API 有 rate limit 和延遲,git pull 是毫秒級的
為什麼不用 Mem0 或 vector DB?
目前要交換的資料用 Markdown 就能處理:
- 記憶內容是結構化文字(briefing、session summary),不是需要語意搜尋的長文
- 可讀性很重要——我要能直接打開檔案看內容、手動修正
- 不需要額外的基礎設施成本和維護負擔
Vector DB 在需要語意搜尋大量非結構化資料時很強,但對「四個 agent 共享每日 context」這個場景,是 overkill。
MVP:Daily Context Bridge
第一版打算用 cron job 串起來:
OpenClaw cron (09:00)
    → 產出 daily-briefing.md
    → git commit + push
    → Claude Code session start 時自動讀取
先確認每天產生的 Markdown 能送到 repo,再讓 Claude Code 開工時讀取。
內容格式大概長這樣:
# Daily Briefing — 2026-03-22

## 今日重點

- [ ] Multi-agent memory 架構文章完稿
- [ ] Mystery Shopper 前端 bug fix(P1)

## 昨日進度(from Claude Code session)

- statusline 色彩升級完成
- 新增 Mystery Shopper project memory

## Blockers

- VPS 儲存空間快滿了(剩 2GB)

## 值得注意

- n8n 有 3 個 workflow 昨天失敗(已自動重試成功)
Claude Code 啟動時讀到這份檔案,立刻知道今天該優先做什麼、昨天的 context 是什麼、有哪些地雷要注意。
Phase 路線圖
後續可以分成這幾步:
| Phase | 做什麼 | 解決什麼 |
|---|---|---|
| Phase 1 (MVP) | OpenClaw → Claude 單向同步 | 早上的 context loading |
| Phase 2 | Claude 收工 → session-summary.md → OpenClaw | 雙向同步,隔天 briefing 能包含昨天 coding 進度 |
| Phase 3 | n8n 作為 message bus,event-driven 完整架構 | 即時同步,任何 agent 的狀態變化都能觸發通知 |
Phase 1 可能這周就能上線。Phase 3 可能永遠不需要做——如果雙向摘要同步已經夠用的話。
先試每日摘要能不能接上
我現在最想解決的是:早上打開 Claude Code 時,不必再把 briefing 搬一次。所以會先做單向同步,確認內容足夠、時間也對,再加入收工摘要。
舊資料則另外歸檔。每天啟動不需要讀完所有歷史,但有疑問時,仍要找得到原始紀錄。
如果也想串接多個工具,可以先挑最常需要手動搬資料的那一段。用幾天看看省下什麼、還漏哪些背景,再決定要不要做到即時同步。