Multi-agent 該不該用?先看任務能不能真的拆開
本篇是「從 PoC 到 Production:企業 AI Agent 系統工程」系列的第 8 / 12 篇。你可以從系列總覽開始閱讀,也可以直接接著看本文。
這是「從 PoC 到 Production:企業 AI Agent 系統工程」系列第 8 篇(共 12 篇)。上一篇:Agent memory 與狀態管理。
Multi-agent 很容易讓人聯想到一支自動分工的團隊,聽起來也比單一 agent 厲害。但實際做下去,最先增加的常常是模型呼叫、context 交接和除錯難度,效果卻不一定更好。
因此這篇先從不該使用的情況談起,再看哪些任務真的值得拆分。
預設先用單一 agent
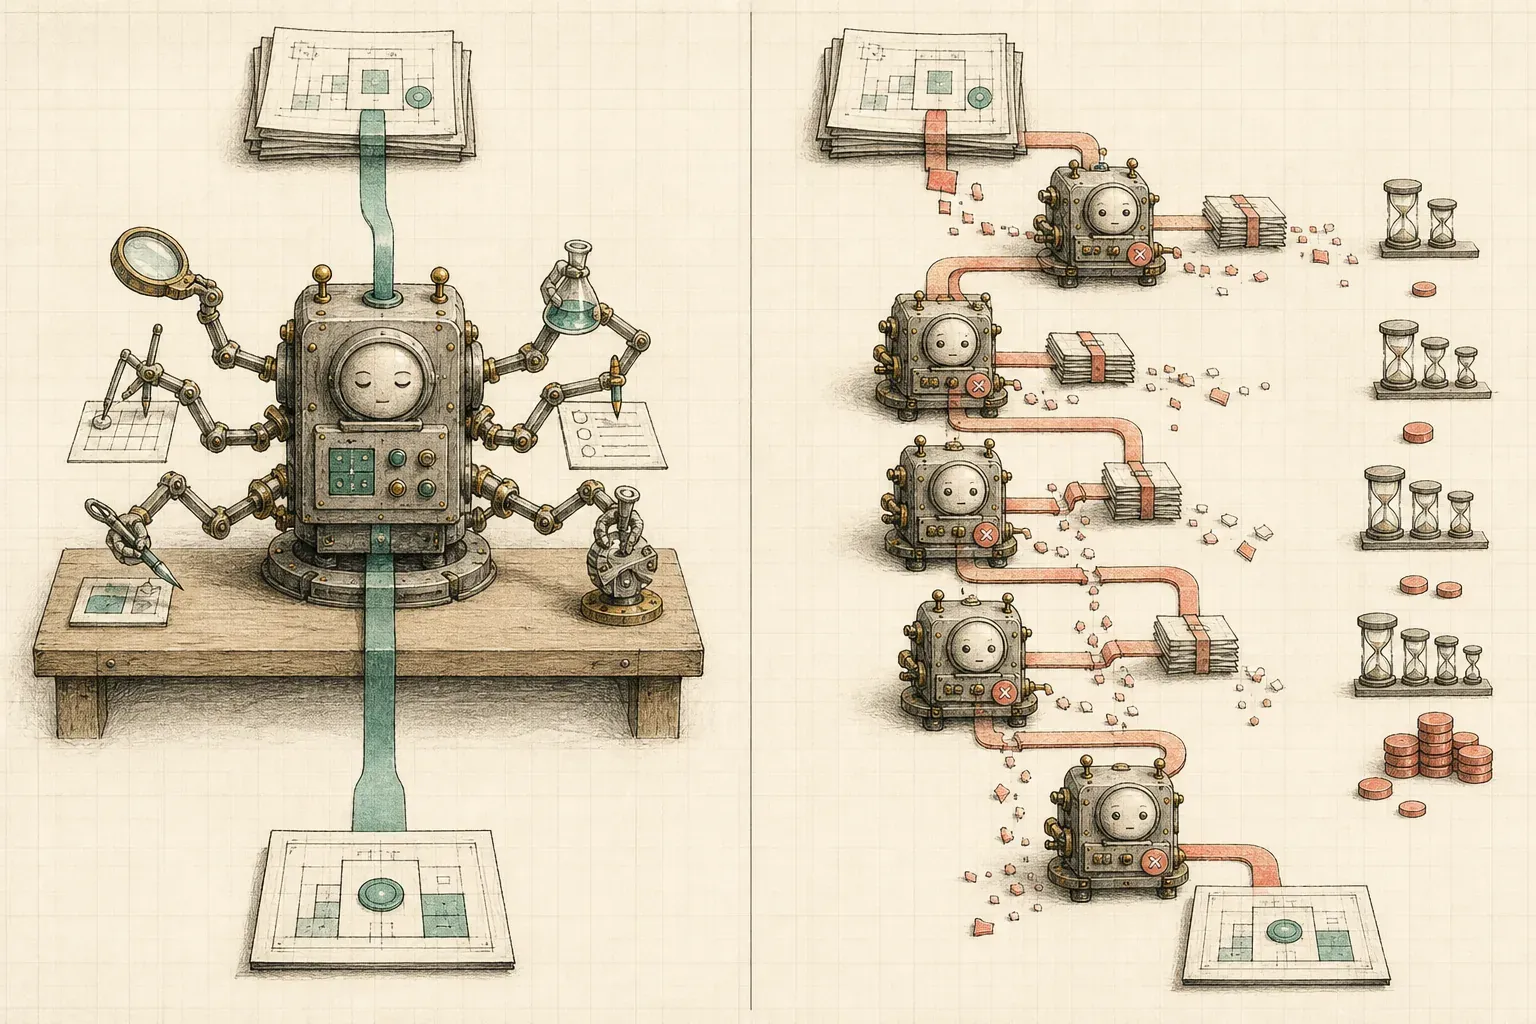
如果單一 agent 配上一組設計好的工具就能完成任務,先不要拆成 multi-agent。通常會更便宜,也比較好查問題。
為什麼?因為每多一個 agent,你就多了:
- 一次(或多次)額外的模型呼叫 → 更貴、更慢(第 10 篇)。
- 一個 context 傳遞的接縫 → agent A 的理解要傳給 agent B,這中間一定會流失資訊、產生誤解。
- 一個更難追的失敗點 → 出錯時,是哪個 agent 錯的?是它本身錯,還是它接收到的 context 已經被前一個 agent 弄歪了?
- 錯誤會傳染 → A 給了 B 一個錯誤前提,B 在錯誤前提上認真工作,整條鏈一起歪。
Anthropic 公開過一組很有參考價值的數字:agent 使用的 token 約為一般 chat 的 4 倍,multi-agent 系統則可能到 15 倍左右。也就是說,拆分能不能提升品質還沒確定,成本已經先明顯增加。
決定拆分前,可以先用單一 agent 和同一組工具做基準。如果品質或速度沒有明確過不了的地方,就沒有必要先承擔 multi-agent 的額外複雜度。
什麼時候 multi-agent 真的有價值
有三種情況,多代理確實划算:
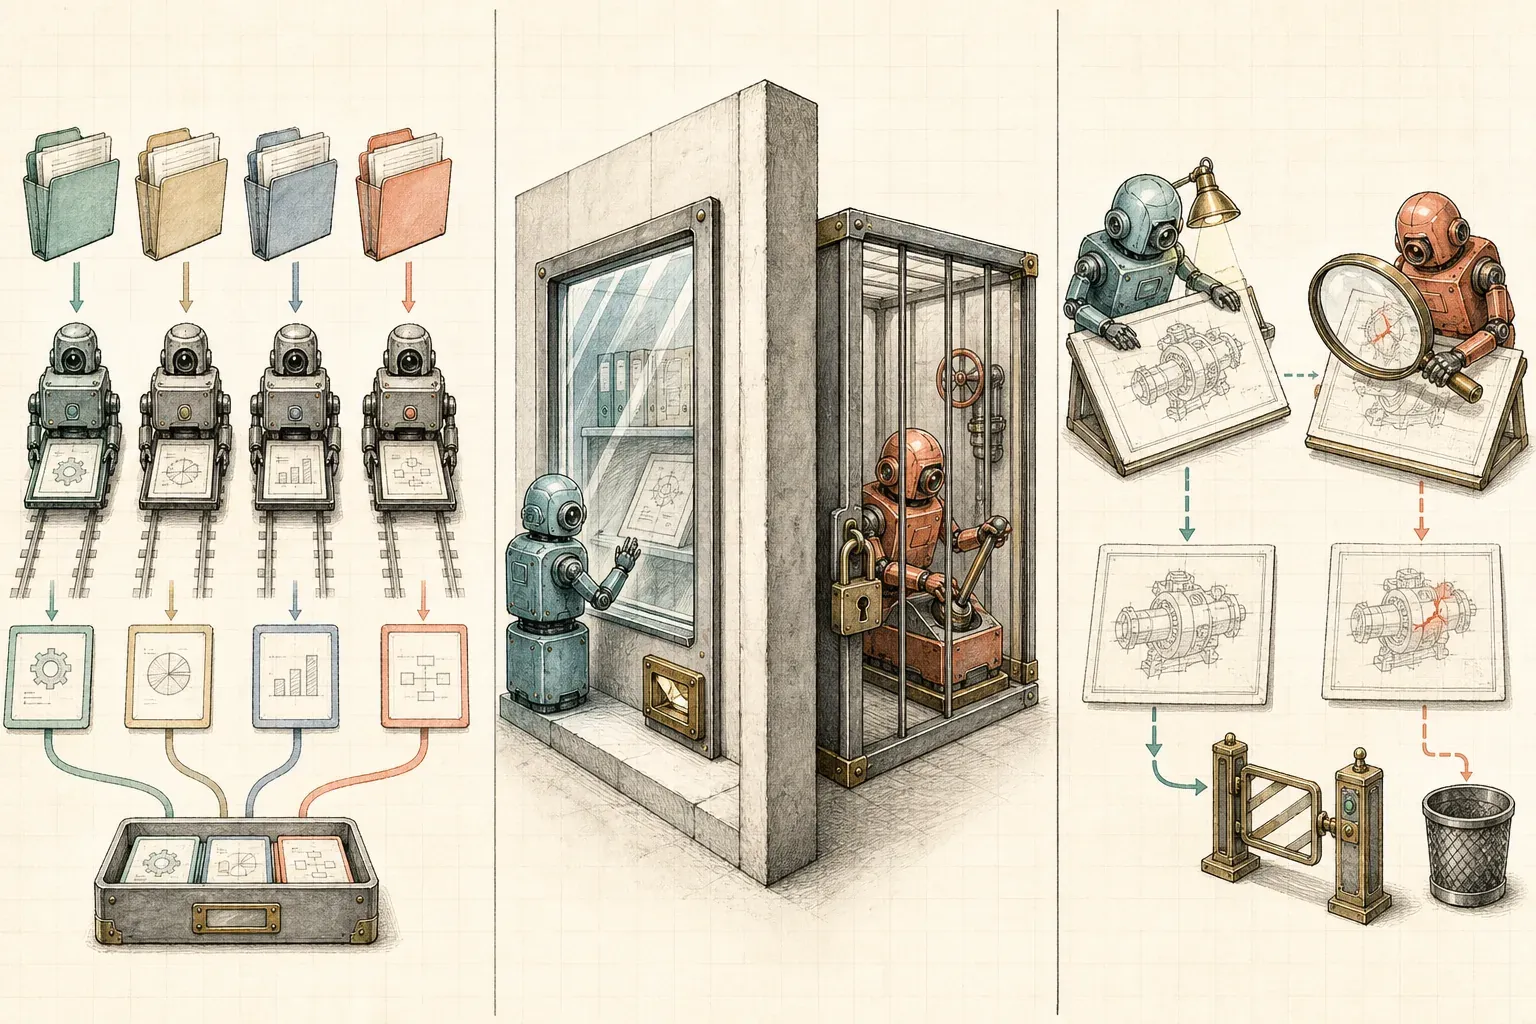
1. 任務天然可以平行拆分。 比如「分析這 20 份競品報告」,拆成 20 個 agent 各讀一份、最後彙整,比一個 agent 慢慢讀快很多。這裡的價值是平行,不是「聰明」。
2. 需要的能力 / 權限差異很大。 一個負責「讀取分析」、另一個負責「執行高權限寫入動作」。把它們分開,是為了權限隔離(第 5、6 篇)——讓會動手的那個 agent 只有最小必要權限,唯讀分析的那個碰不到危險工具。這是安全考量驅動的拆分,很合理。
3. 需要對抗 / 審查的結構。 一個 agent 產出、另一個 agent 專門挑錯(critic)。這種「生成 vs 審查」的張力,確實能提升品質——本質上是把「自我檢查」外部化成一個獨立角色。
這三種情況的共通點,是拆分都有明確目的:加速平行工作、隔離權限,或加入獨立審查,而不是照著公司組織圖多建立幾個角色。
這個判斷不是我一個人的偏執。2025 年 6 月有一場被社群並列為「同一週對打」的公開辯論:Anthropic 發表《How we built our multi-agent research system》,主張在可平行的廣度研究任務上拆 agent 很划算——他們的多 agent 系統在這類任務上比單一 agent 高出 90.2%;幾乎同一週,做 Devin 的 Cognition(Walden Yan)發表《Don’t Build Multi-Agents》,主張預設就用單執行緒的線性 agent、別輕易拆。
兩種說法的差異,其實在任務能不能平行解耦。Anthropic 也提到,多數 coding 任務可平行的部分比研究少,因為各部分互相依賴,還要共享同一份 context。讀 20 份競品報告可以各讀各的;寫同一個 feature 時,幾個 agent 同時修改相依模組就很容易互相踩到。
幾種協作模式
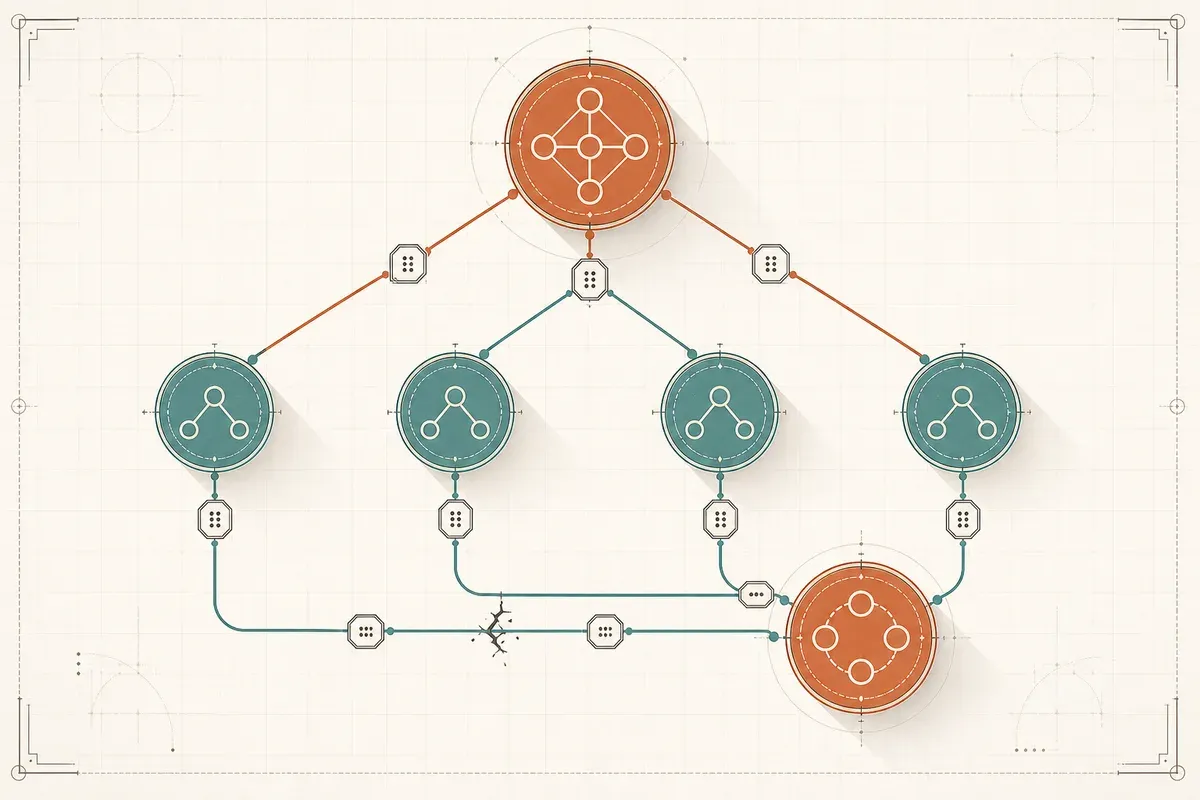
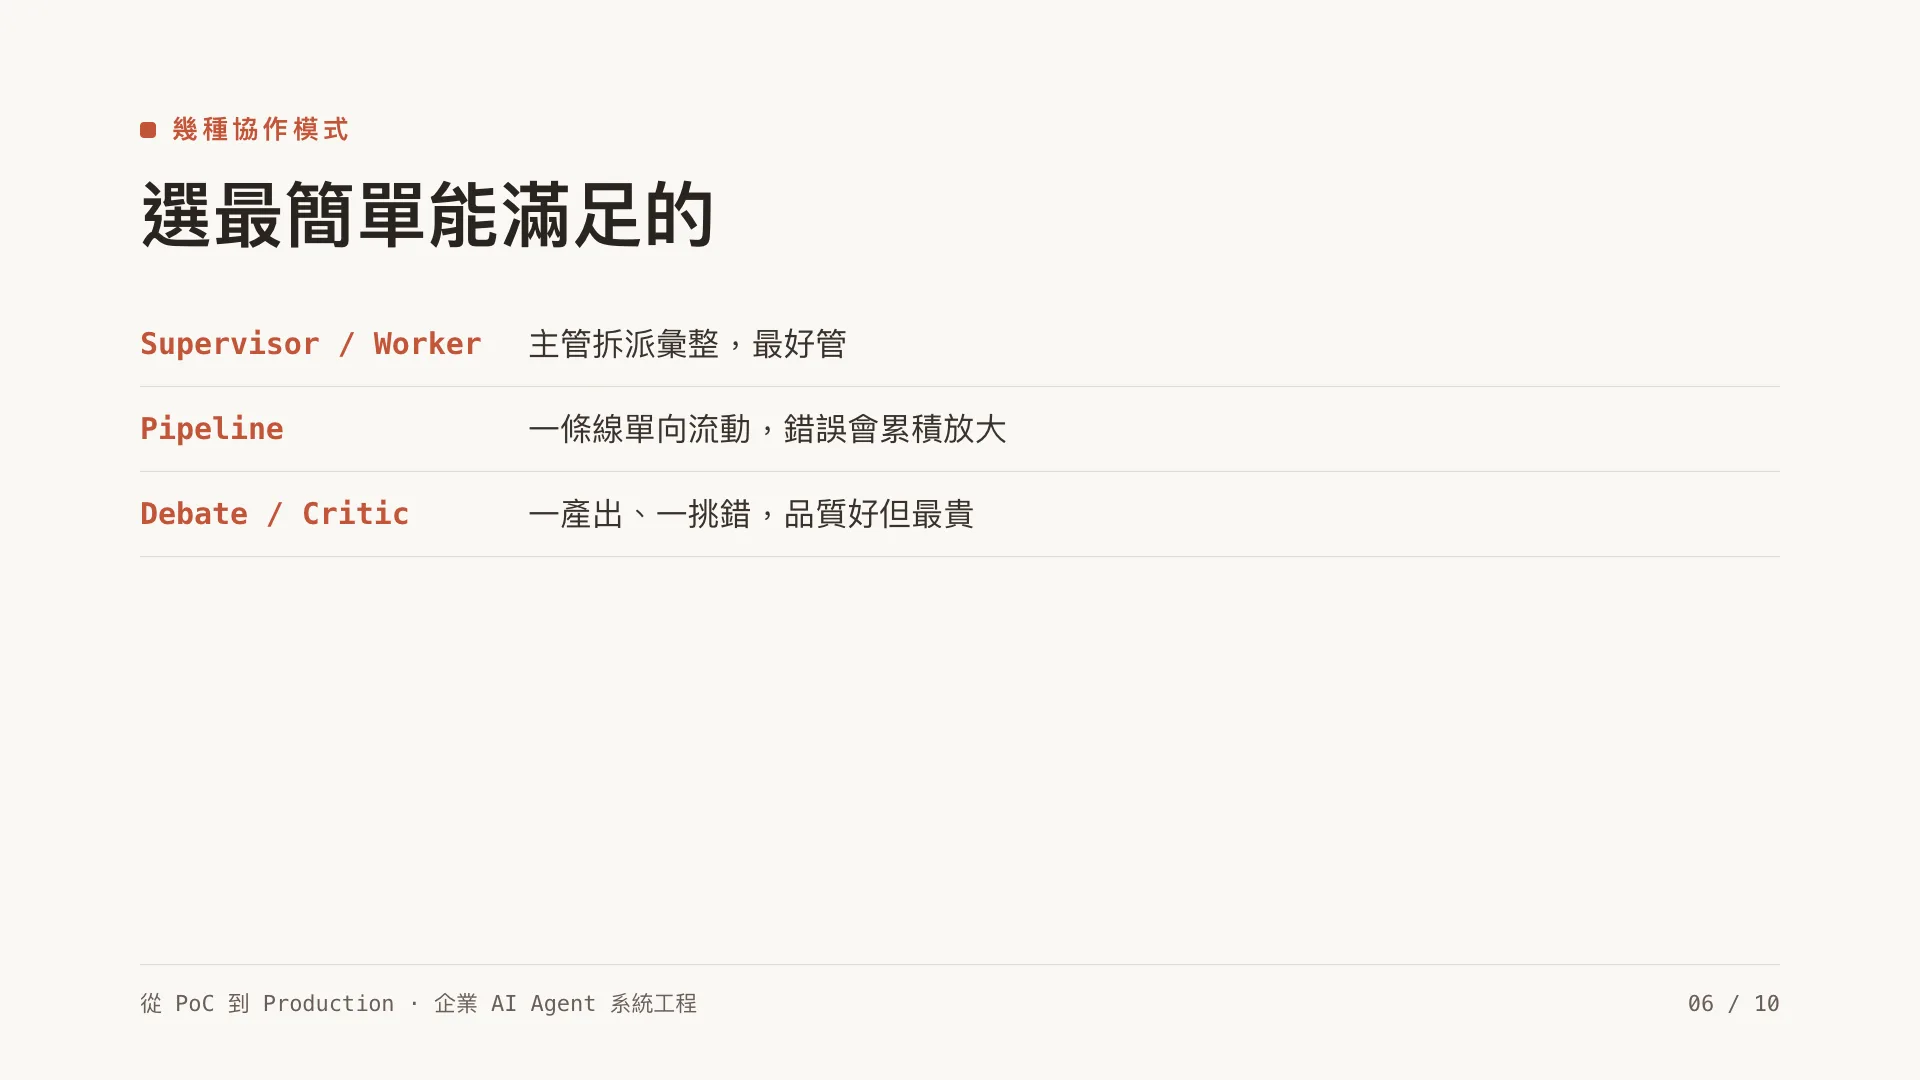
真的要做了,常見的結構有這幾種——三種的差別,其實就是「控制流長什麼形狀」:
flowchart TB
    subgraph DEB["Debate / Critic:同一題算好幾遍,最貴"]
        direction TB
        D1["提案 agent"] --> DC["收斂出結論"]
        D2["反駁 agent"] --> DC
    end
    subgraph PIPE["Pipeline:單向流動,誤差會累積"]
        direction LR
        P1["研究"] --> P2["草稿"] --> P3["審稿"] --> P4["定稿"]
    end
    subgraph SUP["Supervisor / Worker:控制流集中一點"]
        direction TB
        S["Supervisor"] --> W1["Worker"]
        S --> W2["Worker"]
        S --> W3["Worker"]
    end
Supervisor / Worker(主管—工人)
一個 supervisor agent 負責拆任務、分派、彙整;底下幾個 worker agent 各做一塊。最常見、最好管,因為控制流集中在 supervisor,責任清楚。大部分企業場景用這個就夠。
Pipeline(流水線)
agent 串成一條線,A 的輸出是 B 的輸入(研究 → 草稿 → 審稿 → 定稿)。適合階段分明、單向流動的任務。要小心的是錯誤會沿著管線累積放大——第一棒歪一點,最後一棒可能歪很多。
Debate / Critic(辯論—審查)
多個 agent 對同一問題提不同觀點,或一個產出、一個反駁,最後收斂。品質好但最貴(同一問題算好幾遍),留給高價值、容錯低的決策用。
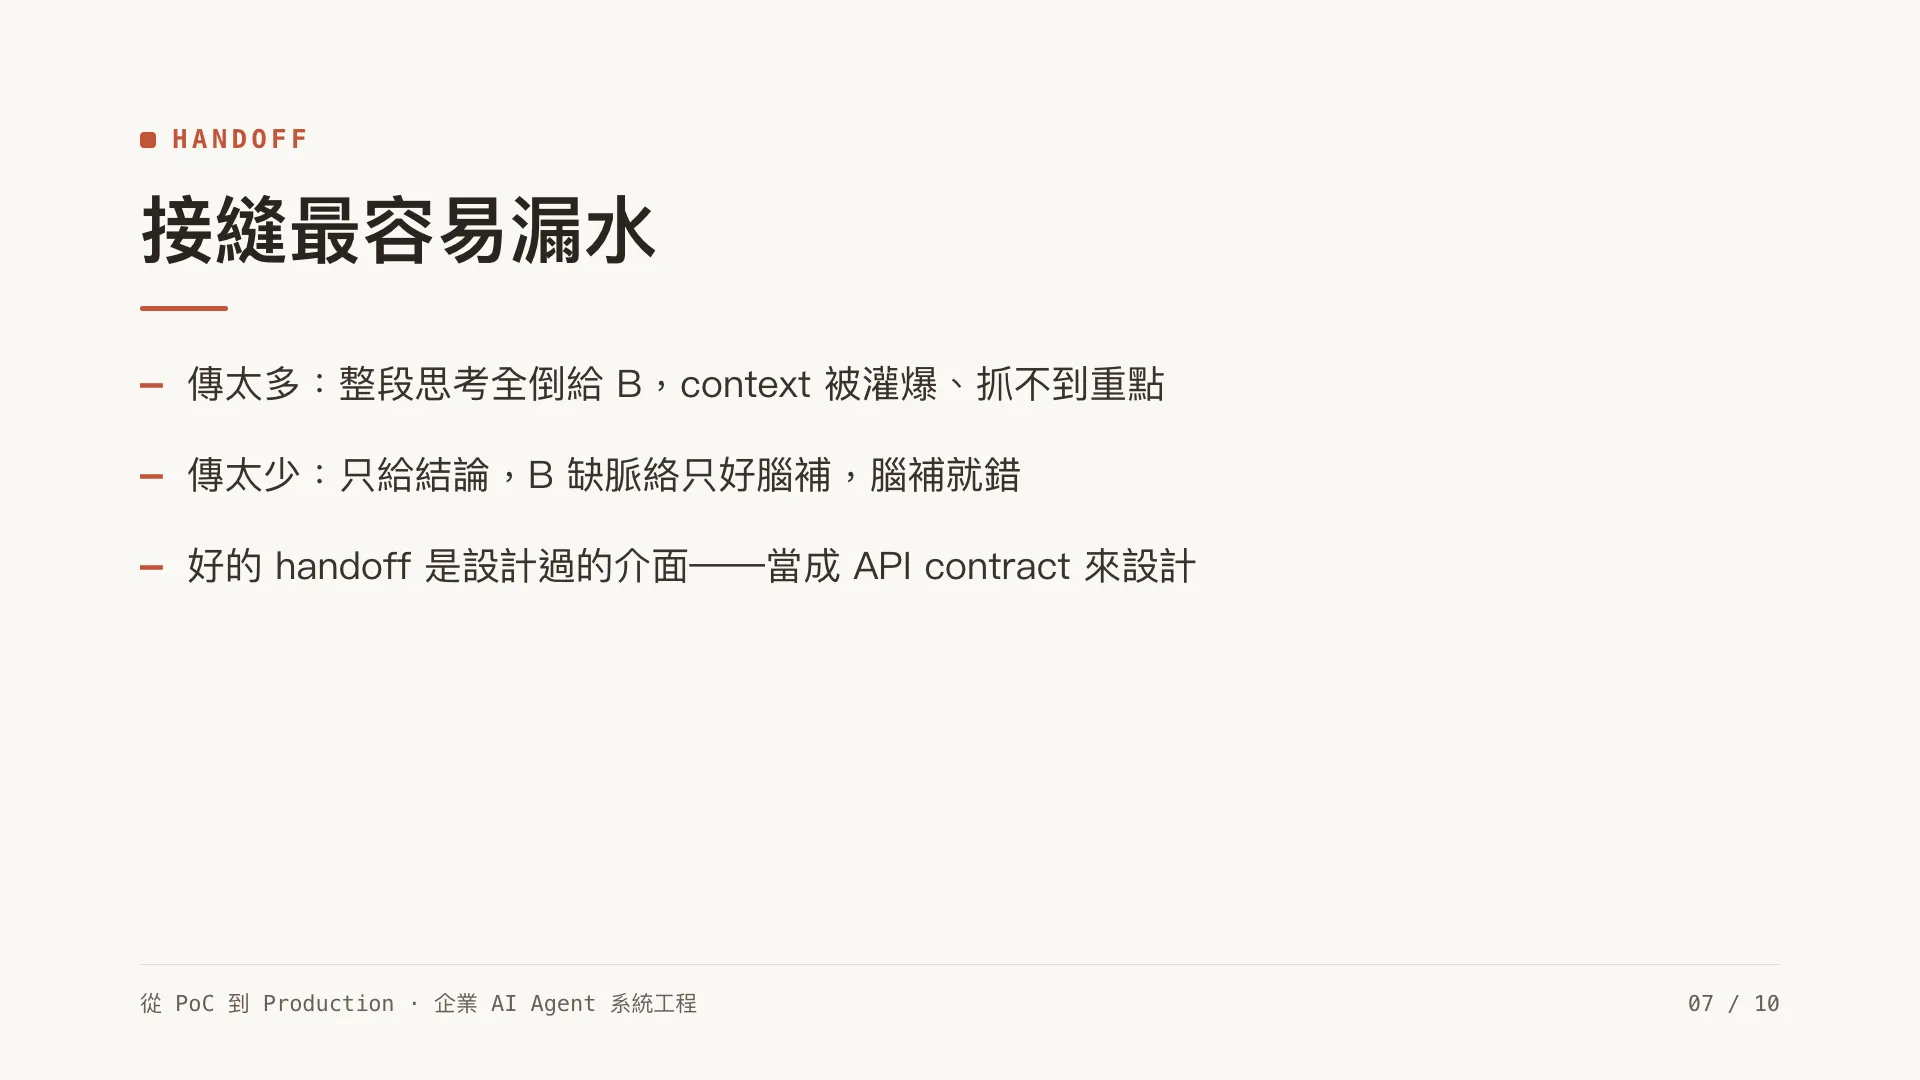
Handoff:接縫是最容易漏水的地方
多代理最脆弱的地方,是 agent 之間交棒(handoff) 那一刻。A 要把它的理解傳給 B,這裡有兩個常見坑:
- 傳太多:把 A 的整段思考、所有中間產物全倒給 B,B 的 context 被灌爆、抓不到重點、又貴。
- 傳太少:只給 B 一個結論,B 缺了關鍵脈絡,只好自己腦補,腦補就錯。
比較穩定的 handoff 會明確定義欄位與格式,像設計兩個 service 之間的 API contract。A 不必把整段歷史全倒給 B,B 也不該只拿到一句缺乏依據的結論。
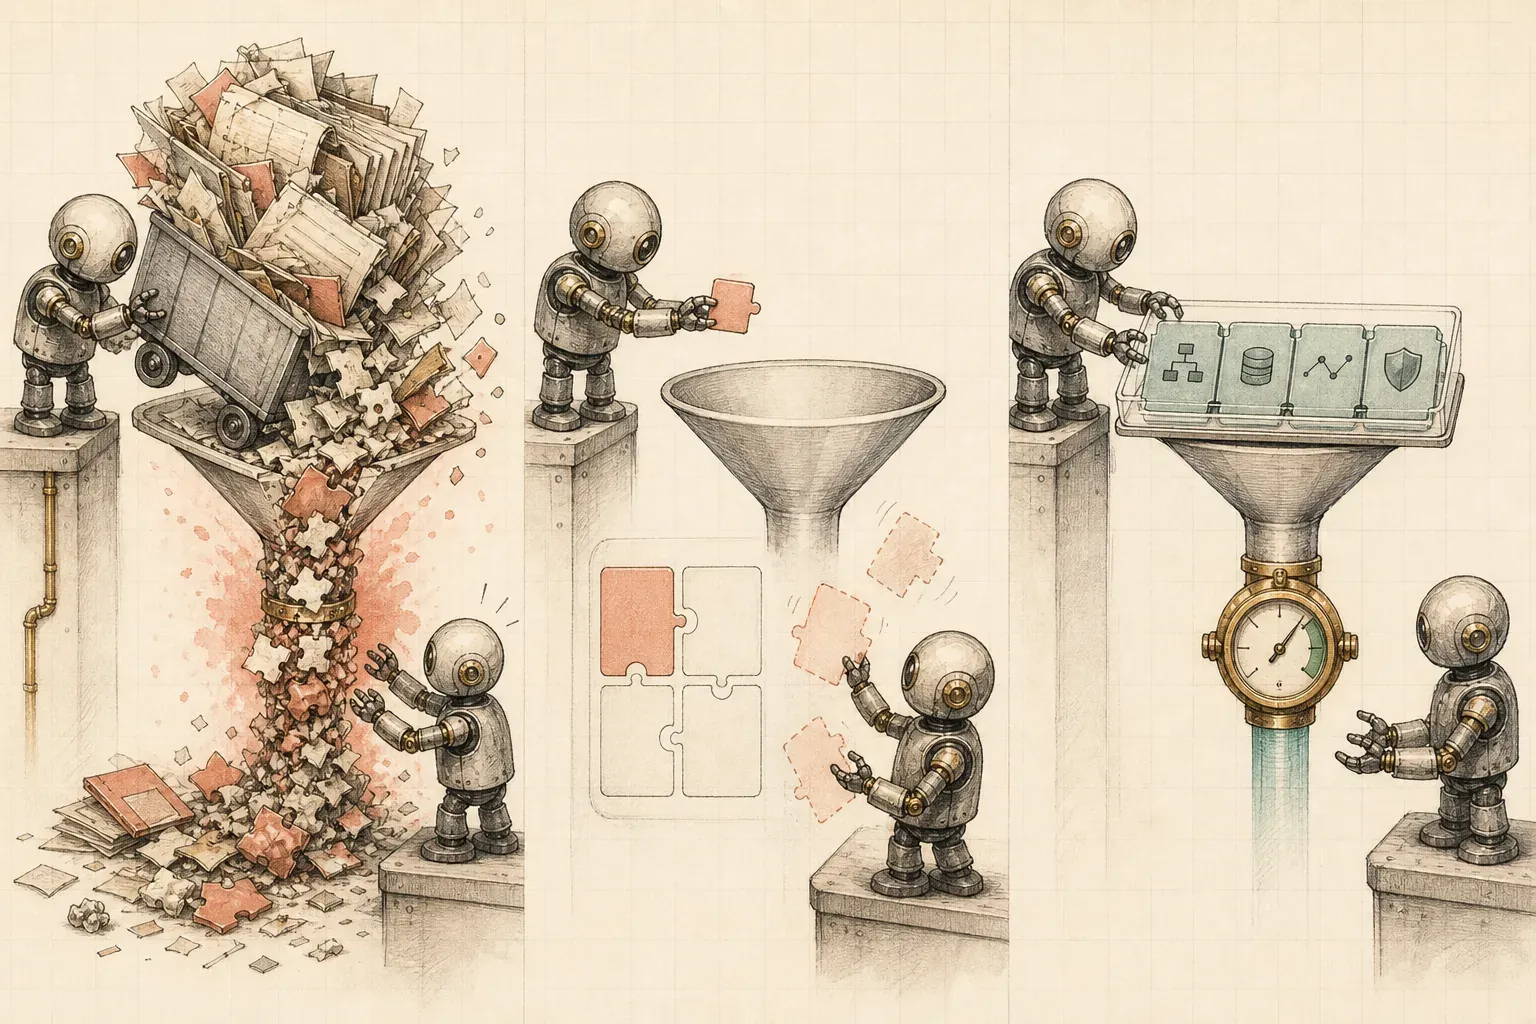
這套「把 handoff 當 API contract」的想法,框架也已經幫你制度化了。OpenAI 的 Agents SDK 就把 handoff 做成一級原語:agent A 用一個類似 transfer_to_agent_b 的工具呼叫,把控制權加上一份結構化 payload 交給 B,整個轉移還會被記錄、可以重播;後續更新甚至把巢狀 handoff 的完整歷史改成預設 opt-in,正是為了減少跨 agent 的 context bleed——框架的演進方向,剛好就是這篇講的那套介面紀律。
錯誤隔離:別讓一個 agent 拖垮全部
Cognition 講過一個很有畫面感的翻車案例:他們把「做一個 Flappy Bird clone」拆成平行子任務,結果一個 subagent 把背景做成了 Super Mario 的風格,另一個 subagent 做的鳥又跟整體美術不搭。每個 subagent 單獨看都很合理,合起來卻是個四不像——因為它們看不到彼此在做什麼。這就是「接縫漏水」最具體的長相:不是哪個 agent 出 bug,而是它們各自正確、彼此不一致。
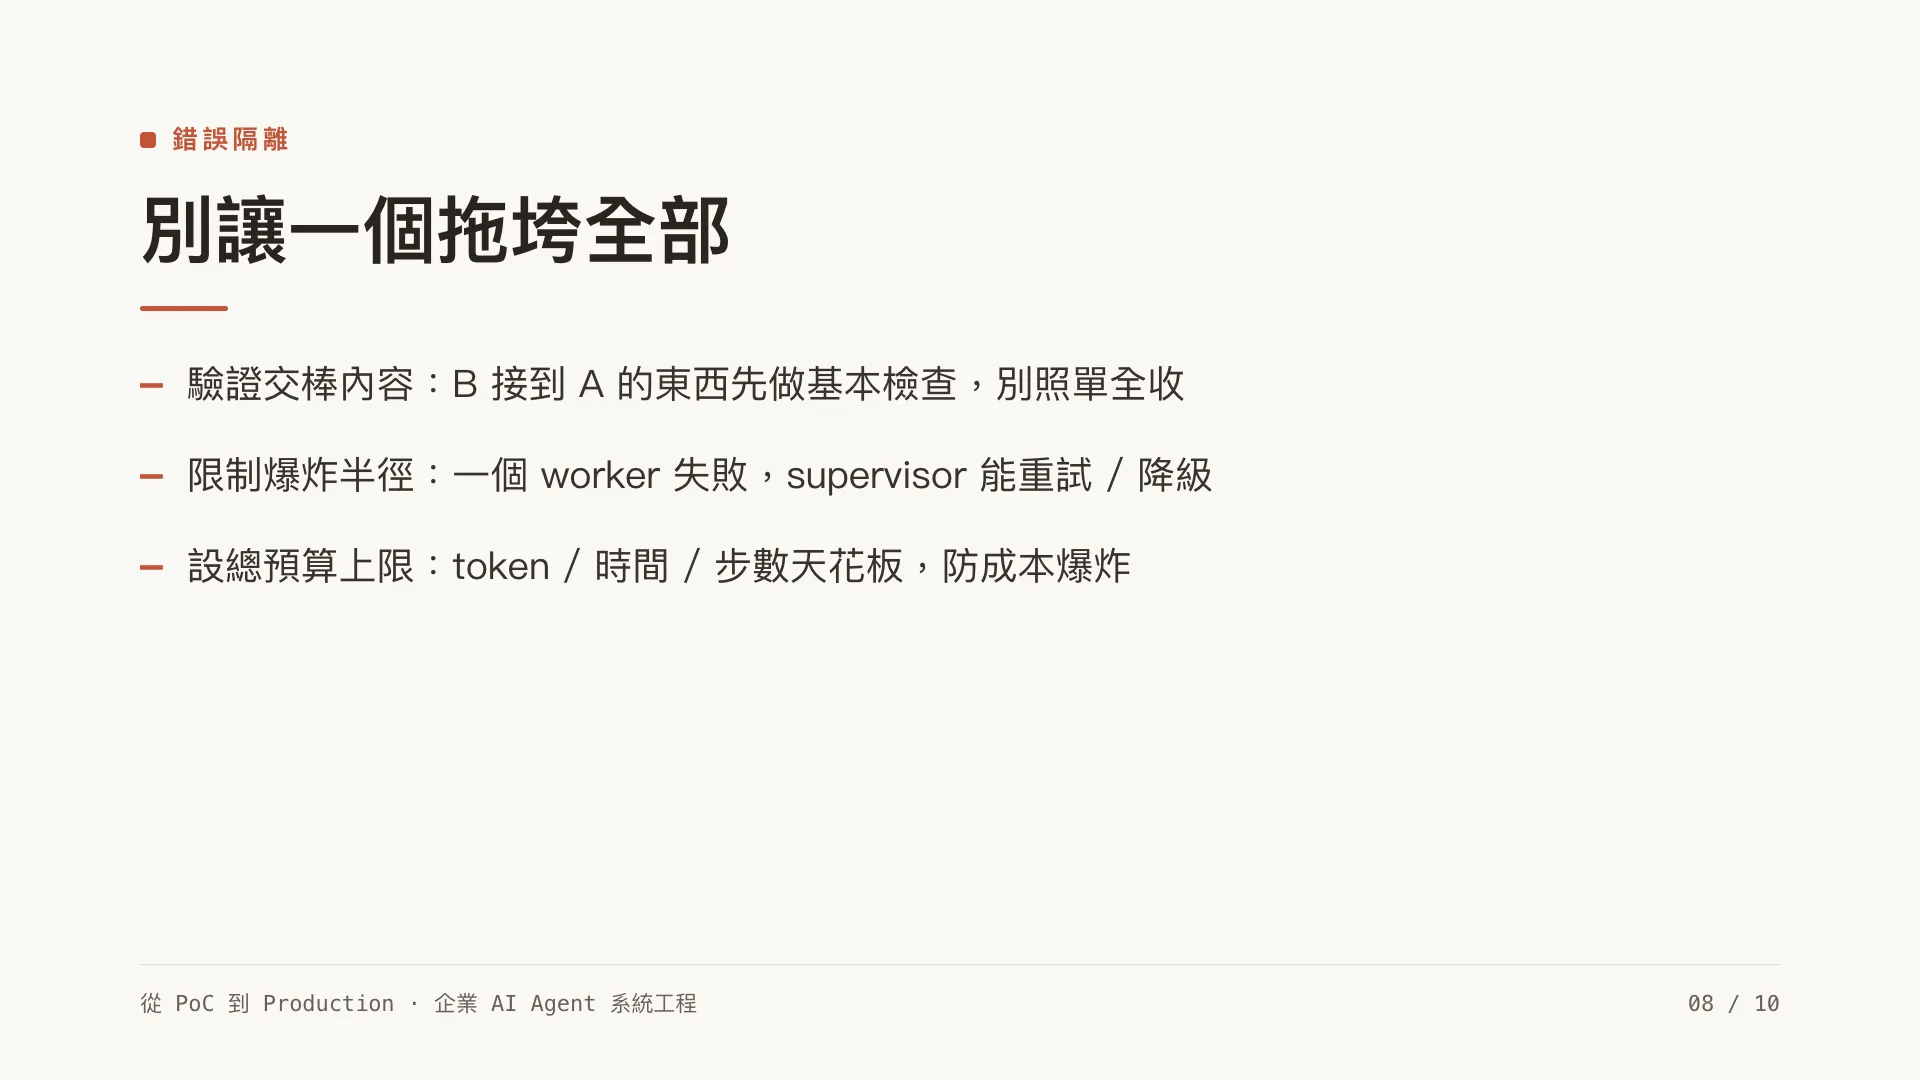
既然錯誤會傳染,就要主動隔離:
- 驗證交棒內容:B 接到 A 的東西,先做基本檢查(格式對不對、有沒有明顯矛盾),別照單全收。
- 限制爆炸半徑:一個 worker 失敗,supervisor 要能處理(重試、換人、降級),而不是整個任務崩掉。
- 設總預算上限:整個多代理任務要有 token / 時間 / 步數的天花板,否則一群 agent 互相觸發,可以把成本燒到失控(第 10 篇會細談這個「成本爆炸」風險)。
一個務實的決策流程
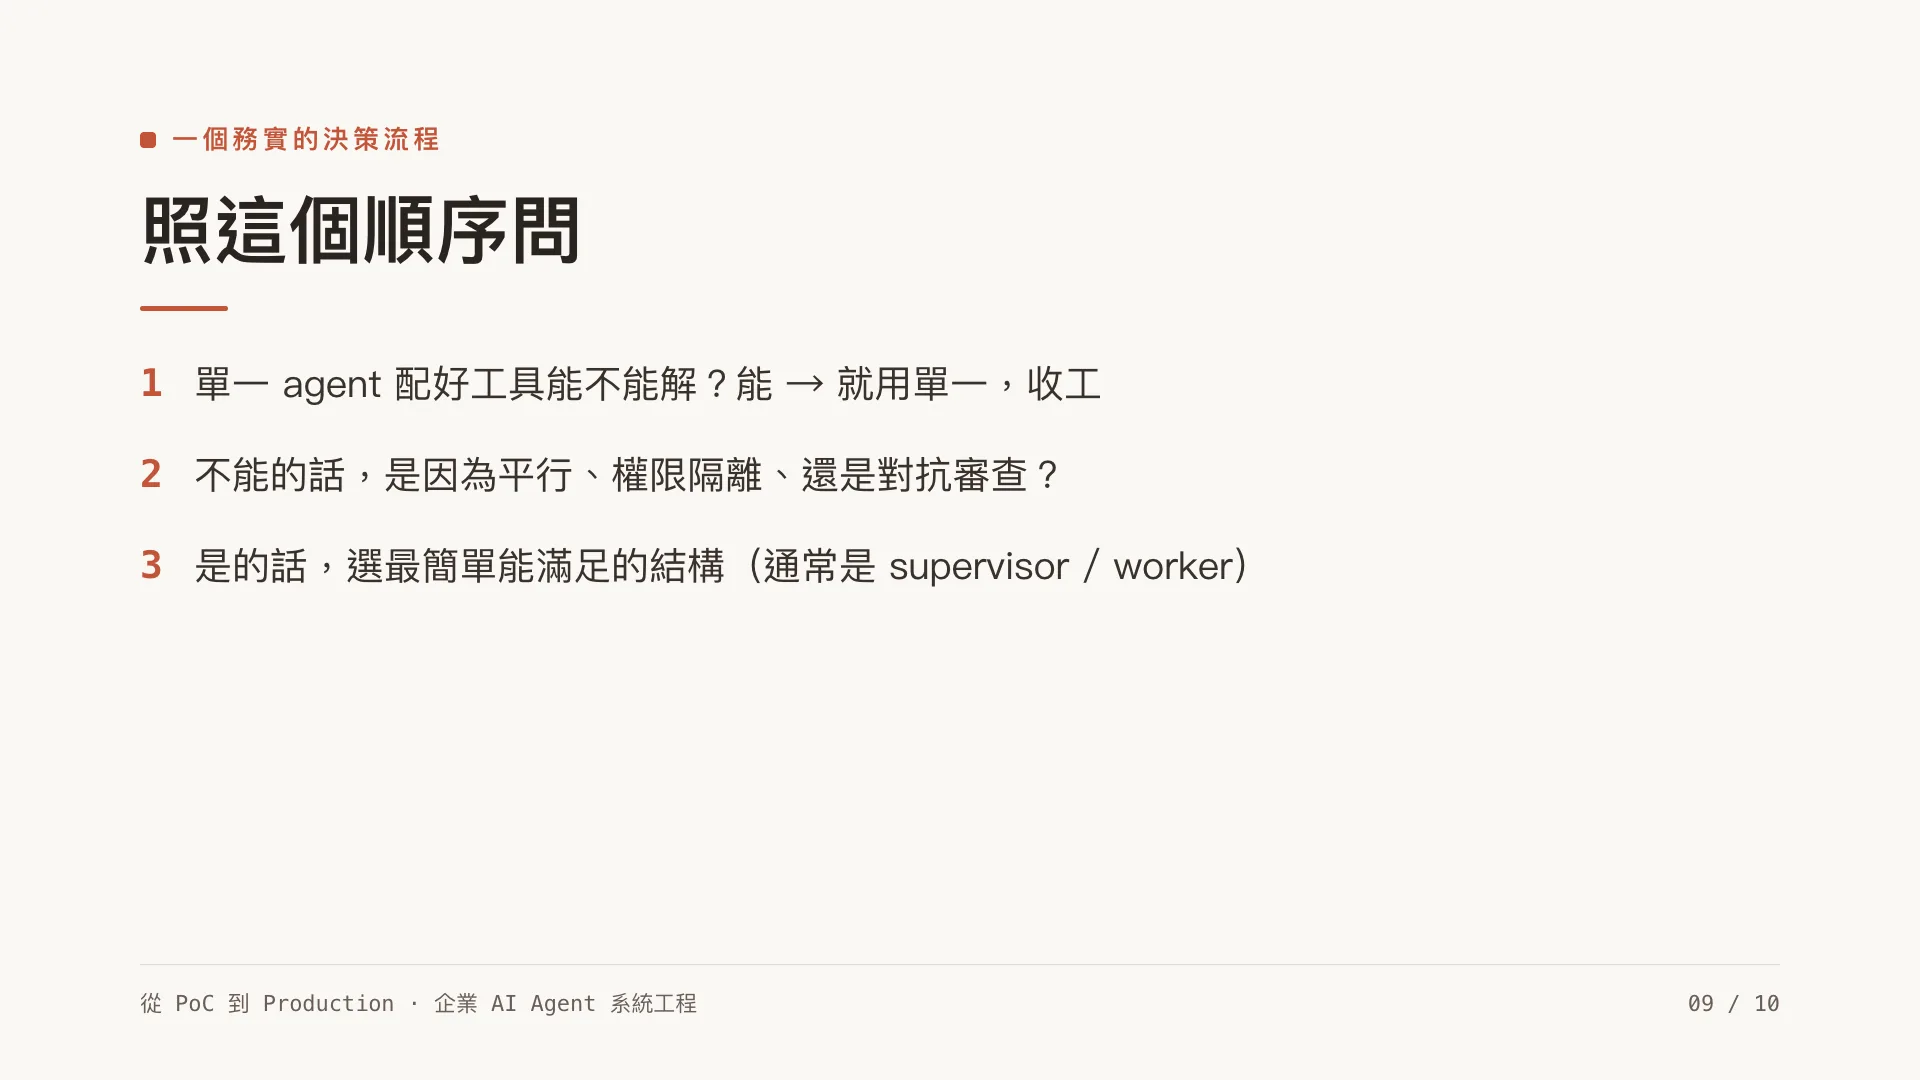
下次有人說「我們來做 multi-agent 吧」,照這個順序問:
flowchart TD
    Q1{"單一 agent 配好工具<br/>能不能解?"}
    Q1 -->|"能"| A1["就用單一 agent,收工"]
    Q1 -->|"不能"| Q2{"是因為平行、權限隔離<br/>還是需要對抗審查?"}
    Q2 -->|"都不是"| A2["你大概其實<br/>不需要 multi-agent"]
    Q2 -->|"是其中之一"| A3["選最簡單能滿足的結構<br/>通常就是 supervisor / worker"]
    A3 --> A4["handoff 當 API contract 設計<br/>設好預算上限與錯誤隔離"]
寫成文字是這三步:
- 單一 agent 配好工具能不能解? 能 → 就用單一,收工。
- 不能的話,是因為平行、權限隔離、還是需要對抗審查? 三個都不是 → 你大概其實不需要 multi-agent。
- 是的話,選最簡單能滿足的結構(通常是 supervisor/worker),把 handoff 當 API contract 設計,設好預算上限和錯誤隔離。
小結
Multi-agent 是一種有額外成本的架構選擇。先從單一 agent 開始;確定需要平行處理、權限隔離或獨立審查時再拆。拆開之後,handoff 要有固定格式,也要限制總 token、時間和步數。
Anthropic 給的判準也很接近:只有任務價值足以負擔額外 token 時,multi-agent 才划算。是否採用,最後還是要回到速度、品質提升和帳單能不能對得起來。
前面八篇依序處理了資料、記憶、工具和協作。接下來轉向上線後怎麼判斷系統是否正常。下一篇從可觀測性與評估開始:改了 prompt、模型或檢索參數之後,團隊怎麼知道結果是進步還是退步。
文章簡報
延伸閱讀
- 上一篇:Agent memory 與狀態管理
- 多代理協作的真實世界案例
- 用 Claude API 打造多代理系統
- 下一篇:《生產級 LLM 的評估與可觀測性》