帶領 3–8 人 AI 工程小隊:把交付做成固定節奏
本篇是「從 PoC 到 Production:企業 AI Agent 系統工程」系列的第 12 / 12 篇。你可以從系列總覽開始閱讀,也可以直接接著看本文。
這是「從 PoC 到 Production:企業 AI Agent 系統工程」系列第 12 篇,也是完結篇(共 12 篇)。上一篇:Agent 治理框架。
前面十一篇都在談系統,最後一篇回到實際負責交付的團隊。3 到 8 人不算多,既要做功能,又得顧資料、評估、權限和維運,因此工作方式往往比選哪套框架更重要。
我自己的做法,是先建立一個每個專案都能重複使用的 delivery loop,再決定新工具值不值得換。這樣至少不會每遇到一個新框架,團隊節奏就跟著重來。
為什麼「追新」是小團隊的陷阱
AI 領域每週都有新模型、framework 和工具。小團隊如果每個都追,很快會遇到幾個問題:
- 每換一次 framework,前面累積的 know-how 和工具就打掉一些。
- 團隊的精力被「學新東西」吃掉,而不是「交付價值」。
- 你永遠在起跑線上,永遠沒有把一個東西做到 production-grade。
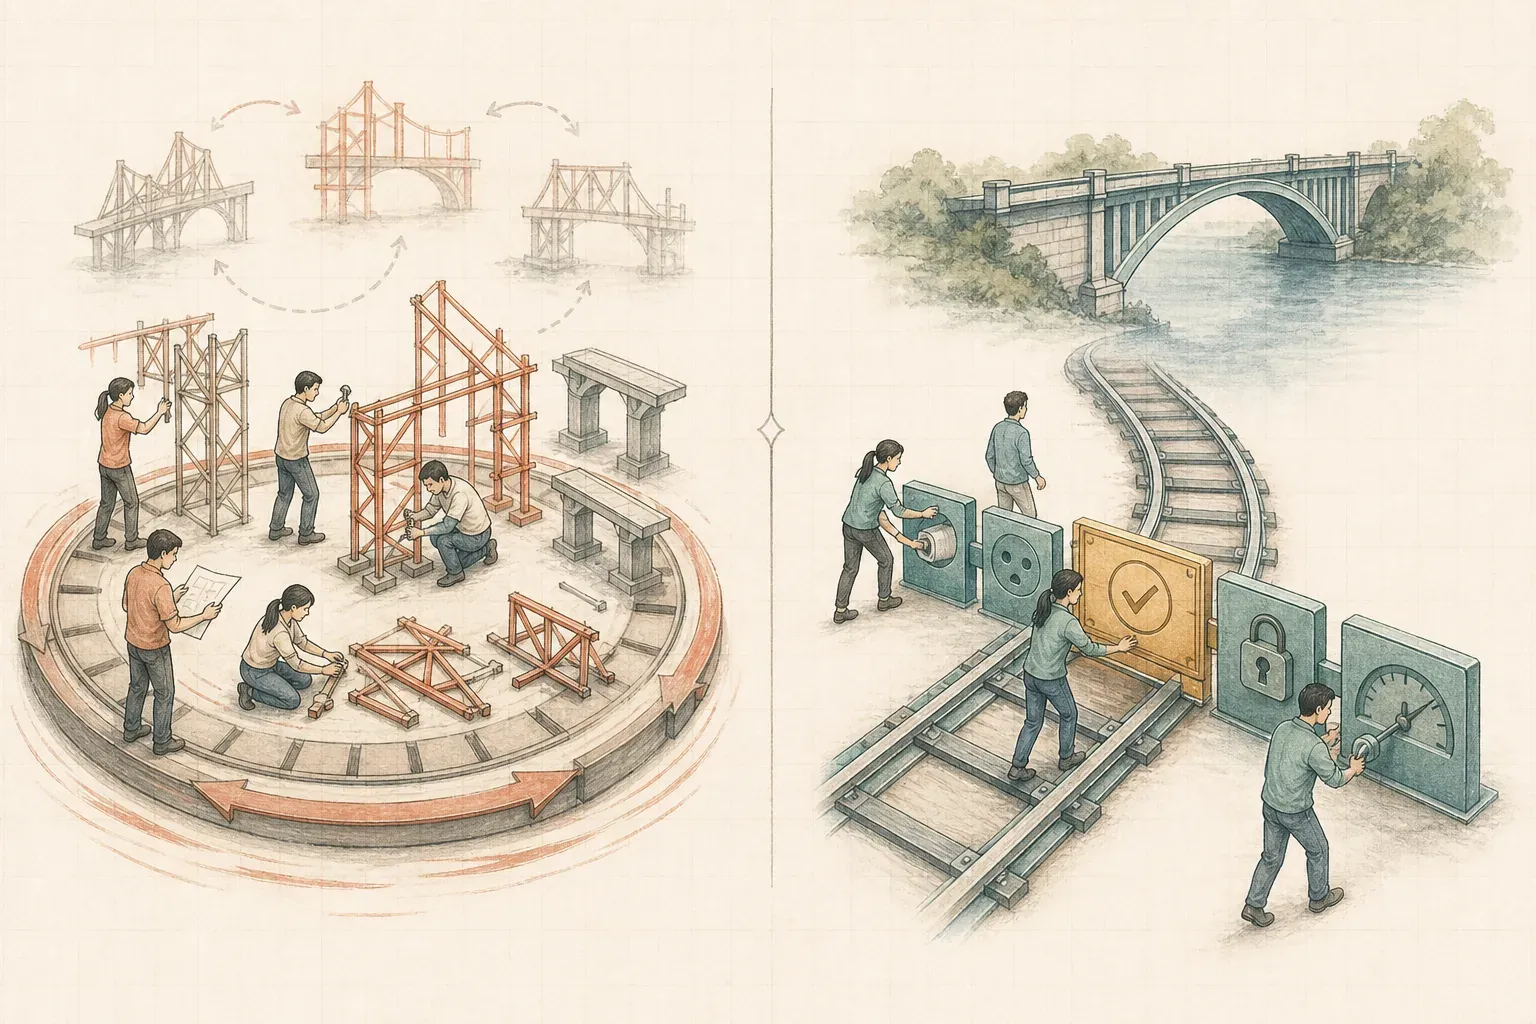
給個我自己用的粗略門檻:一個新 framework 要值得你打掉重練,它得能把你某個 delivery loop 環節的工作量砍掉一半以上、而且維護不用你自己扛——只是「換個寫法更優雅」不夠。LangChain 從 0.0.x 一路改到 1.0,多少團隊的 chain 寫法跟著翻修了好幾輪;同一段時間,「黃金題庫過了才能上」這條紀律一行都沒變。
這一年大量使用 agentic 工作方式後,我最有感的是:工具一直換,但 RAG 品質、eval、權限和可觀測性這些基本要求沒有跟著消失。Leader 要替團隊守住這些固定關卡,至於框架,能不能縮短交付時間、後續維護成本如何,再用實際數字判斷。
2026 回頭看更明顯:這一年真正沉澱下來、跨工具通用的,是介面和紀律,不是某個 framework。MCP 變成大家接 tool 的共同語言(也是為什麼我會去寫 MCP server,第 6 篇)、eval 從「加分項」變成 CI 裡的固定關卡、tracing 從各家自掃門前雪到 OpenTelemetry 的 GenAI conventions 開始有共通標準。這些你學一次、換不換 framework 都帶得走;某個「這個月最潮」的 agent SDK,你學了三個月可能就沒人維護了。
建立可重複的 Delivery Loop
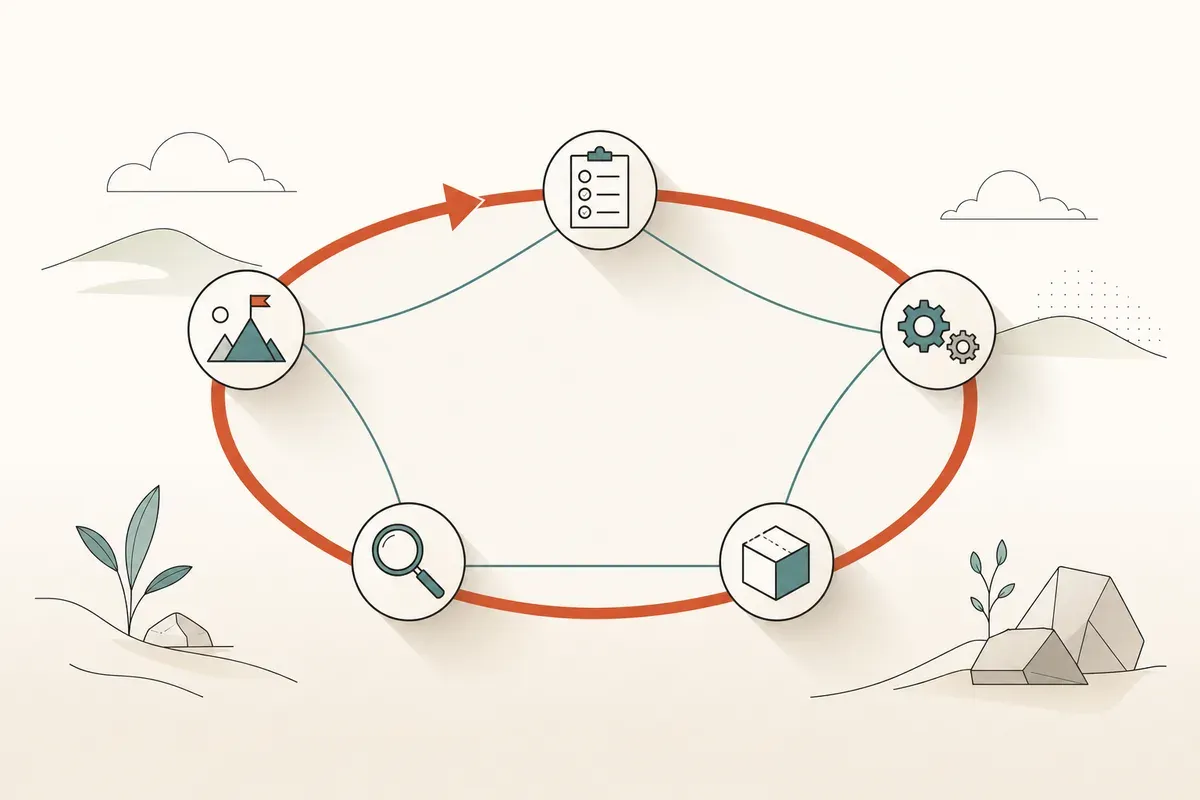
每個專案可以有不同細節,但基本循環最好固定下來:
需求 → 設計(架構/安全 review)→ 建黃金題庫 → 實作
  → eval 跑回歸 → 上線 → 觀測 → 用線上訊號回頭補題庫 → …
那個結尾的 … 才是重點——它其實是一個環,而且環的接點在「回頭補題庫」:
flowchart LR
    A["需求"] --> B["設計<br/>架構 / 安全 review"]
    B --> C["建黃金題庫"]
    C --> D["實作"]
    D --> E["eval 跑回歸"]
    E --> F["上線"]
    F --> G["觀測"]
    G -->|"用線上訊號回頭補題庫"| C
看那條從「觀測」繞回「建黃金題庫」的線:線上遇到的每一個壞案例,都應該變成題庫裡的一題。少了這條線,你的黃金題庫會停在上線那天的水準,然後隨著真實世界漂移,一天比一天不能代表現況。
這個 loop 把前面幾篇的要求放進固定流程:設計時看架構與權限,開發前準備題庫,上線後持續觀測。這樣不必依賴某個人臨時想起來,新人加入時也有清楚的交付路徑。
四種 Review,缺一不可
傳統團隊有 code review。AI 工程團隊需要的 review 更多,因為「能出錯的地方」更多:
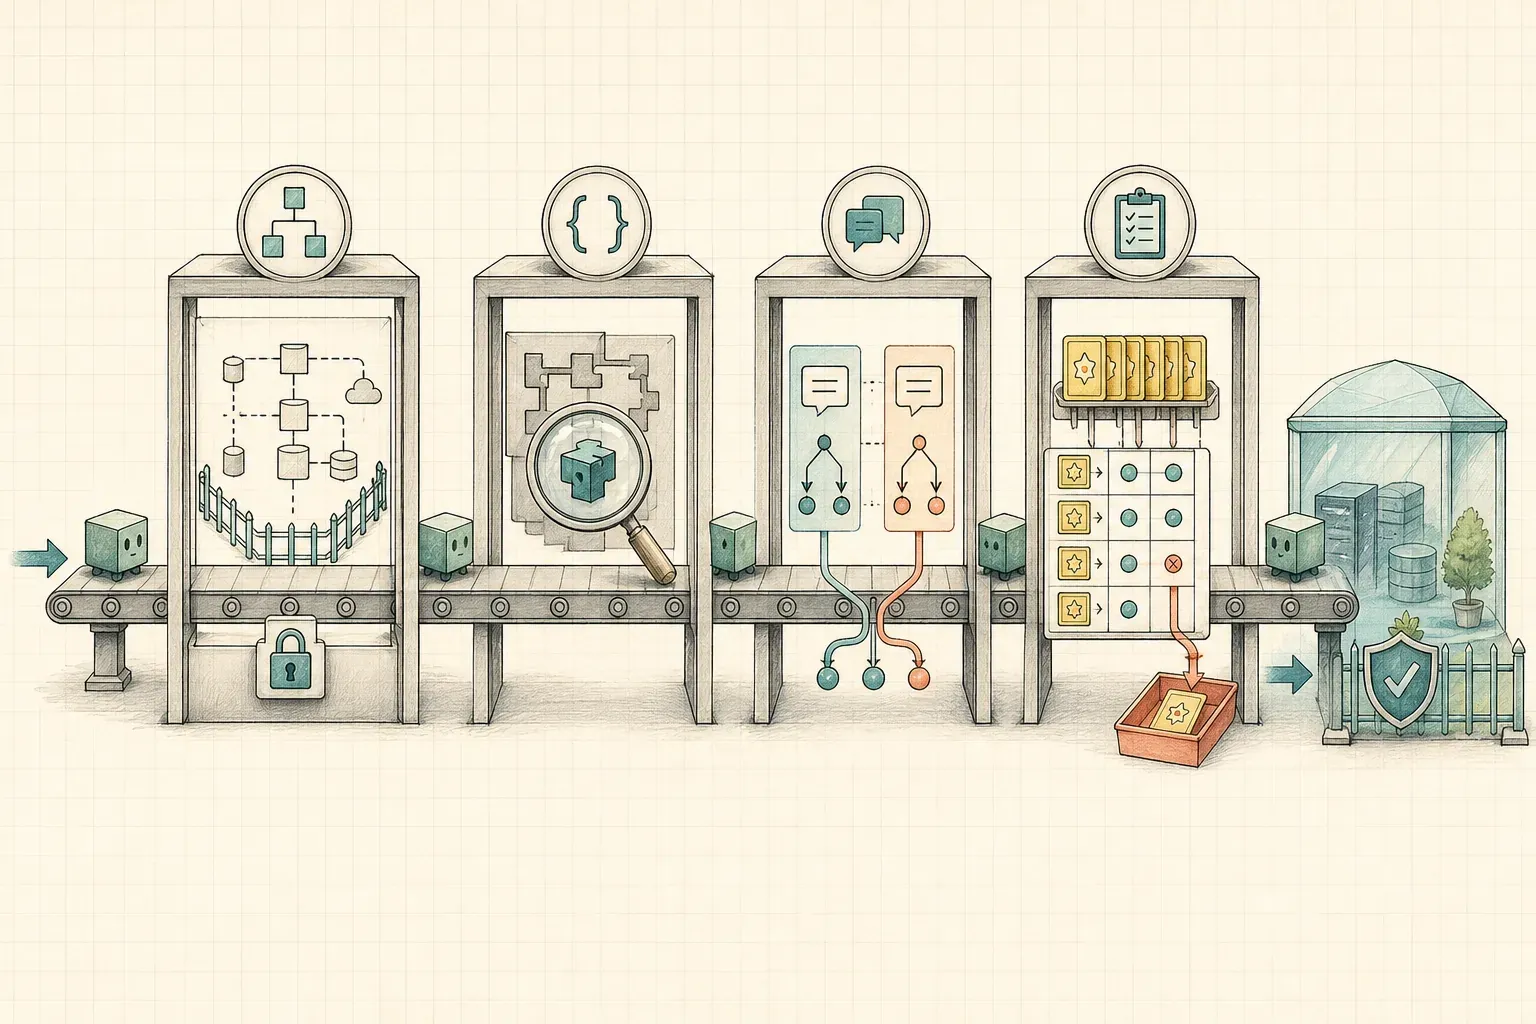
- Architecture review:新功能上之前,先過一次架構——這個 agent 的權限邊界對不對?工具會不會給太多?走 RAG 還是 fine-tune?放哪個三角的角(第 10 篇)?在還沒寫 code 前就把方向定對,比寫完再改便宜太多。
- Code review:照舊。AI 寫的 code 也是 code,一樣要審。
- Prompt review:prompt 是這個系統的「邏輯」,改一句可能行為大變。它該像 code 一樣被版本控制、被 review——具體一點:prompt 進 git、改動走 PR,而且 PR 裡附上這次的 eval diff(不是「我覺得這版更好」,是「通過率從 87% 到 91%,但這三題退步了」)。沒有 eval 數字的 prompt PR,跟沒有測試的 code PR 一樣不該過。
- Eval review:最容易被忽略、卻最重要的一種。黃金題庫(第 9 篇)夠不夠涵蓋?通過率掉了大家有沒有當一回事?團隊要建立一個文化:eval 沒過,跟測試沒過一樣,不能上。
把這四種 review 變成習慣,團隊產出的就不是「跑得動的 demo」,是「敢上 production 的系統」。
最被低估的能力:把 AI 翻譯成業務語言
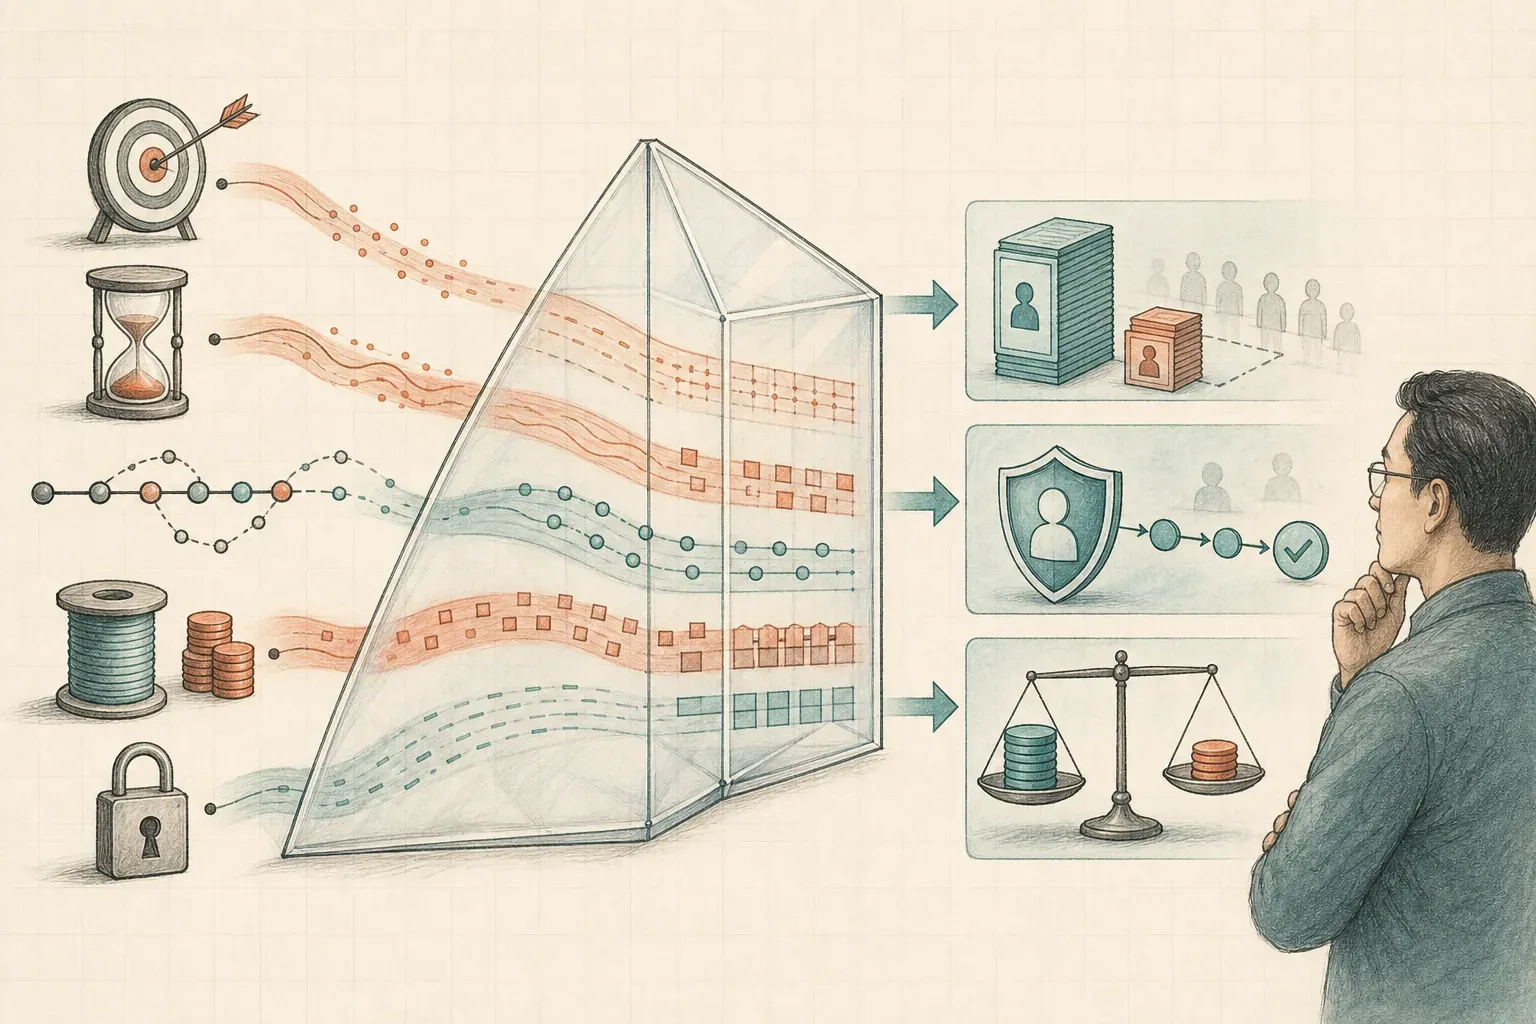
Technical lead 另一項花時間的工作,是把工程指標翻成業務能拿來做決策的資訊。
業務主管不在乎你用了 multi-agent 還是 RAG、reranking 調了什麼參數。他們在乎的是:
- 這東西能幫我們省多少時間 / 多少人力?(workflow impact)
- 它出錯的風險有多大、你怎麼控制?(risk control)
- 投入這些工程,回報是什麼?(ROI)
和主管討論時,可以把第 11 篇的治理說成「怎麼避免客戶資料外洩」,把第 9 篇的 eval 說成「怎麼知道品質有沒有下降」,再把第 10 篇的成本換成每月支出與節省工時。技術沒有變,只是換成對方能做預算和風險判斷的說法。
這一步做不好,專案即使技術上有效,也可能因為價值說不清楚而拿不到下一輪資源。
舉個翻譯的範例感受一下落差。技術版:「我們把 reranking 換成 cross-encoder,top-5 命中率上升、p95 latency 控制在兩秒內。」業務版:「客服 agent 第一次就答對的比例從六成拉到八成五,每天攔下大約三百通本來要轉真人的詢問,模型成本一個月小幾萬、省下的客服工時遠大於這個數。」——同一件事,後者才換得到下一輪預算。重點不是把數字講大,是把它放進主管的損益表裡。
在不確定裡帶人
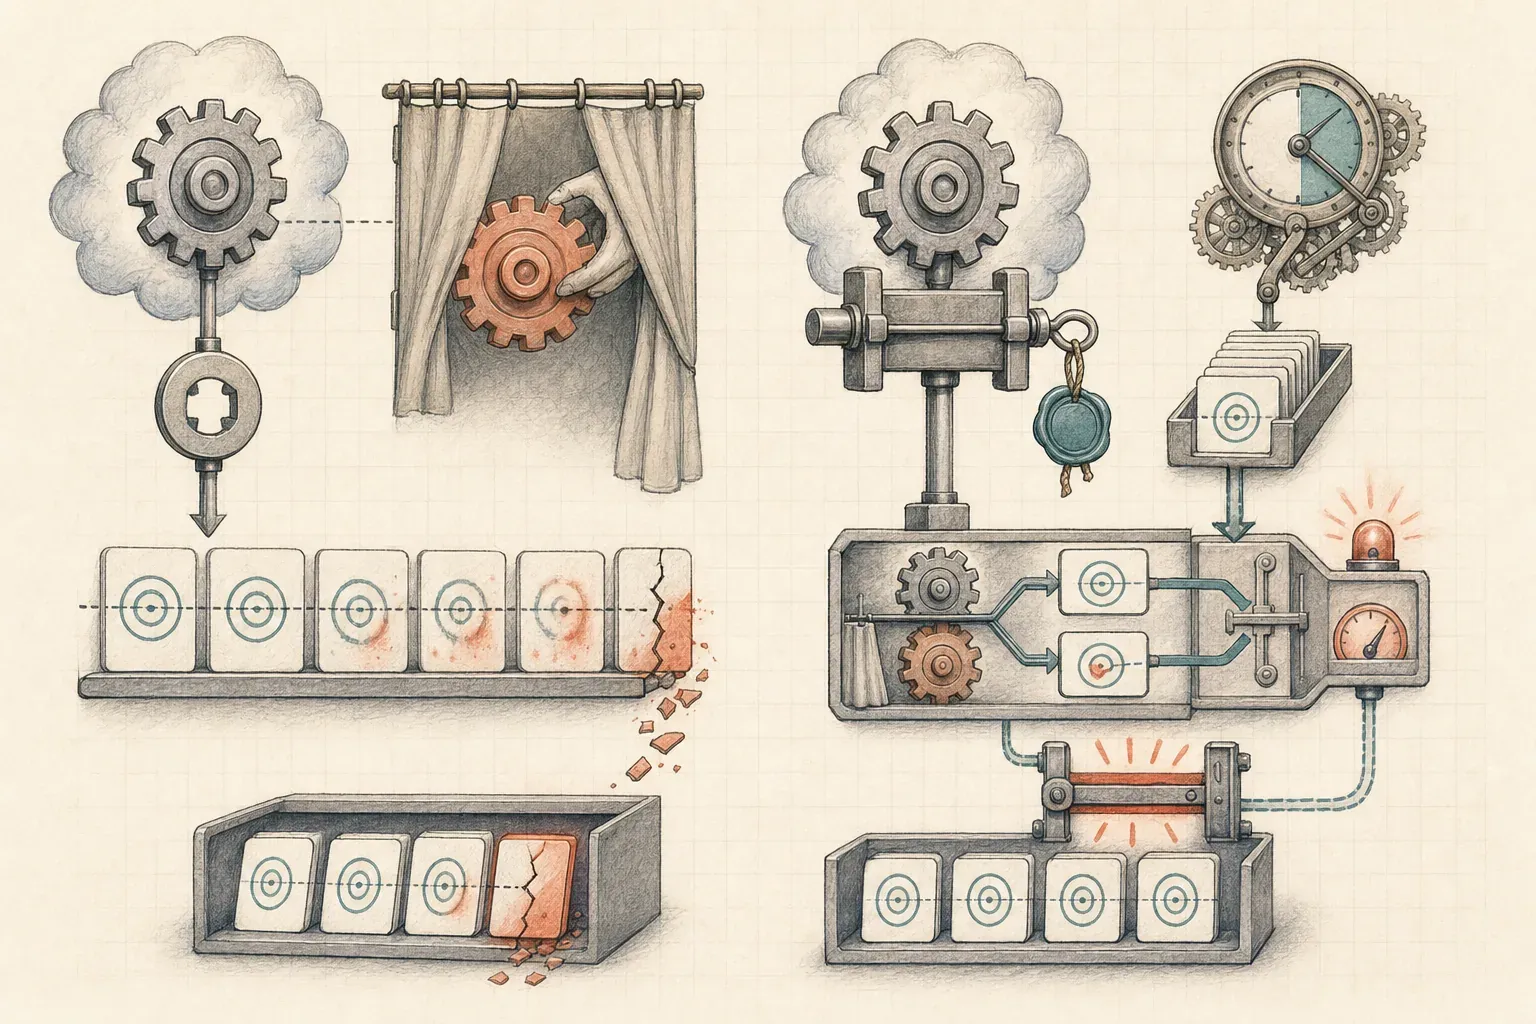
最後,AI 工程有個特別的領導挑戰:這個領域本身充滿不確定。模型會被供應商偷偷改、某個做法下個月可能就過時、沒有人是「專家」因為大家都在同一條起跑線附近。
其中「模型被供應商偷偷改」這件事,不只是領導氛圍問題,是 production 風險:同一個 model 名稱、同一段 prompt,供應商一次安靜的更新就可能讓行為飄掉——這正是第 1 篇講的,你有一個不能控制、也不會收到 changelog 的上游依賴。對小隊的紀律是兩條:版本能 pin 就 pin(別只寫 latest),以及讓黃金題庫定期重跑而不是只在改 code 時跑——這樣模型悄悄變了,是你的 eval 先尖叫,而不是客戶先尖叫。
帶這樣的團隊,我覺得幾件事重要:
- 建立心理安全感:在一個沒有標準答案的領域,要讓團隊敢說「我不確定」、敢做實驗、敢承認某條路走不通。eval 和 observability(第 9 篇)在這裡有個額外好處——它們讓「對或錯」有數據可依,而不是靠誰嗓門大,這本身就降低了團隊的焦慮。
- 知識共享是團隊資產:一個人踩過的坑、調出來的好 prompt、學到的新工具,要有機制讓它變成團隊的,而不是鎖在某個人腦裡。寫下來、分享出來——這也是我自己一直在做的事(這整個系列就是)。
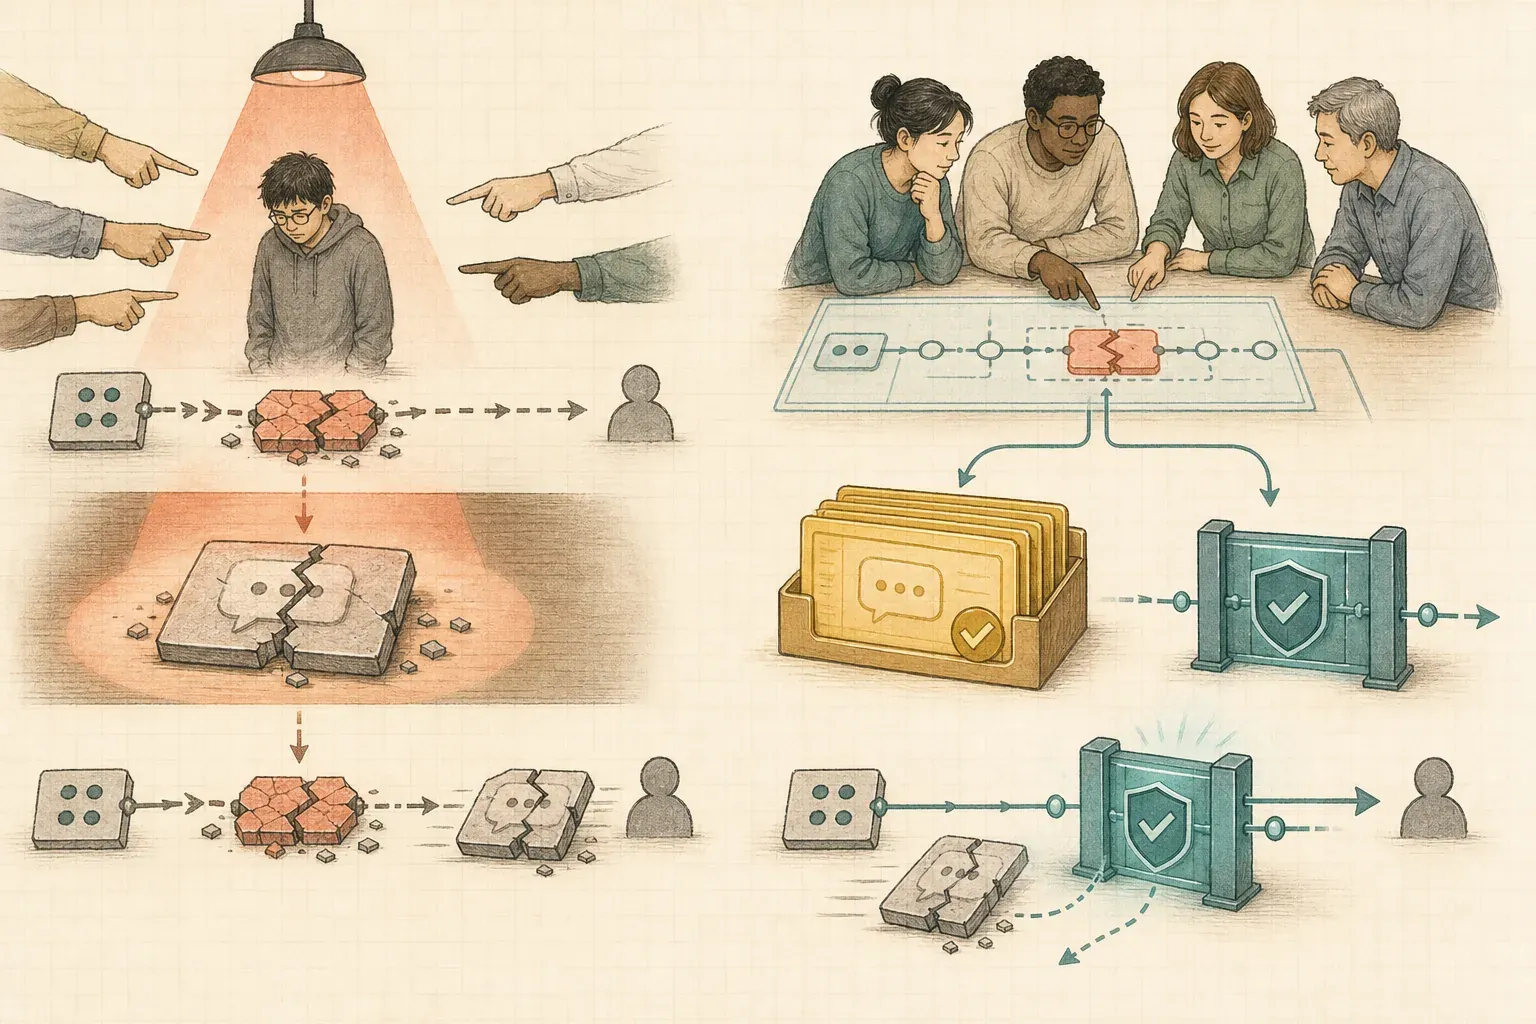
- postmortem 不咎責:agent 出包了,重點是「系統哪裡讓這個錯誤溜過去了、怎麼補上防線(補進黃金題庫、加個 HITL 關卡)」,而不是「誰的 prompt 寫爛了」。判斷一場 postmortem 有沒有做對,看它的產出物:每一次線上出包,至少要長出一條新的黃金題庫或一道新的關卡——讓同一個錯誤下次過不了。沒長出防線的檢討,只是一場集體嘆氣。
回到第 1 篇:六道鴻溝,其實是一支團隊的事
這個系列從「企業 AI Agent 為什麼卡在 PoC」開始,談了六個常見問題:正確性、eval、可觀測性、權限治理、成本延遲和 fallback。
走到最後會發現,六個問題都各自需要一套團隊習慣,光靠某位工程師一次補完並不持久。
- 正確性與權限 → 是不是有 architecture / eval review 把關?
- Eval 與可觀測性 → 是不是有「沒過不能上」的文化?
- 成本與治理 → 是不是有人能把它翻譯成業務聽得懂的價值,換到持續投入的資源?
工具和架構能解決眼前問題,長期維護仍要靠團隊固定執行 review、eval、觀測與事故回顧,也要有人把技術結果說成業務能理解的影響。
如果你正準備把一個 agent 從 demo 推向正式使用,希望這 12 篇能當成一份檢查清單,也少繞一些我已經踩過的路。
文章簡報


延伸閱讀
- 上一篇:Agent 治理框架
- 系列起點:企業 AI Agent 為什麼卡在 PoC?
- Agentic Engineering 實戰手冊——換個角度:用 agent 來做工程,而不是打造 agent 系統
- Agentic Engineering:團隊導入——把 agent 工作流導入一支團隊的實戰