AI agent 的延遲、可靠性與成本,該怎麼取捨?
本篇是「從 PoC 到 Production:企業 AI Agent 系統工程」系列的第 10 / 12 篇。你可以從系列總覽開始閱讀,也可以直接接著看本文。
這是「從 PoC 到 Production:企業 AI Agent 系統工程」系列第 10 篇(共 12 篇)。上一篇:生產級 LLM 的評估與可觀測性。
前面提到的設計到了正式環境都會反映在數字上。RAG 多撈幾份文件、reranking 多一次模型呼叫、multi-agent 多跑幾個角色、失敗時再 retry,每一步都會增加時間或費用。
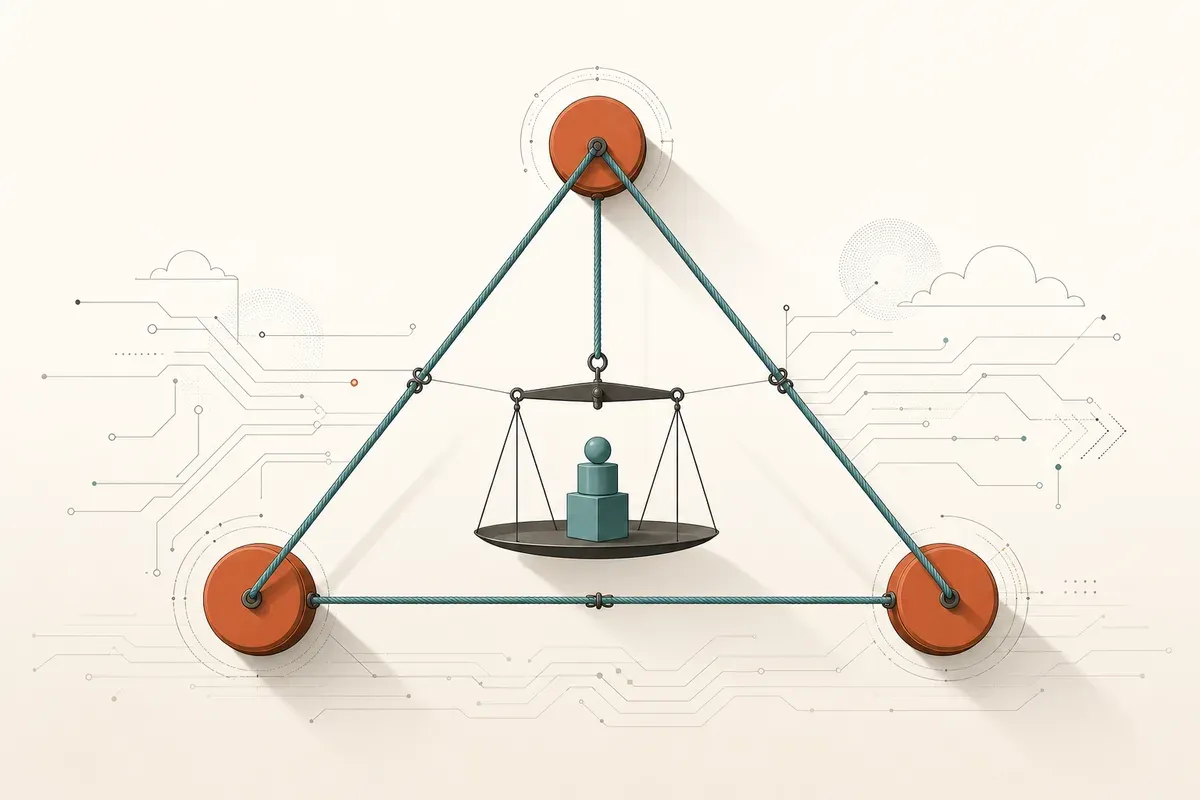
延遲、可靠性和成本通常會互相牽制:
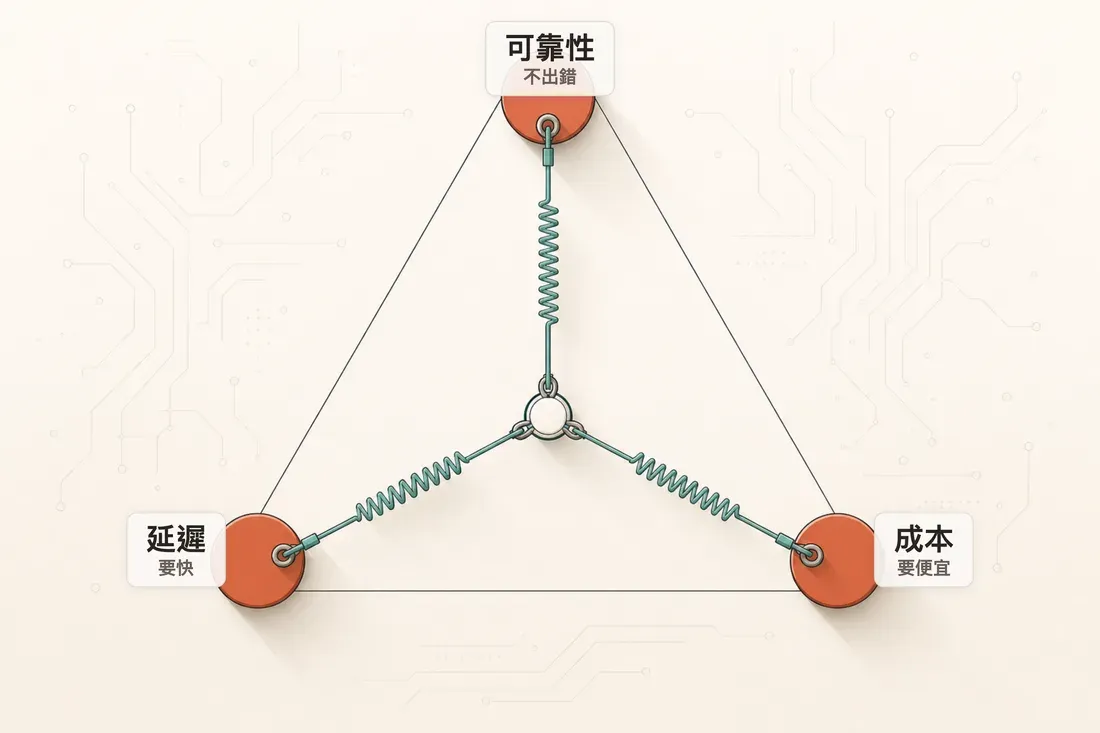
可靠性、延遲、成本互相拉扯的鐵三角:靠近任一角,另外兩角就被犧牲——三者無法同時拉到極致。
- 想可靠 → 加 retry、加 fallback、用更強的模型 → 變慢、變貴。
- 想便宜 → 用小模型、少檢索、少 reasoning → 品質和可靠性下降。
- 想快 → 砍 reasoning、激進 cache、少檢索 → 可能犧牲正確性。
三項很難同時做到最好。設計前先決定這個功能最在乎哪一項,通常比上線後再被帳單或延遲逼著改來得便宜。
下面的手段大多來自既有的後端與分散式系統經驗,只是套用到模型呼叫上。
延遲:先區分「真延遲」和「感知延遲」
LLM 天生慢,一個複雜回答跑好幾秒是常態。但使用者體感的「慢」,跟實際耗時是兩回事。
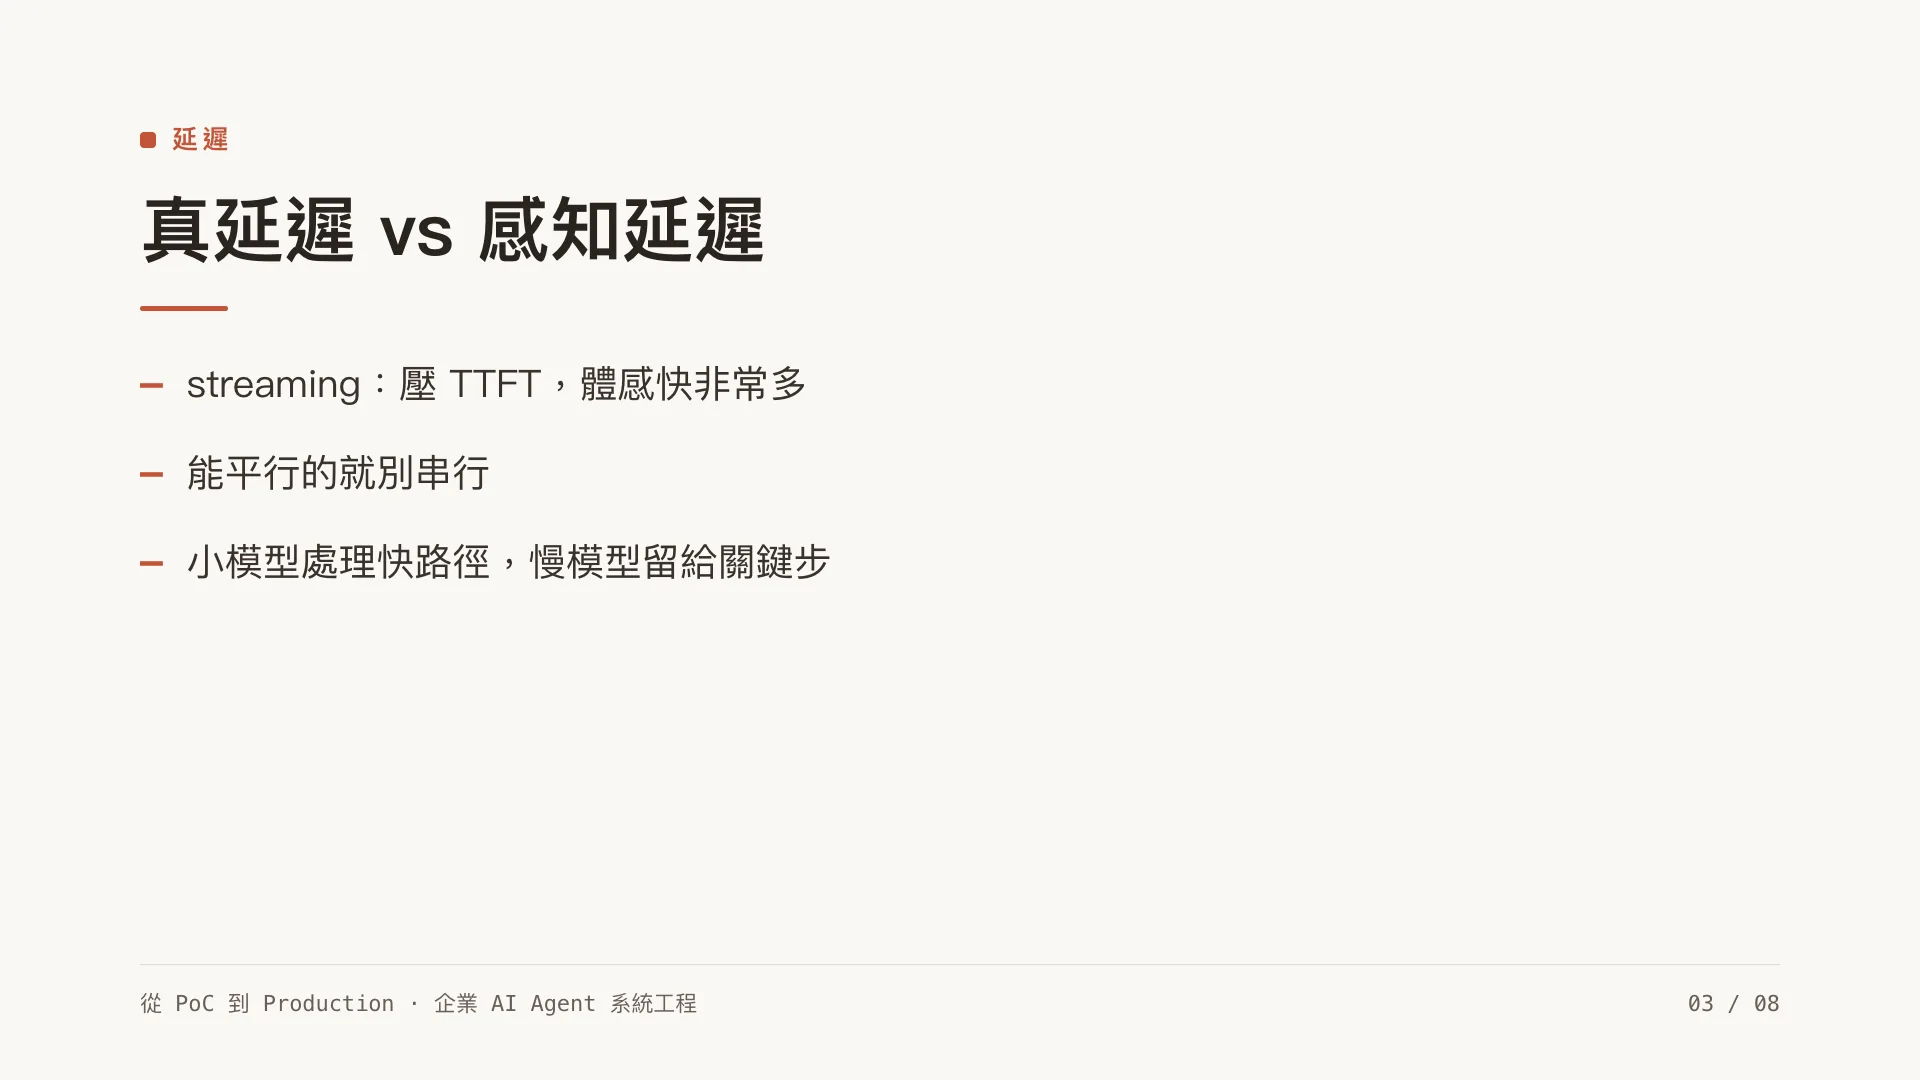
1. Streaming(串流)先改善等待感。 不要等完整答案生成後才一次回傳,讓使用者先看到前幾個字。總耗時雖然沒變,等待感受會差很多。工程上主要看 TTFT(Time To First Token,首 token 延遲),串流開始後順不順則看 TBT(token 之間的間隔)。聊天介面可以把兩者分開放進第 9 篇的 dashboard,而不是只留一個籠統的總回應時間。
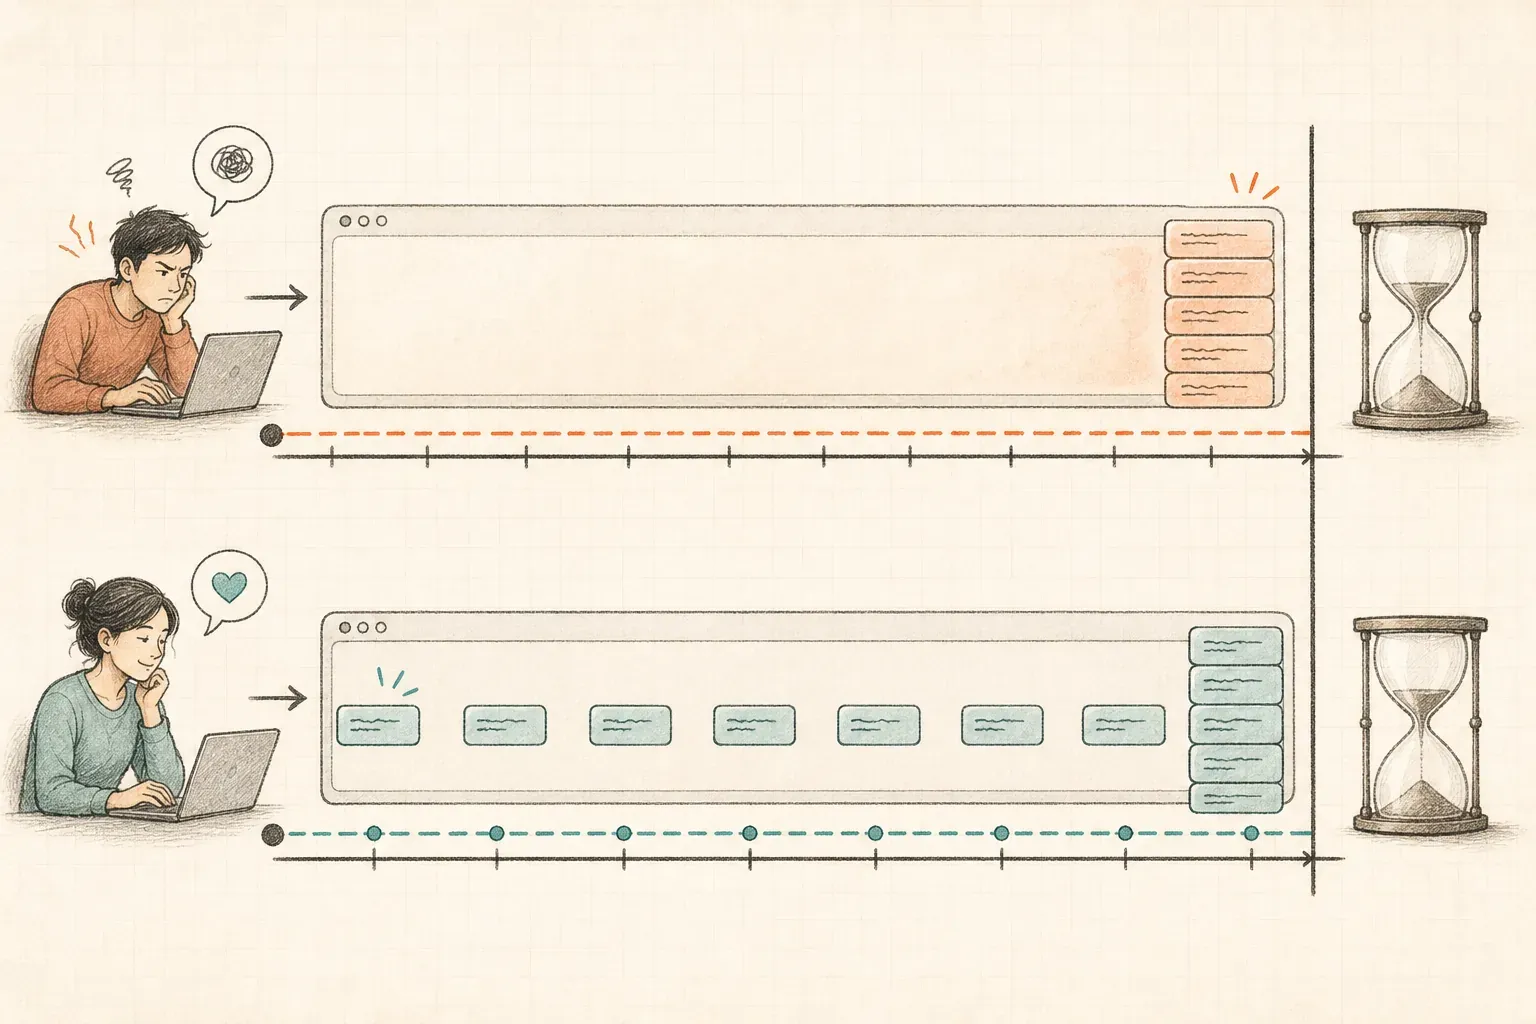
2. 把能平行的就別串行。 如果一個任務要檢索三個不同來源,讓它們同時跑,而不是一個等一個。Agent runtime(第 2 篇)要支援這種平行。這是基本的並行思維,跟你優化任何後端流程一樣。
3. 用小模型處理快路徑。 不是每一步都要動用最強最慢的模型(下面 model routing 細談)。意圖分類、簡單抽取用快的小模型,把慢的大模型留給真正需要的那一步。
可靠性:為「外部依賴一定會出包」設計
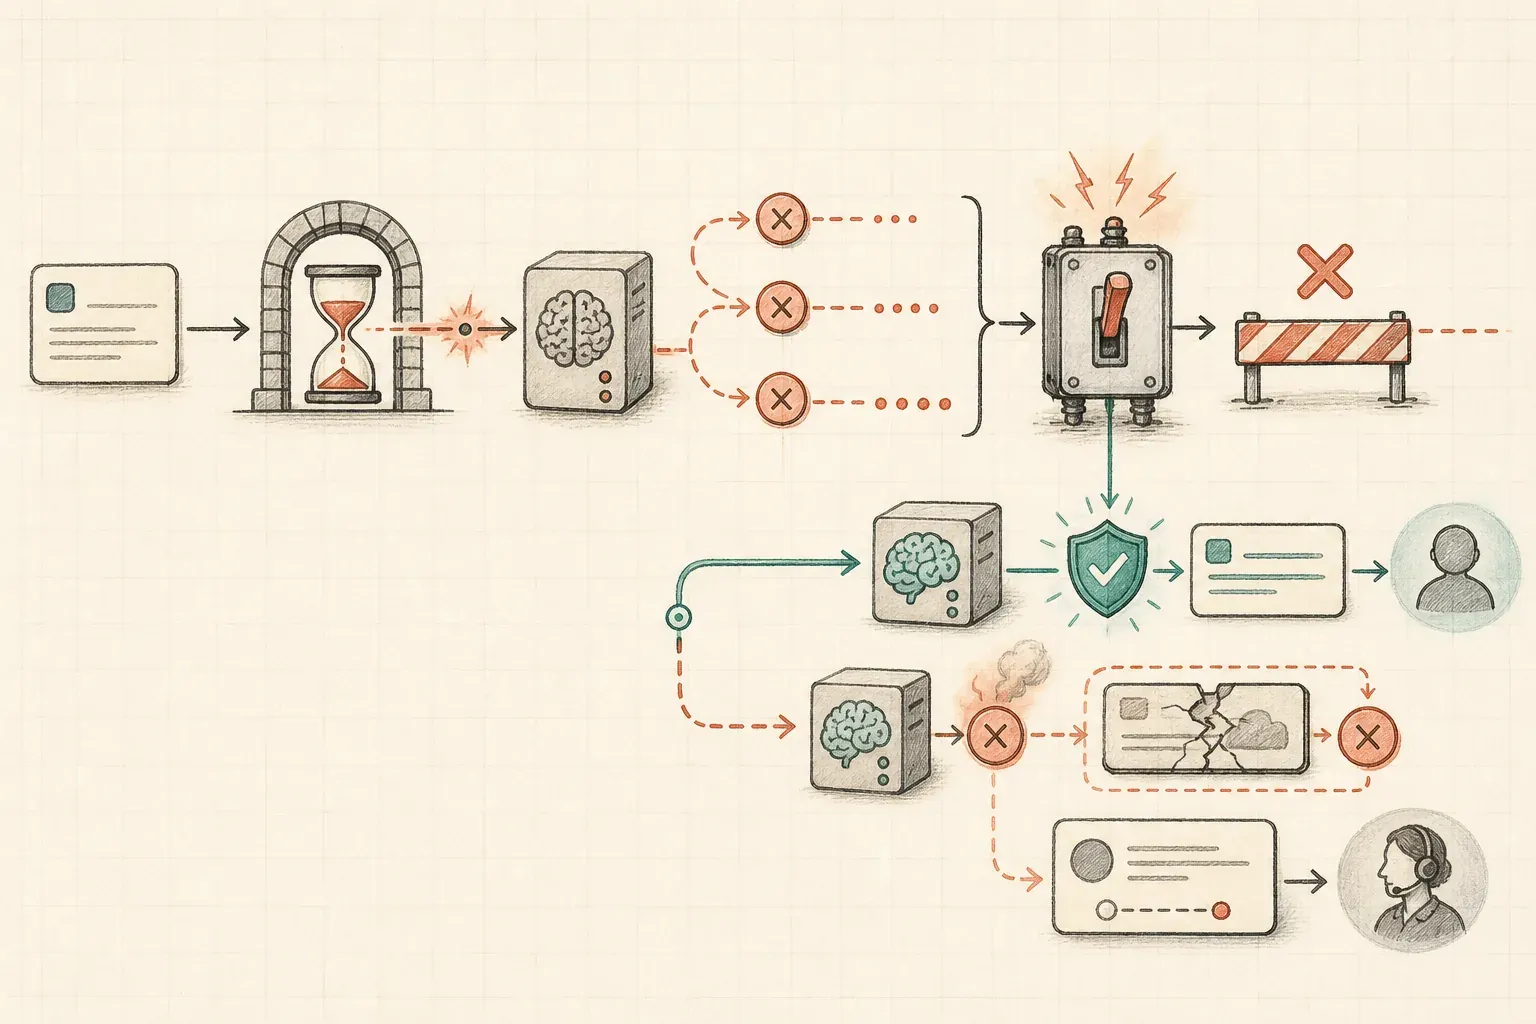
Agent 依賴外部 LLM API,而外部服務本來就可能逾時、限流、回傳異常內容或暫時中斷。處理方式和其他外部依賴很接近:
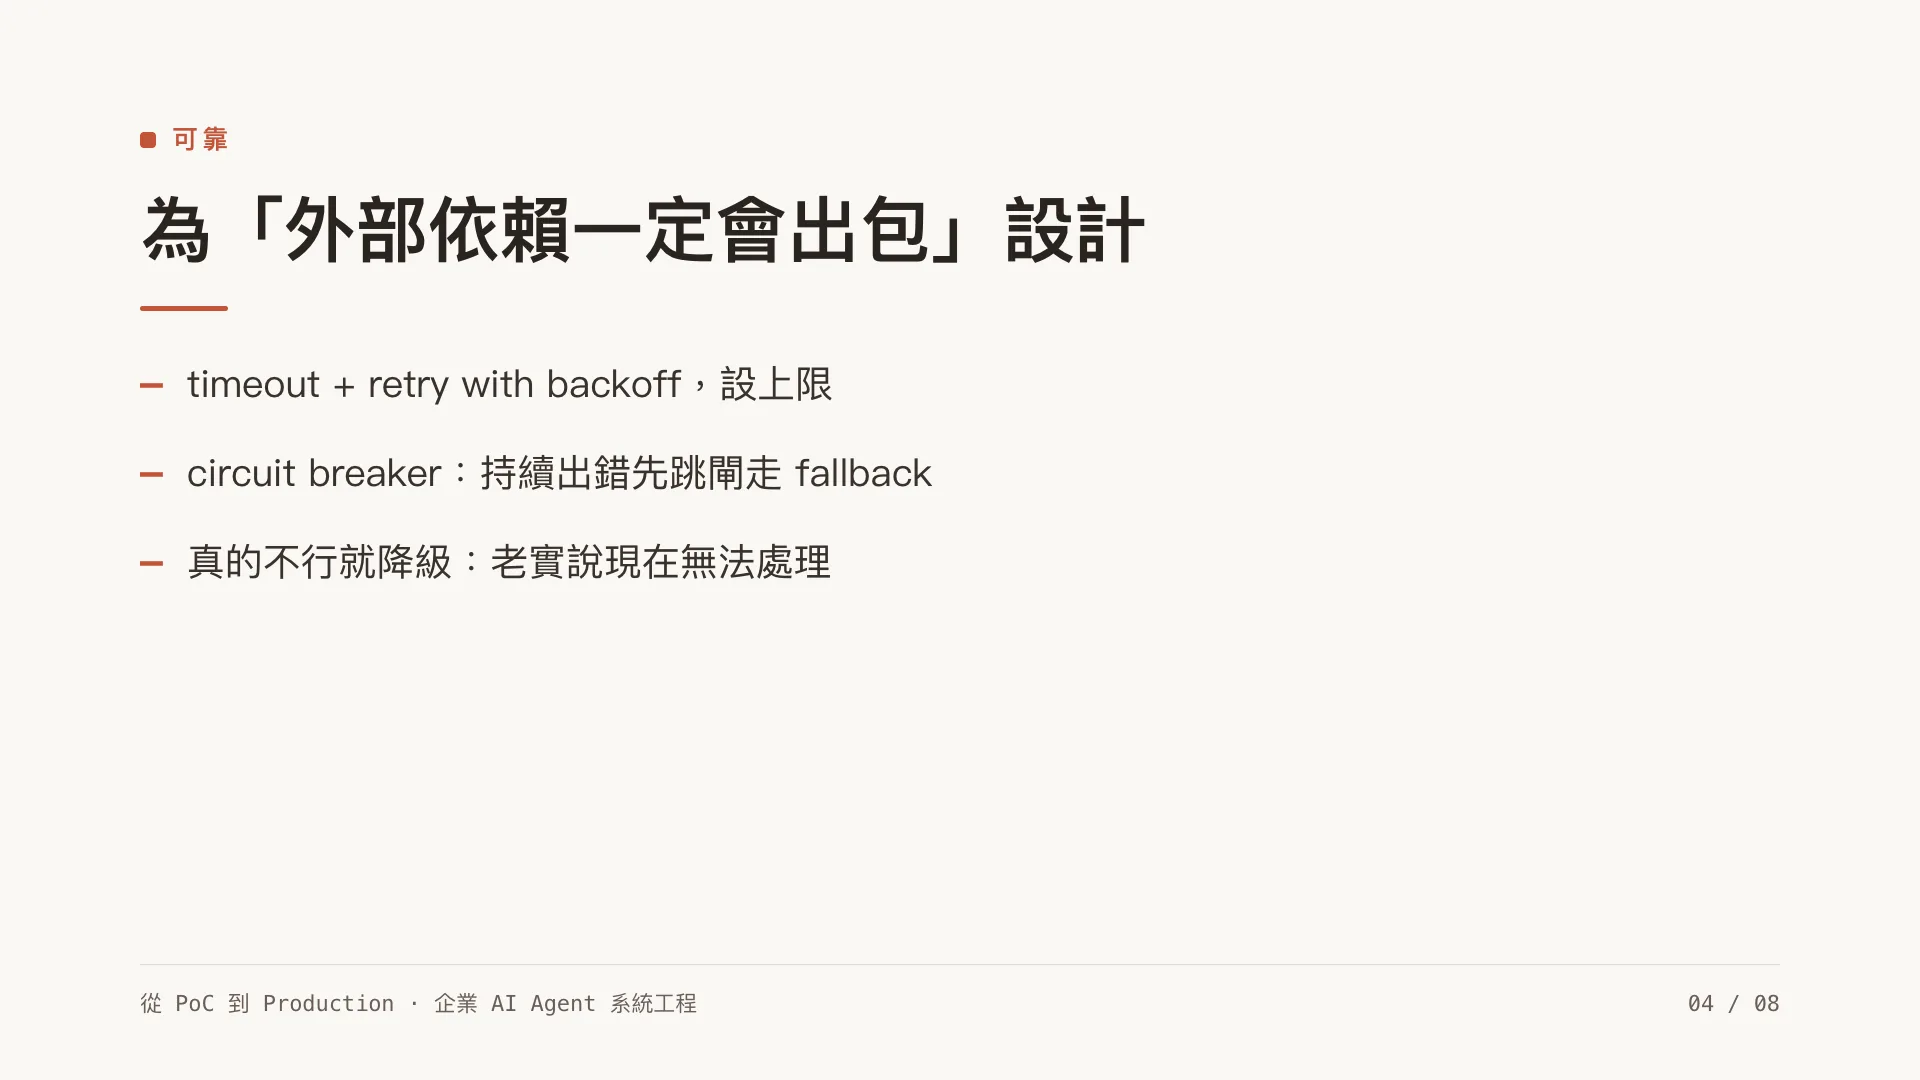
- Timeout:每次模型呼叫設合理逾時,別讓使用者無限等。
- Retry with backoff:暫時性錯誤(限流、逾時)重試,但要退避、要設上限,別把對方打更慘、也別自己燒爆 token。
- Circuit breaker:某個模型 / 供應商持續出錯,先「跳閘」停止打它,走 fallback,給它時間恢復。
- Fallback model:主模型掛了或回垃圾,自動切備援(另一家供應商、或本地模型)。這也降低單一供應商的依賴風險。
- 降級(graceful degradation):真的都不行時,老實回「現在無法處理,請稍後或轉人工」,而不是給一個爛答案。呼應第 1 篇的鴻溝六。
注意這裡的張力:每加一層可靠性(retry、fallback),通常就多一點延遲、多一點成本。所以要分場景——關鍵動作值得多付,邊緣功能不必。
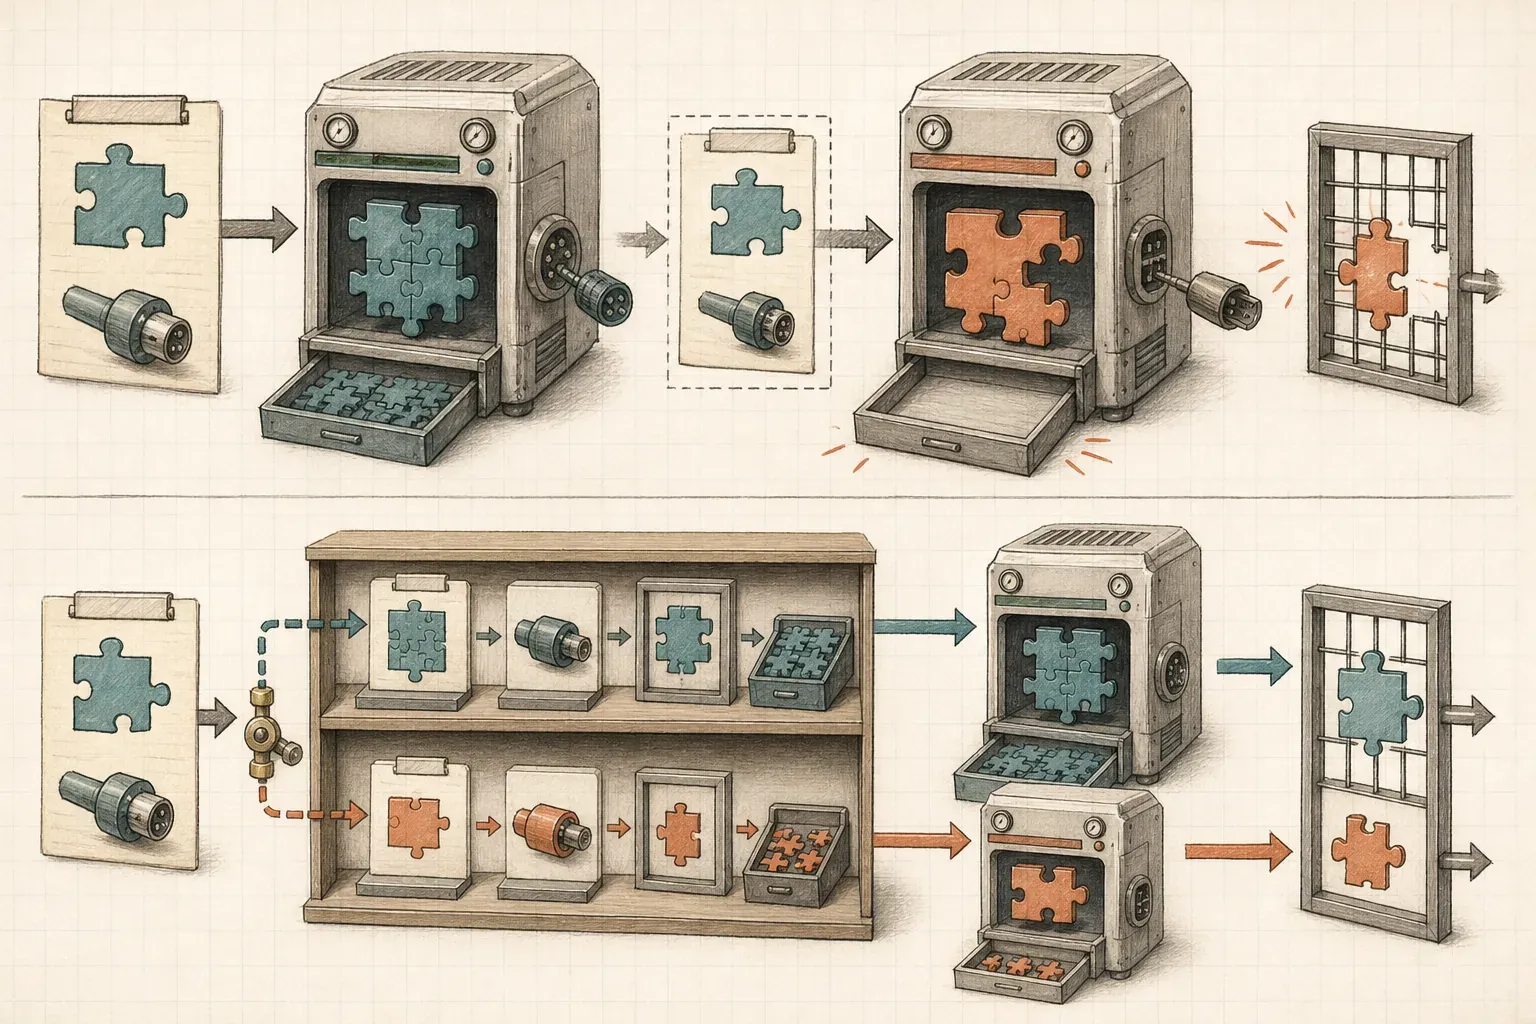
關於 fallback 還有個坑要先講:跨供應商 fallback 沒有「一鍵切換、行為一致」那麼無痛。同一段 prompt 在 GPT、Claude、Gemini 上的輸出風格、JSON 遵循度、refusal 行為都不一樣;tool calling 的 schema 各家也不同;更別說等下要講的 prompt caching 是供應商綁定的——切到備援那一刻,前面省的快取全部失效,延遲跟成本反而往上跳。實務上只有兩條路:為主 / 備各自維護一套 prompt 與 parser,或把備援路徑當成「可接受的降級」來設計。別假設換家供應商,行為會一樣。
成本:LLM 系統獨有的「浮動帳單」
傳統服務成本相對固定(機器開著就那樣)。LLM 系統的成本是按 token 浮動的,而且會悄悄長大。第 9 篇我們已經把成本監控起來了,這篇講怎麼壓。
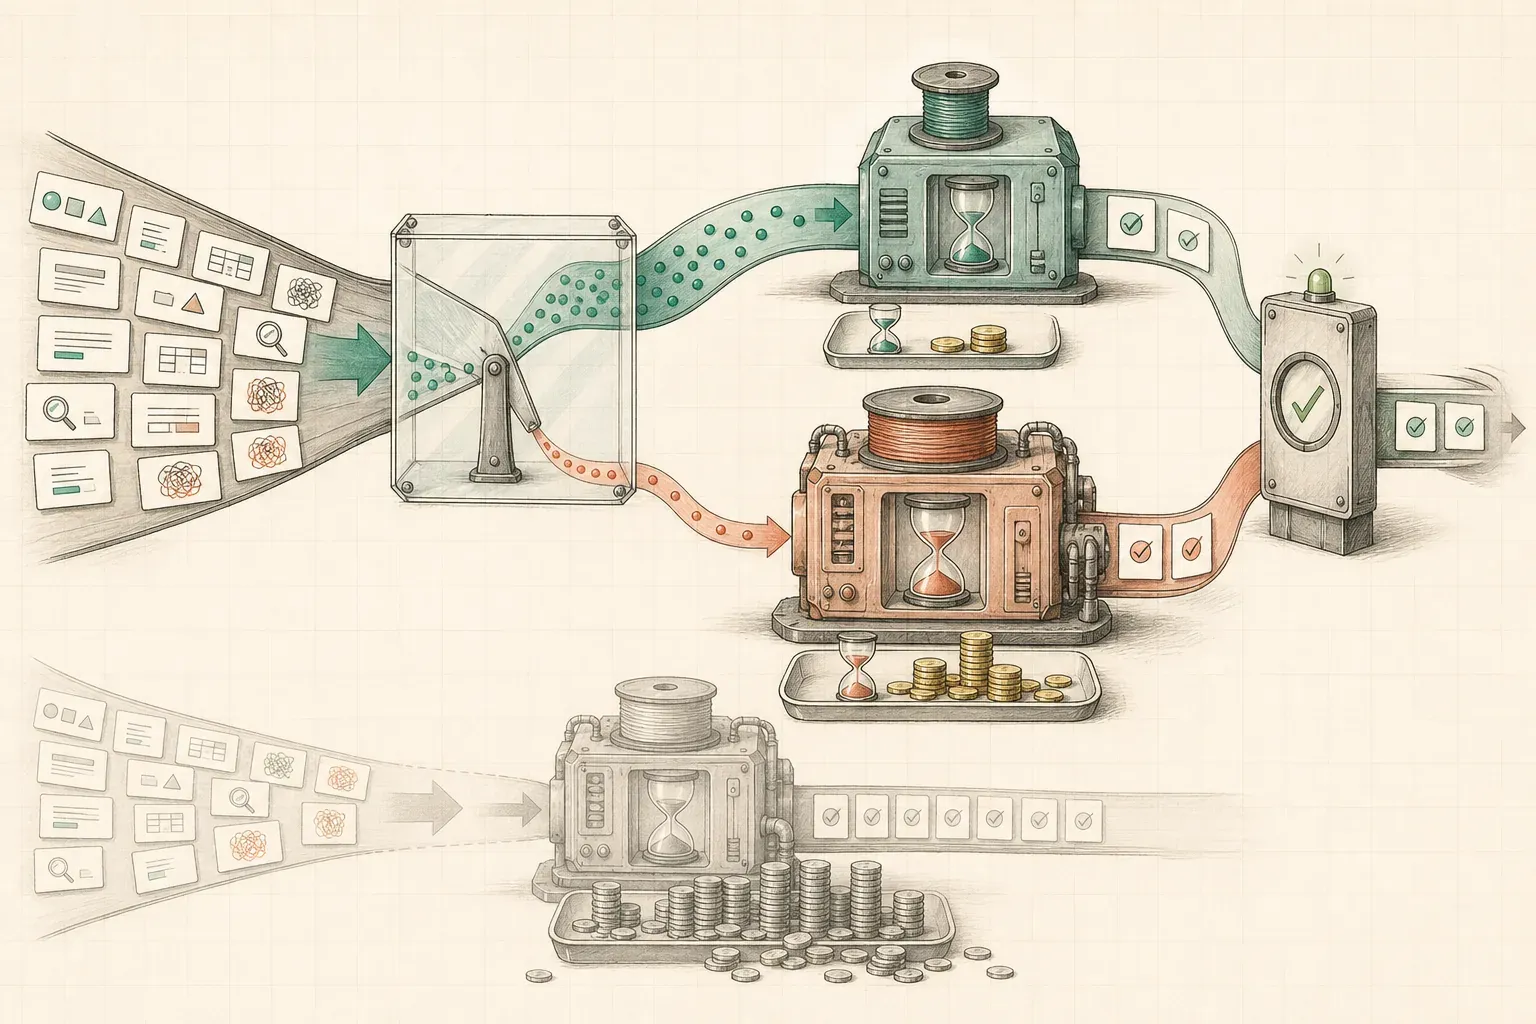
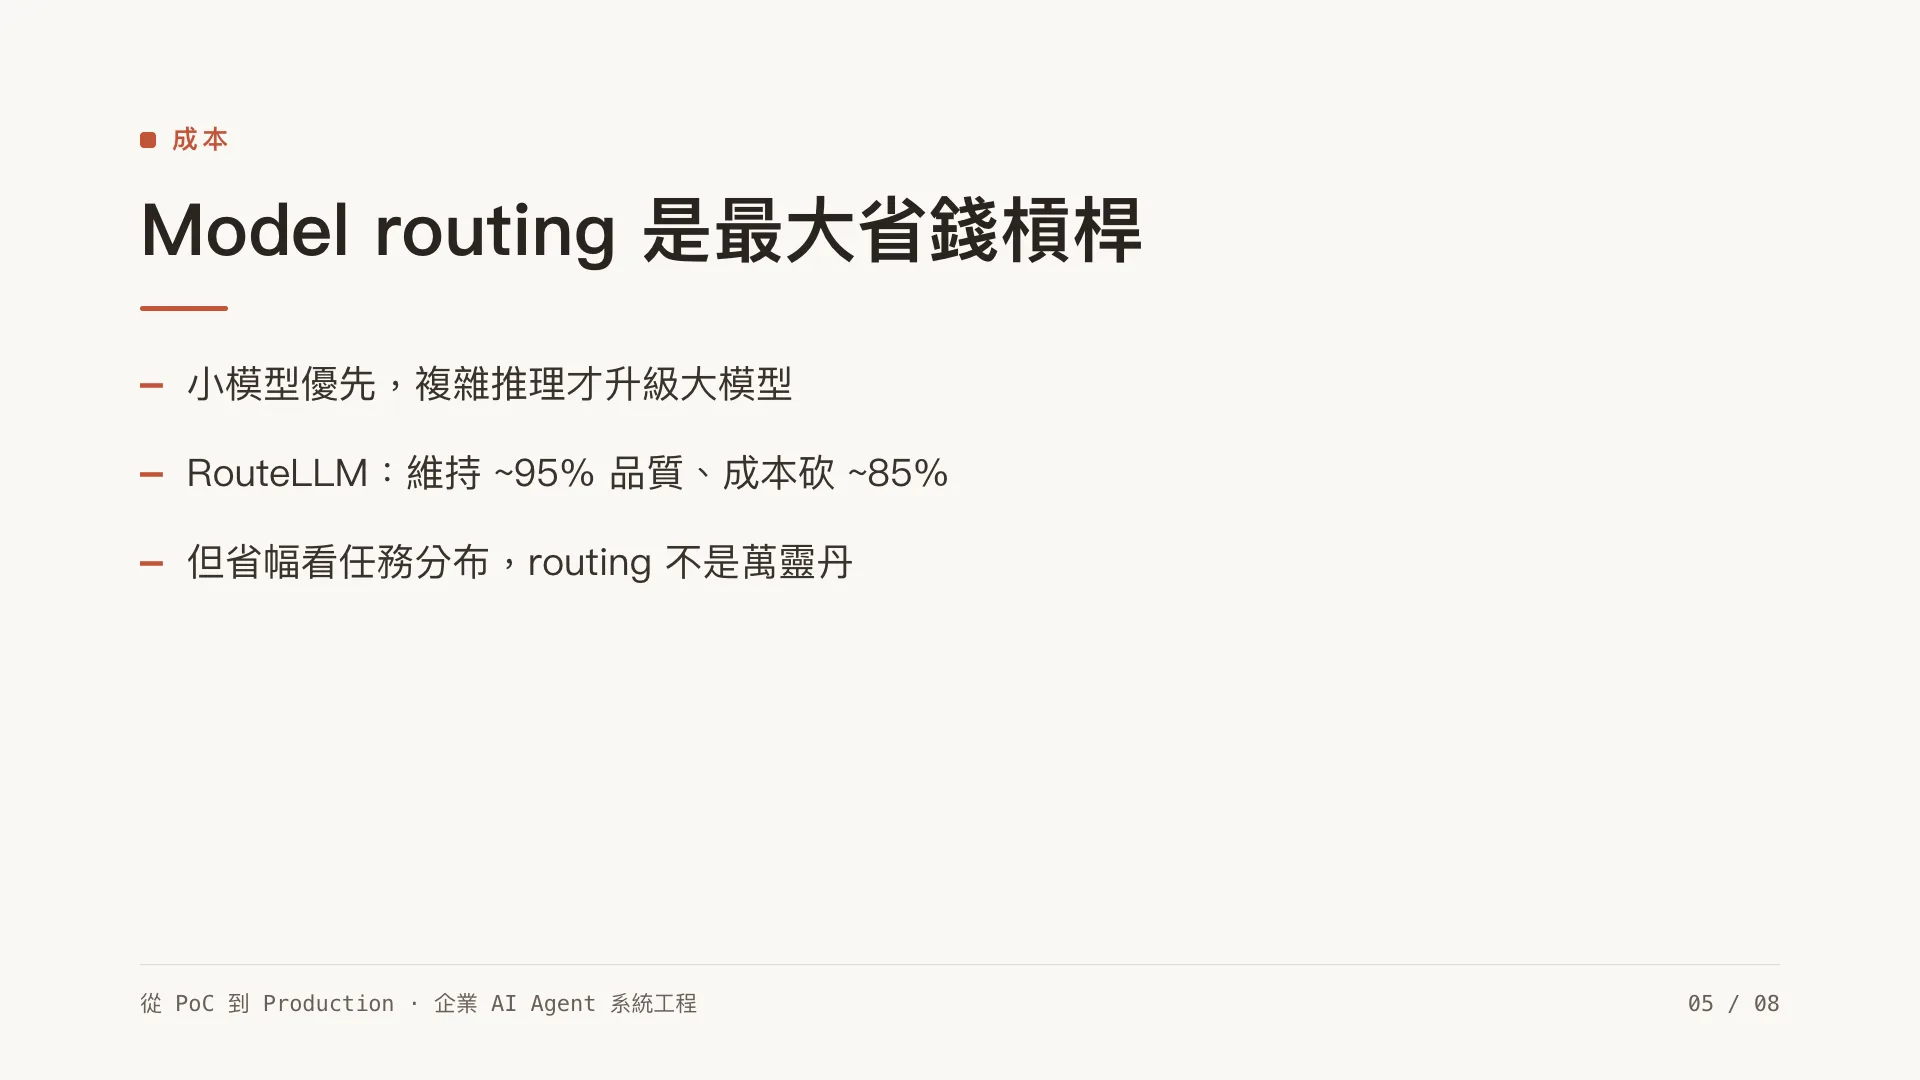
1. Model routing:小模型優先,必要才升級。 這是最大的省錢槓桿。把「要用哪個模型」抽成一層(第 2 篇的 Model Router),依任務難度路由:
- 分類、抽取、格式轉換、簡單問答 → 便宜小模型
- 複雜推理、需要高品質的最終生成 → 大模型
先把分類、抽取這類不需要複雜推理的工作移到小模型,通常就能明顯降低成本。至於品質是否真的沒有受影響,仍要用第 9 篇的題庫確認。
有多大?拿 RouteLLM(UC Berkeley / Anyscale / Canva,ICLR 2025)的公開 benchmark 當參考:在偏對話的 MT-Bench 上,它能維持約 95% GPT-4 品質、成本卻砍掉約 85%。但別把這 85% 當保證值——同一個 router 換到偏推理的 benchmark,省幅就掉很多(MMLU 只省約 45%)。所以 routing 的省幅,本質上等於你流量裡「不需要大模型的那一塊」有多大:先量你自己的流量分布,再決定能省多少,別套別人的數字。
2. Cache:能不重算就不重算。
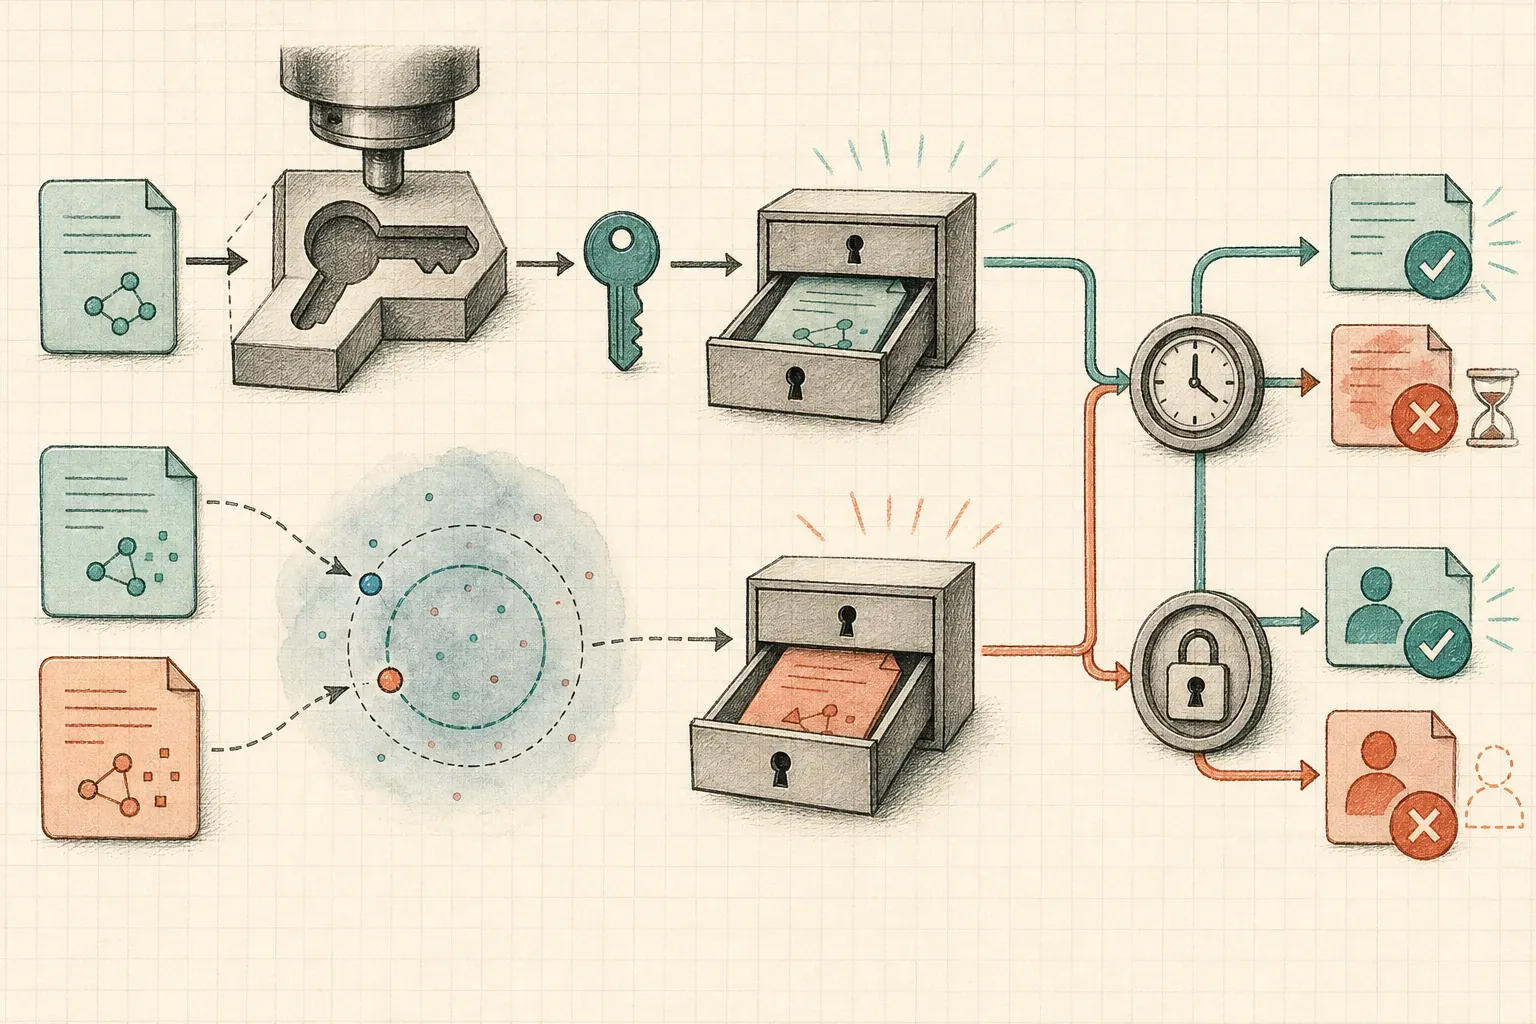
- 結果快取:這裡其實藏了兩種完全不同難度的東西。Exact cache(把 query 正規化後當 key,同樣的問題回同樣的答案)幾乎零風險、該最先做;semantic cache(用 embedding 相似度命中「相似」問題)能多抓改寫過的重複,但有 false-positive 風險——兩個在向量空間很近的問題可能需要完全不同的答案,而且對的命中跟錯的命中相似度高度重疊,沒有通用安全閾值,閾值要訂多嚴取決於「答錯的代價」。生產數據也顯示 semantic cache 相對 exact 往往只多 5~8 個百分點命中率,未必抵得過它的複雜度與答錯風險。高風險場景就乖乖用 exact。(兩種都要注意時效和權限,別把 A 使用者的答案快取給 B。)
- Embedding 快取:同一段文字別重複 embedding。
- Prompt 快取:把穩定的內容(system prompt、few-shot 範例、長 context)放最前面、把每次都變的部分放最後,讓固定前綴可以被快取重用。但 2026 三家機制不一樣,這差異直接決定你有沒有真的省到:OpenAI、Gemini 是自動命中(前綴 ≥ 1,024 token 重複就生效,讀取省 50~90%、寫入不收費);Anthropic 是顯式 opt-in,你得在 request 裡標
cache_control斷點,cache read 只要基礎 input 價的約 0.1 倍(省 ~90%),但 cache write 要付約 1.25 倍溢價、預設 5 分鐘 TTL——換句話說 Claude 的快取要至少命中一次才回本。用 Claude 卻忘了標cache_control=你以為在省錢、其實一毛沒省,這是這招最常見的踩雷。
三種快取裡,prompt 快取最容易「以為做了但沒省到」,因為省不省錢的分岔不在你的程式碼,而在供應商的機制。把這條路徑攤開來看:
flowchart TD
    A["穩定內容放最前面<br/>每次變動的放最後"] --> B{"用哪家供應商?"}
    B -->|"OpenAI / Gemini"| C["自動命中<br/>前綴 ≥ 1024 token<br/>重複就生效"]
    C --> D["讀取省 50~90%<br/>寫入不收費"]
    B -->|"Anthropic"| E{"有標 cache_control<br/>斷點?"}
    E -->|"沒標"| F["以為在省錢<br/>其實一毛沒省"]
    E -->|"有標"| G["cache write 付<br/>約 1.25 倍溢價<br/>預設 5 分鐘 TTL"]
    G --> H{"TTL 內至少<br/>命中一次?"}
    H -->|"有"| I["cache read 約 0.1 倍<br/>基礎 input 價<br/>省 ~90%"]
    H -->|"沒有"| J["只付了寫入溢價<br/>沒回本"]
圖右下那條「有標但沒命中」的路徑值得記住:Claude 的快取寫入是要加價的,所以它不是「開了就穩賺」,而是至少命中一次才回本——低頻、長尾的請求標了反而更貴。
3. 管好 context 長度。 Token 成本跟 context 長度直接相關。第 7 篇講的記憶截斷 / 摘要、第 3 篇講的別塞太多 chunk,到這裡全都變成「省錢」的具體手段。把不必要的東西塞進 context,是最常見的浪費。
4. 設預算護欄。 單一請求、單一使用者、單一 multi-agent 任務(第 8 篇的成本爆炸風險)都要有 token / 花費上限。撞到上限就停下來或降級,別讓一個失控迴圈燒出一張嚇人的帳單。
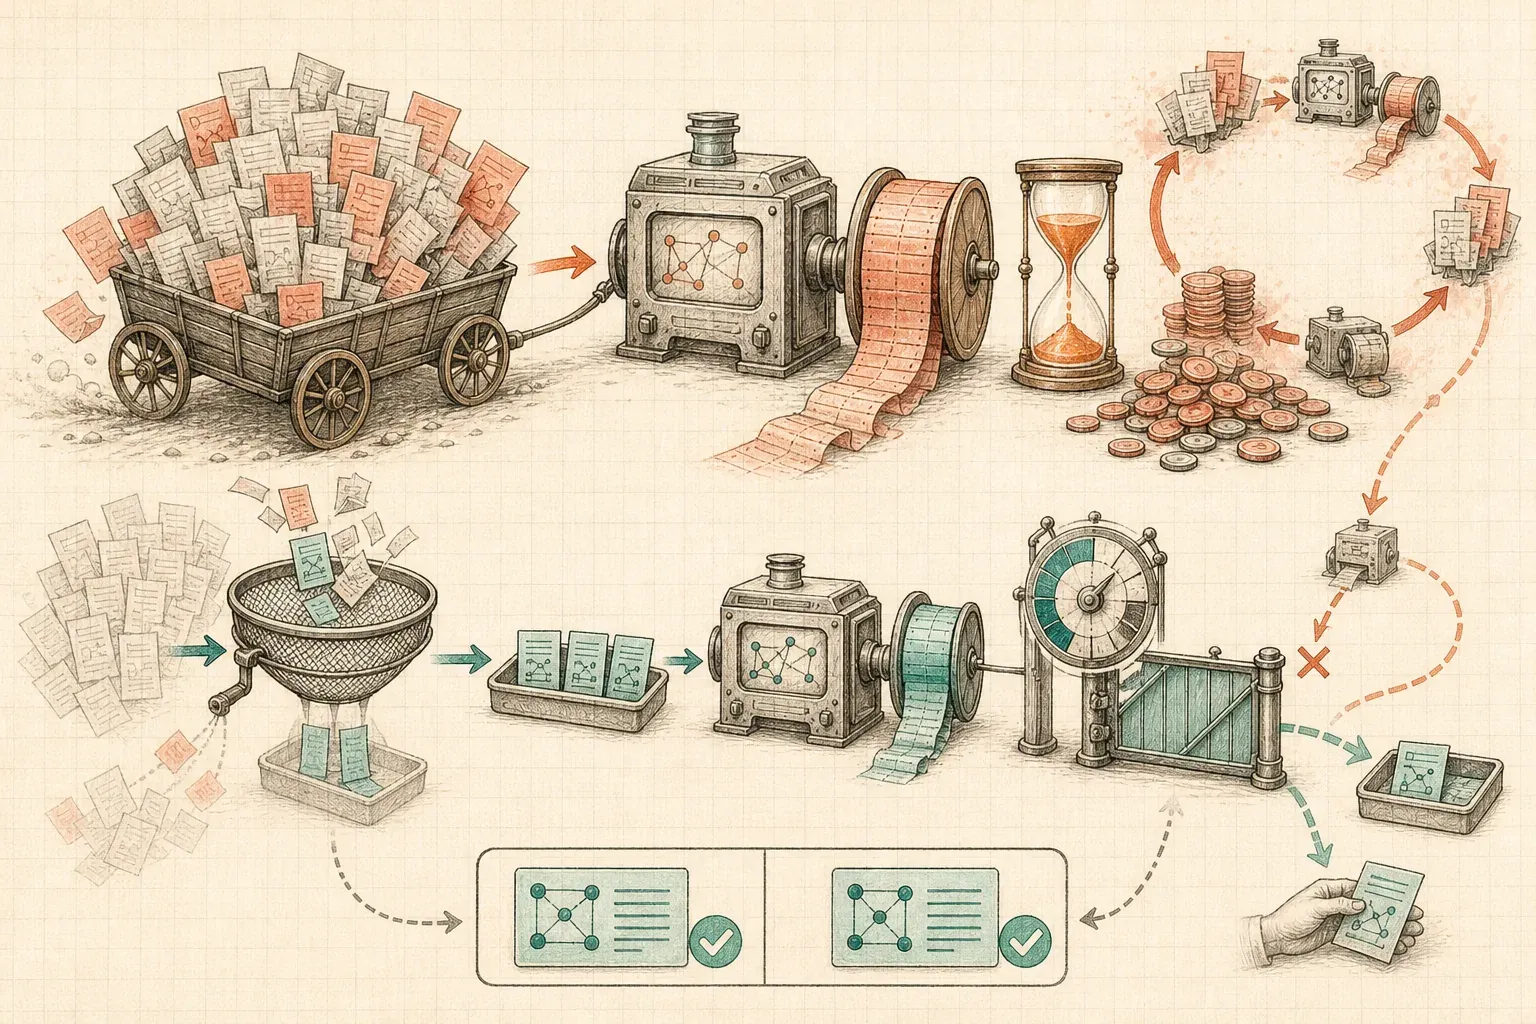
我以前做 K8s 叢集的雲端成本優化,也是先把花費拆開來看,再從占比最大的地方下手。放到 agent 系統,只是觀察的單位從 CPU、記憶體換成 token 與模型呼叫。
把三角畫出來:依場景做取捨
最後給一個務實的框架。不同功能在三角上的位置不該一樣:
| 場景 | 優先 | 取捨 |
|---|---|---|
| 即時對話助理 | 延遲 | streaming、小模型快路徑、適度 cache,容忍偶爾要重問 |
| 高風險決策 / 報告 | 可靠 + 正確 | 大模型、多檢索、critic 審查、HITL,接受慢和貴 |
| 大量批次處理 | 成本 | 小模型、激進 cache、可離線慢慢跑,犧牲即時性 |
| 內部低頻工具 | 成本 + 簡單 | 別過度工程,能跑就好 |
這張表不用背。設計功能時只要先問清楚:它最不能犧牲的是速度、可靠性,還是成本?有了優先順序,後面的模型、快取和 retry 才知道該怎麼選。
小結
- 延遲、可靠性、成本是會互相打架的鐵三角,不可能三個都極致。
- 延遲:streaming 降感知延遲、平行化、小模型走快路徑。
- 可靠性:把 LLM API 當「一定會出包的外部依賴」——timeout、retry、circuit breaker、fallback、降級。
- 成本:model routing 是最大槓桿,加上 cache、管好 context、設預算護欄。
- 每個功能依它在三角的位置刻意取捨,這份判斷力就是 production 系統工程師的核心價值。
這些方法都不是模型特有的新招,而是既有系統工程經驗換了使用對象。下一篇會把第 5、6、9 篇的權限、工具與觀測整理成一套 Agent 治理框架。
文章簡報
延伸閱讀
- 上一篇:生產級 LLM 的評估與可觀測性
- Agentic Engineering:成本優化——agent 工作流的 token 成本怎麼省
- 下一篇:《企業 AI Agent 治理:資料、權限、工具與持續監督》