Agent memory 與狀態管理:該記什麼,也要知道何時該忘
本篇是「從 PoC 到 Production:企業 AI Agent 系統工程」系列的第 7 / 12 篇。你可以從系列總覽開始閱讀,也可以直接接著看本文。
這是「從 PoC 到 Production:企業 AI Agent 系統工程」系列第 7 篇(共 12 篇)。上一篇:Tool use 與 MCP。
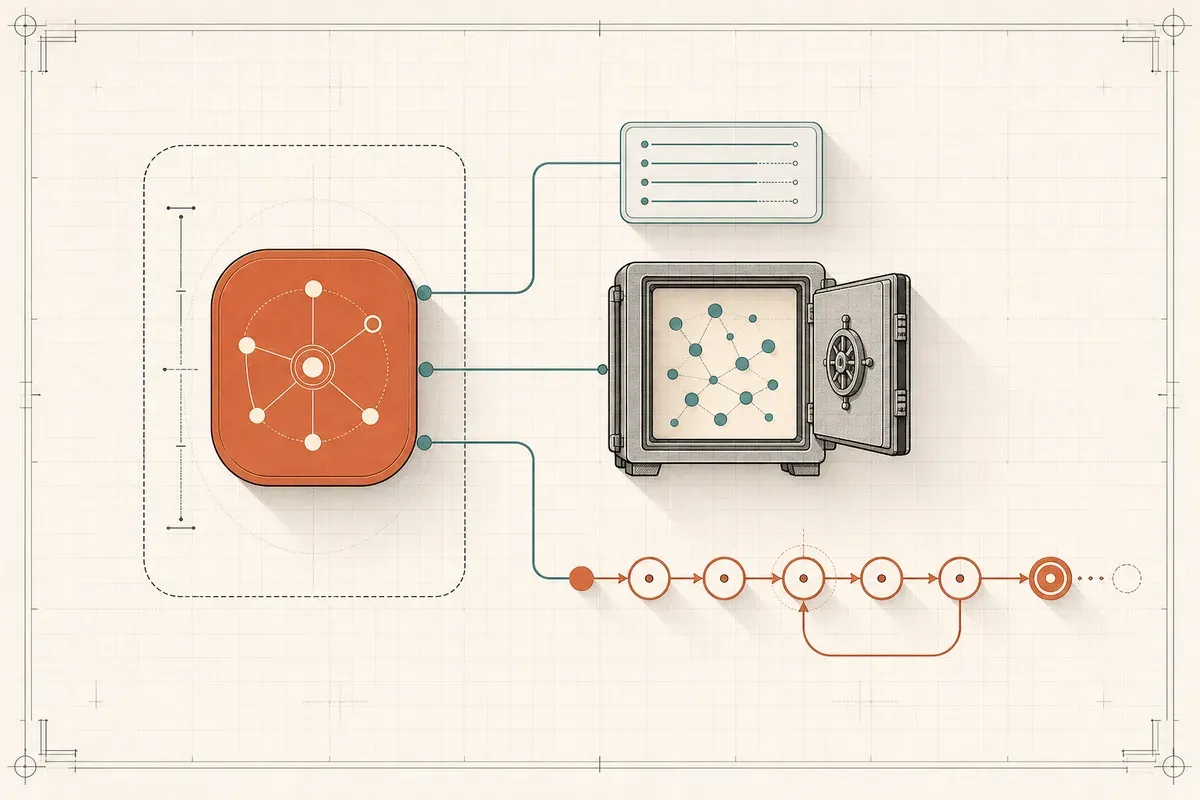
談 memory 之前,先把它和 retrieval 分開。兩者都會把資料放進 context,但保存的內容和用途不同。
- Retrieval(第 3–5 篇):去公司的知識庫找「客觀的、共用的知識」。產品規格、SOP、法規——這些不屬於任何一個對話。
- Memory(這篇):記住「這個使用者、這個任務」的脈絡。他剛剛問過什麼、他偏好什麼、這個任務做到哪一步、試過哪些路。
如果兩者混在一起,很容易出現該記的沒留下、不該共用的卻被撈回來。下面把記憶分成三類,最後再處理最容易被漏掉的權限問題。
為什麼需要 memory:LLM 天生健忘
LLM 每次呼叫只看得到這次送進 context window 的內容。上一輪對話如果沒有再次帶入,對它來說就不存在。
因此所謂的記憶,其實是模型外的一套儲存與挑選機制。每次呼叫前,系統先決定哪些過去資訊值得帶進有限的 context。選得太少會忘事,選得太多又會增加成本、干擾判斷。
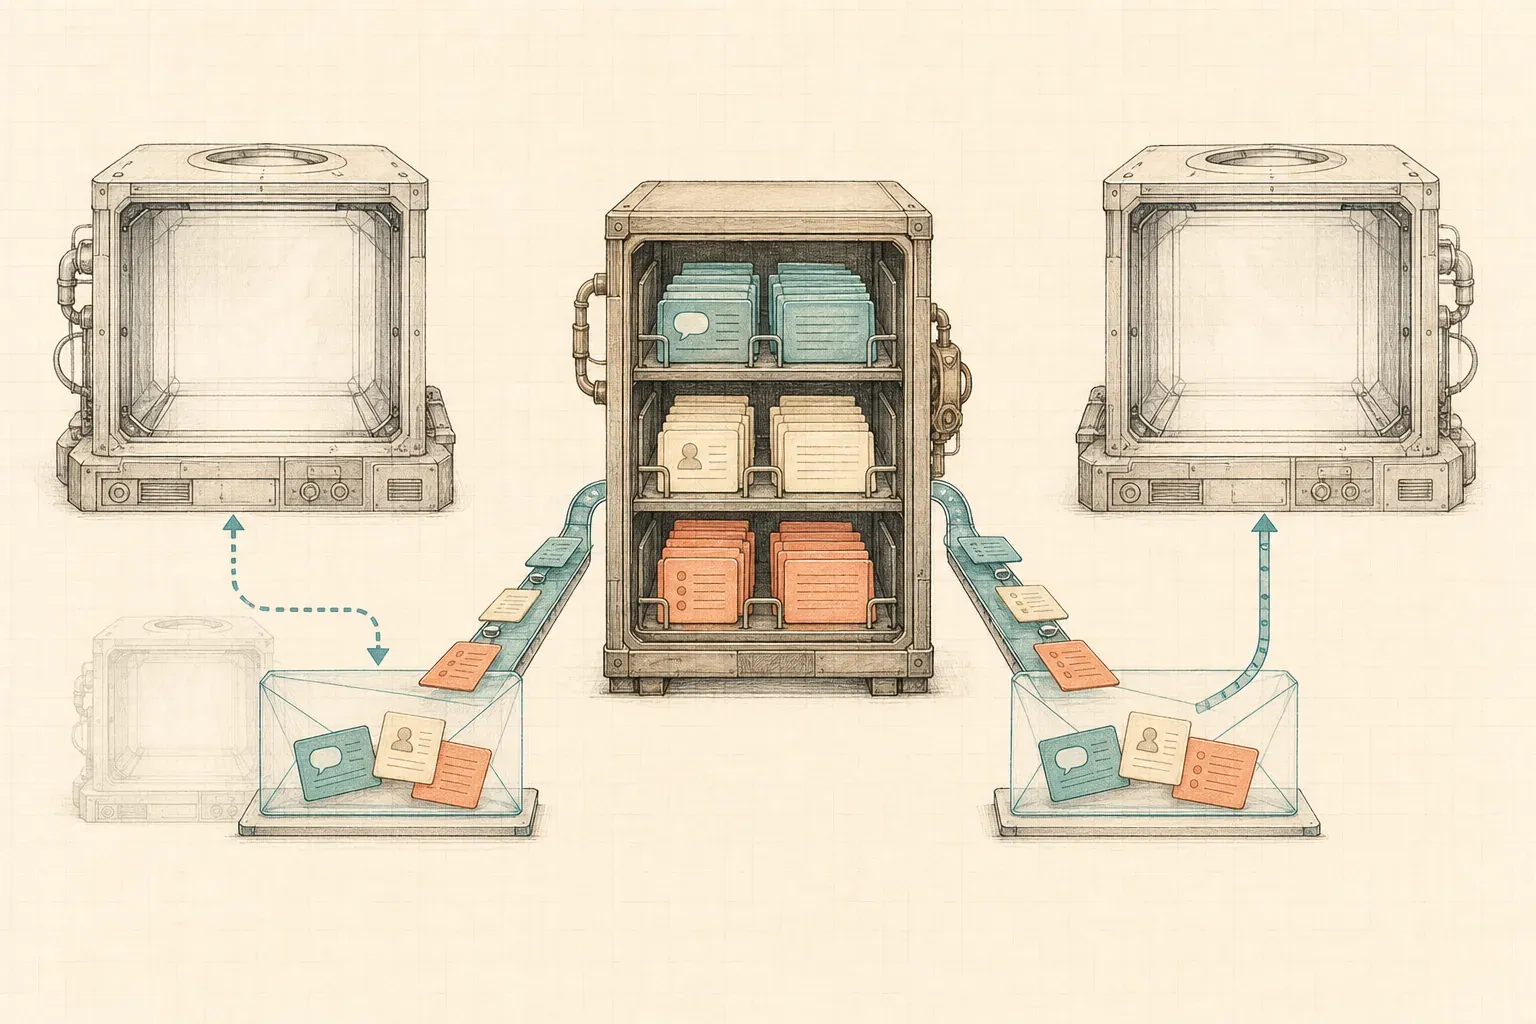
三種記憶,各司其職
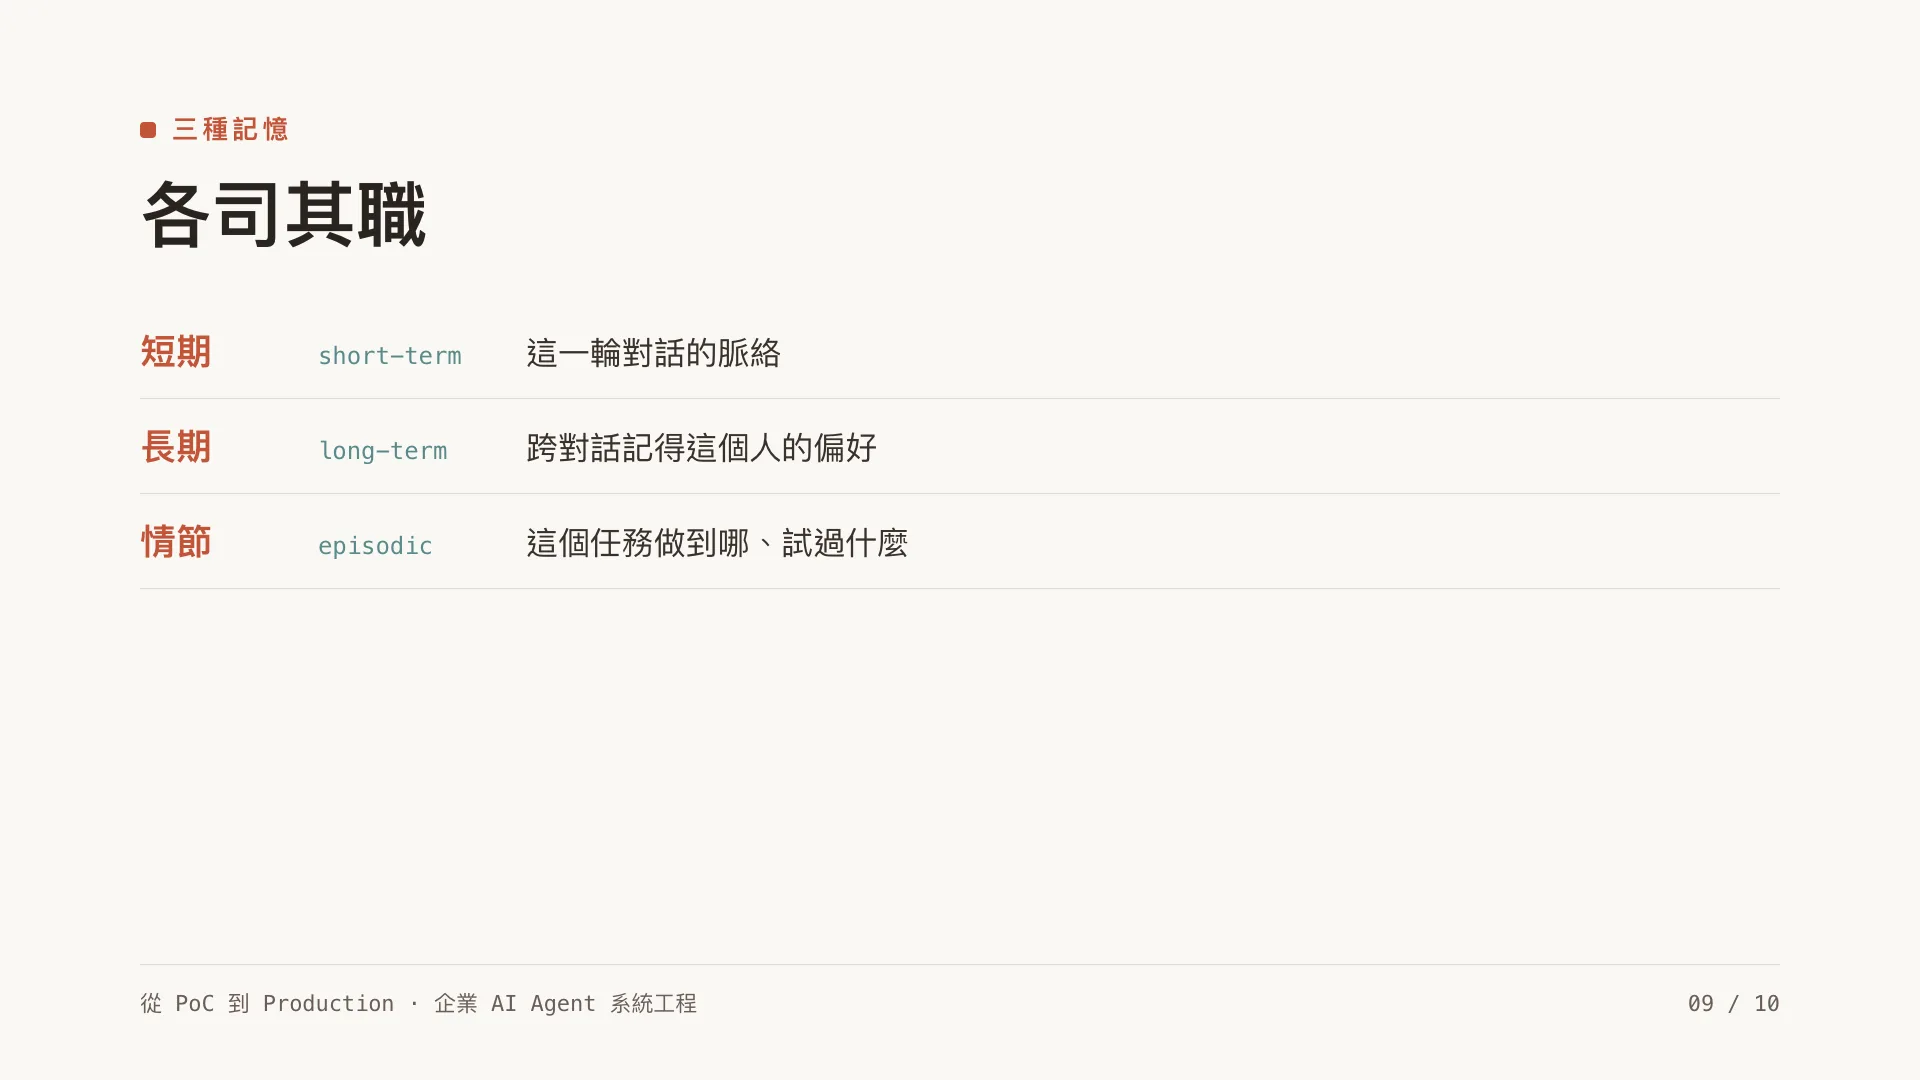
1. 短期記憶(short-term):這一輪對話
最直覺的一種——這次對話講過的話。實作上常常就是把對話歷史一路帶著走。
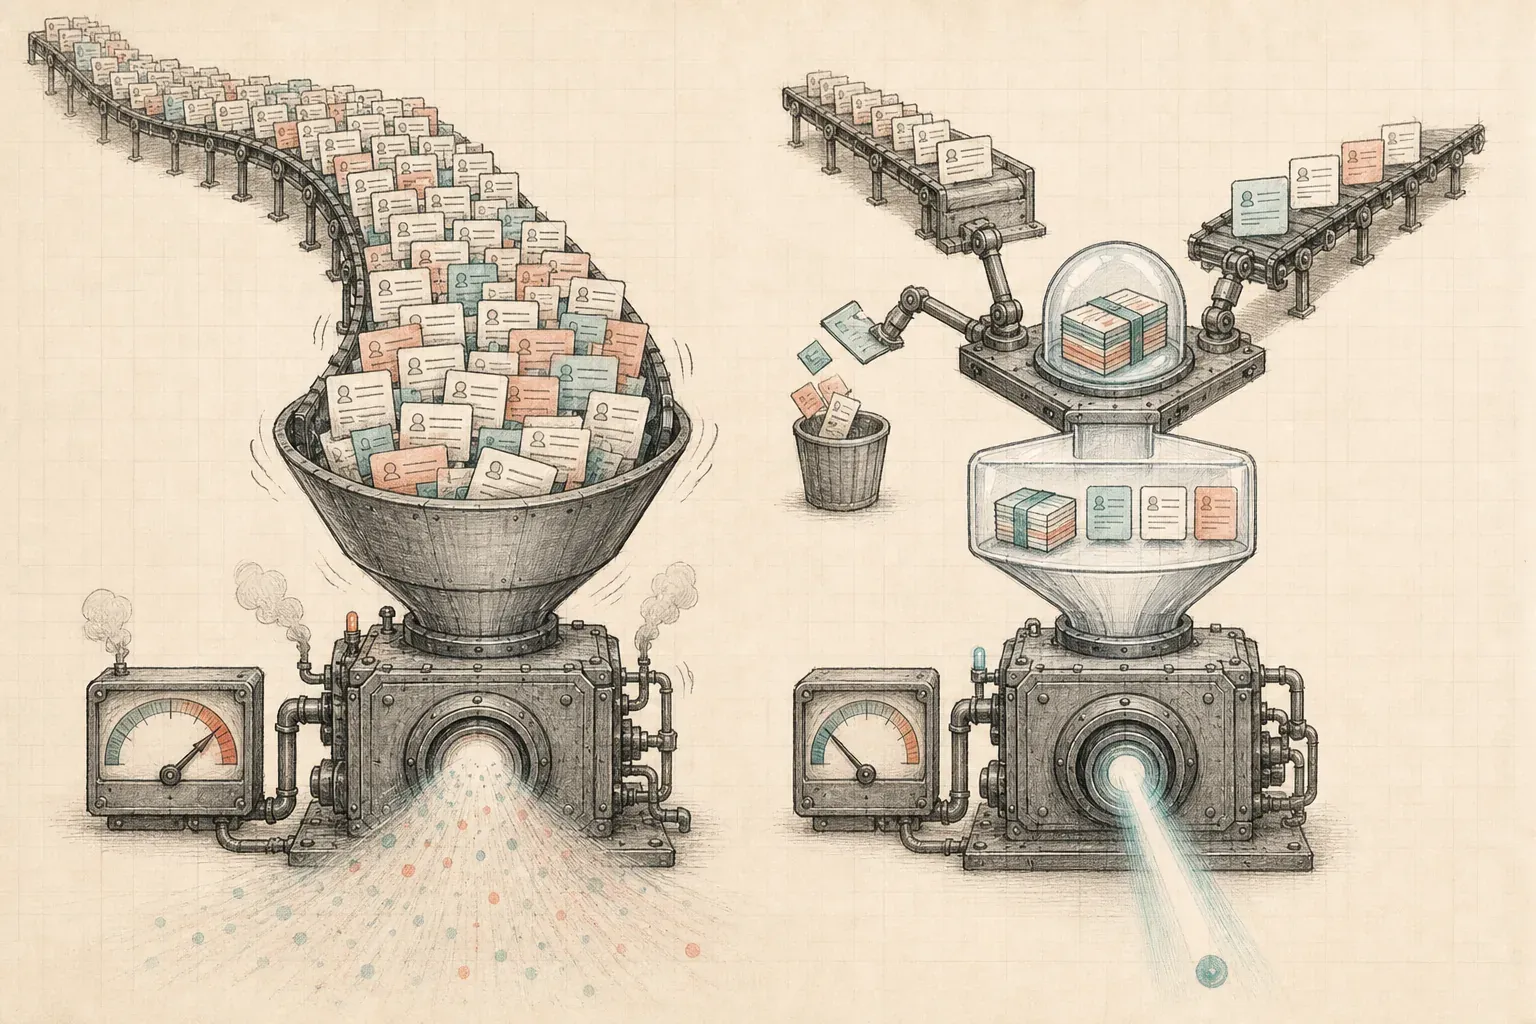
問題是 context window 有上限,而且越長越貴、越慢,品質還會隨長度退化。早年 Liu et al.(2023)的「lost in the middle」說的是一條 U 形曲線——開頭結尾記得牢、正中間掉到四成以下;但那是拿 2023 那批模型測的。到 2026,新模型在「單純的事實檢索」上大致補掉了中段這個洞,退化的形狀變了:不再是「中段最差」,而是輸入越長、整體越爛,而且開頭通常比結尾撐得久——業界現在叫它 context rot。
有人會說:2026 的視窗不是已經爆大了嗎?是。Claude 4.6 系列標準定價就吃 1M token、Gemini 上看 2M。但 「窗口大」不等於「可以全塞」——成本、延遲、context rot 三件事全都隨長度惡化,所以記憶管理在 2026 是更重要,不是更不重要;窗口變大只是把「塞不下」的硬牆,換成「塞得下但又貴又笨」的軟坑。
而且不能全帶還有個更硬的理由:塞越多,模型在「需要推理、而非字面比對」的檢索上越容易出錯。Adobe Research 的 NoLiMa 評測故意把問題和答案的字面重疊拿掉、逼模型真的去推理,結果連 GPT-4o 都從短 context 的 99.3% 一路掉到 32K 長度的 69.7%。窗口大 ≠ 真的讀得懂中間那堆料。所以短期記憶不能無腦全帶,要管理:
- 截斷:只保留最近 N 輪。簡單但會忘掉開頭。
- 摘要:把比較舊的對話壓縮成摘要再帶。省 token,但摘要會流失細節。
- 混合:近期逐字保留 + 遠期摘要。實務上常見的折衷。
2. 長期記憶(long-term):跨對話記得這個人
使用者三週前說過「我們公司用的是新台幣、財年從一月開始」,今天的新對話他不想再講一遍。長期記憶就是跨越單次對話、持久保存的那部分。
長期記憶常用向量庫保存(呼應第 4 篇):把值得留下的事實向量化,新對話開始時再依話題找回相關內容。從實作角度看,這很像是對使用者私有資料做一次 RAG。
關鍵設計問題是:什麼值得記? 全記會越積越雜、檢索越來越不準。要有策略地萃取「值得長期記住的事實 / 偏好」,而不是把每句話都存。
而且「記」只是一半,另一半是 「忘」和「更新」。使用者半年前說「我們財年從一月開始」,後來改了——舊記憶沒被覆蓋,今天就會拿過期資訊去推理,比沒記還糟。所以長期記憶不能只進不出:要能偵測衝突、覆蓋舊事實、定期淘汰沒再用到的記憶。一個只會累積、不會遺忘的記憶庫,最後會變成一個越來越自信地給你錯答案的系統。
3. Episodic 記憶:這個任務做到哪了
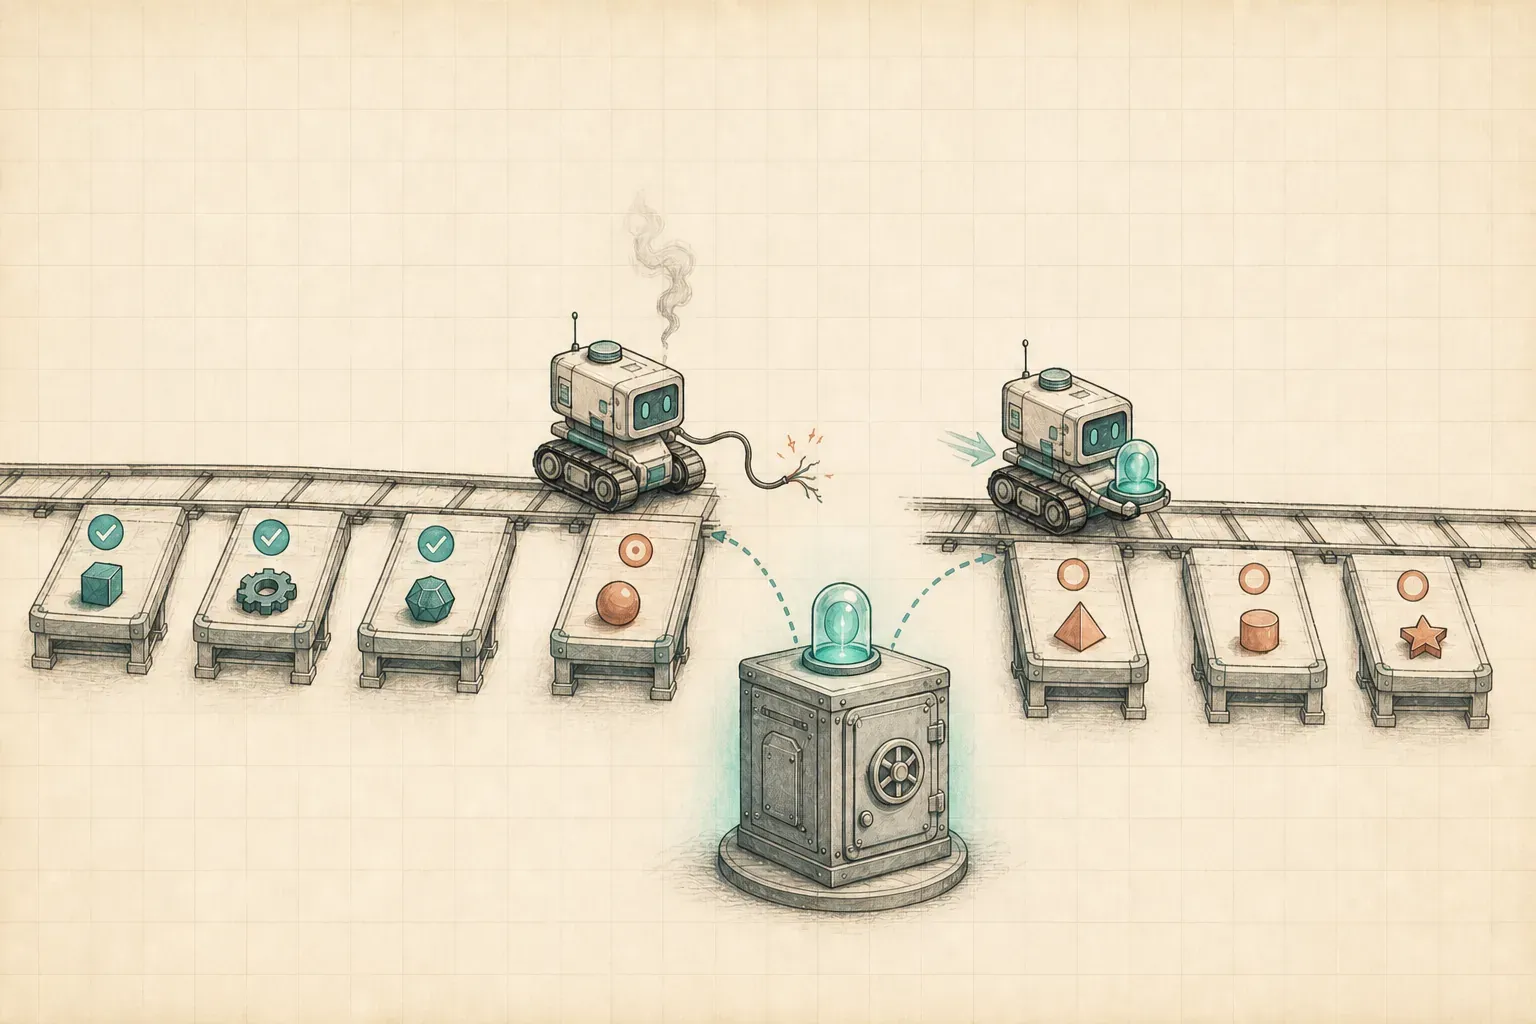
這層最常被忽略,但對「會做事」的 agent(第 6 篇的 tool use)最重要。Episodic 記憶記的是一個任務的執行軌跡:目標是什麼、已經做了哪幾步、每步結果如何、哪條路試過失敗了。
沒有它,一個多步驟任務做到一半被打斷(逾時、人離開、系統重啟),回來就整個忘光、從頭再來,甚至重複做已經做過的副作用動作(又回到第 6 篇的 idempotency)。有了它,agent 才能「接著上次的進度繼續」。
到了這一層,問題已經很接近一般後端的狀態管理。
把 agent 當成一台狀態機
一個會做多步驟任務的 agent,與其想成「一個很聰明的對話」,不如想成一台狀態機:它有當前狀態、有歷史軌跡、會根據結果轉移到下一個狀態。
stateDiagram-v2
    [*] --> Planning
    Planning: 規劃<br/>拆解任務、決定步驟
    Executing: 執行某一步
    Waiting: 等待工具結果
    Escalated: 升級處理<br/>求助人類
    Done: 任務完成
    Planning --> Executing
    Executing --> Waiting
    Waiting --> Executing: 還有下一步
    Waiting --> Escalated: 逾時或卡住
    Escalated --> Executing: 人類處理後接續
    Executing --> Done: 所有步驟結束
    Done --> [*]
用這個視角,很多 production 問題突然就有了答案:
- 可中斷 / 可恢復:狀態存在外面(不是只活在記憶體),就能存檔、重啟、接續。
- 可觀測:每次狀態轉移都記下來,就是第 9 篇要的 trace。
- 可重播:出包時能照著軌跡重現,才 debug 得動。
- 逾時 / 卡住:狀態機能設「停在某狀態太久就升級處理或求助人類」。
這些做法都來自熟悉的後端工程:狀態、佇列和持久化。正式系統要把對話脈絡當成有生命週期的狀態,而不是只放在程序記憶體裡的一串訊息。
Demo 只要沿著預先準備的 happy path 跑完一次;正式系統則要處理任務做到第七步時機器剛好重啟。能不能從 checkpoint 接回去,比模型當下看起來多聰明更重要。
最容易出包的點:記憶也有權限
最後是權限。這和第 5 篇談的文件越權是同一類問題,只是資料來源換成了對話與偏好。
長期記憶常常存在共用的向量庫裡。如果你的隔離沒做好,就可能發生:
A 使用者跟 agent 說過的事,在 B 使用者的對話裡被檢索出來、被透露。
這是比第 5 篇的文件越權更隱蔽的洩漏,因為它洩的是「另一個使用者私下講的話」,而且很難在測試時發現——你要剛好用兩個使用者、剛好話題相近才會撞到。
防線跟第 5 篇一模一樣:
- 每筆記憶都綁使用者 / 租戶身分。
- 檢索長期記憶時,pre-filter 只在這個人自己的記憶裡找。
- 多租戶要硬隔離。
把 memory 視為「對使用者私有資料做的 RAG」後,設計會清楚很多。第 5 篇的身分綁定、pre-filter 與多租戶隔離,在這裡一樣適用。
小結
- 短期記憶管這輪對話,重點是 context 怎麼截斷 / 摘要,別讓它又長又貴又失焦。
- 長期記憶跨對話記住這個人,技術上常常就是「對使用者私有資料的 RAG」,要有策略地萃取。
- Episodic 記憶記任務軌跡,本質是狀態管理,讓任務可中斷、可恢復、可重播。
- 記憶有權限:它就是私有資料的 RAG,第 5 篇的權限紀律一條都不能少。
把 agent 當狀態機來做,任務才有機會恢復、觀測和重播。下一篇談多代理協作:什麼任務值得拆成多個 agent,什麼情況維持單一 agent 反而更省事。
文章簡報
延伸閱讀
- 上一篇:Tool use 與 MCP
- 多代理記憶架構——當記憶要跨多個 agent 共享時的設計
- 下一篇:《Multi-agent 該不該用?》