企業 AI Agent 治理:資料、權限、工具與持續監督
本篇是「從 PoC 到 Production:企業 AI Agent 系統工程」系列的第 11 / 12 篇。你可以從系列總覽開始閱讀,也可以直接接著看本文。
這是「從 PoC 到 Production:企業 AI Agent 系統工程」系列第 11 篇(共 12 篇)。上一篇:延遲、可靠性與成本,該怎麼取捨?。這是一份治理設計參考,不是特定公司已導入系統的稽核報告。
前面十篇分別談了第 5 篇的權限檢索、第 6 篇的工具邊界,以及第 9 篇的可觀測性。到了治理階段,要把這些機制放進同一張圖,才能和資安、法遵及業務主管一起回答一個問題:
「要具備哪些控制與紀錄,我們才敢讓這個 agent 接觸客戶資料、財務系統或製造流程?」
PoC 通常還不需要回答這題,但正式系統避不開。下面這份框架,就是把上線前後該有的控制集中整理出來。
一頁治理框架
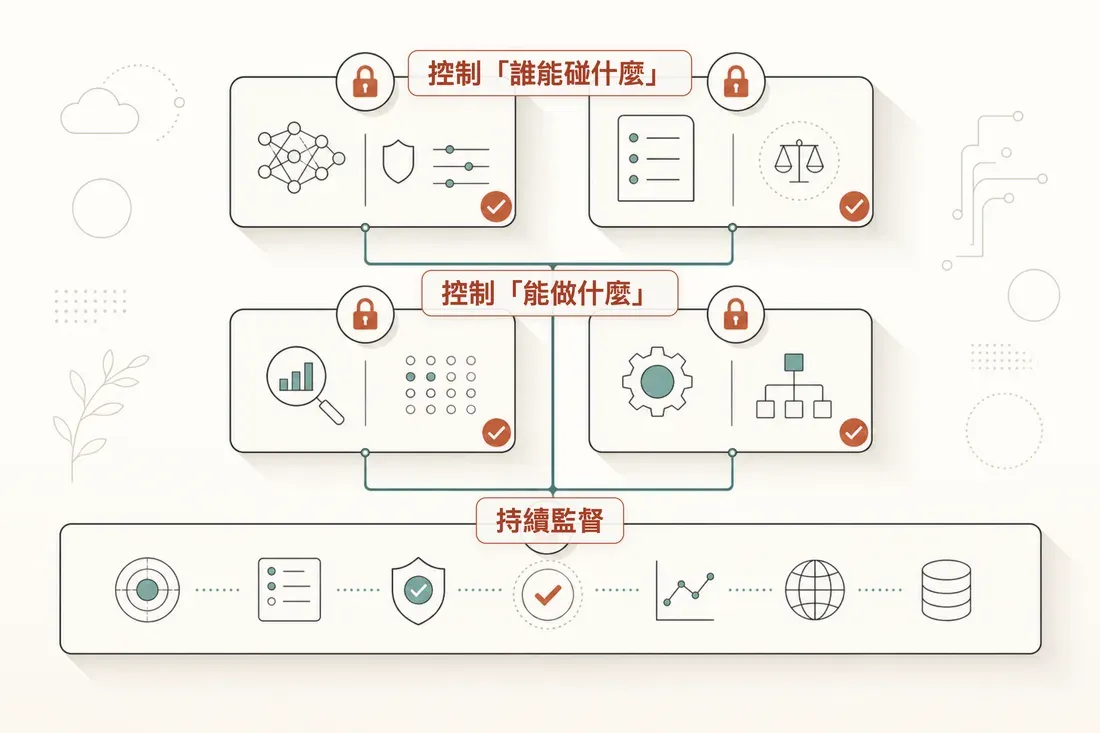
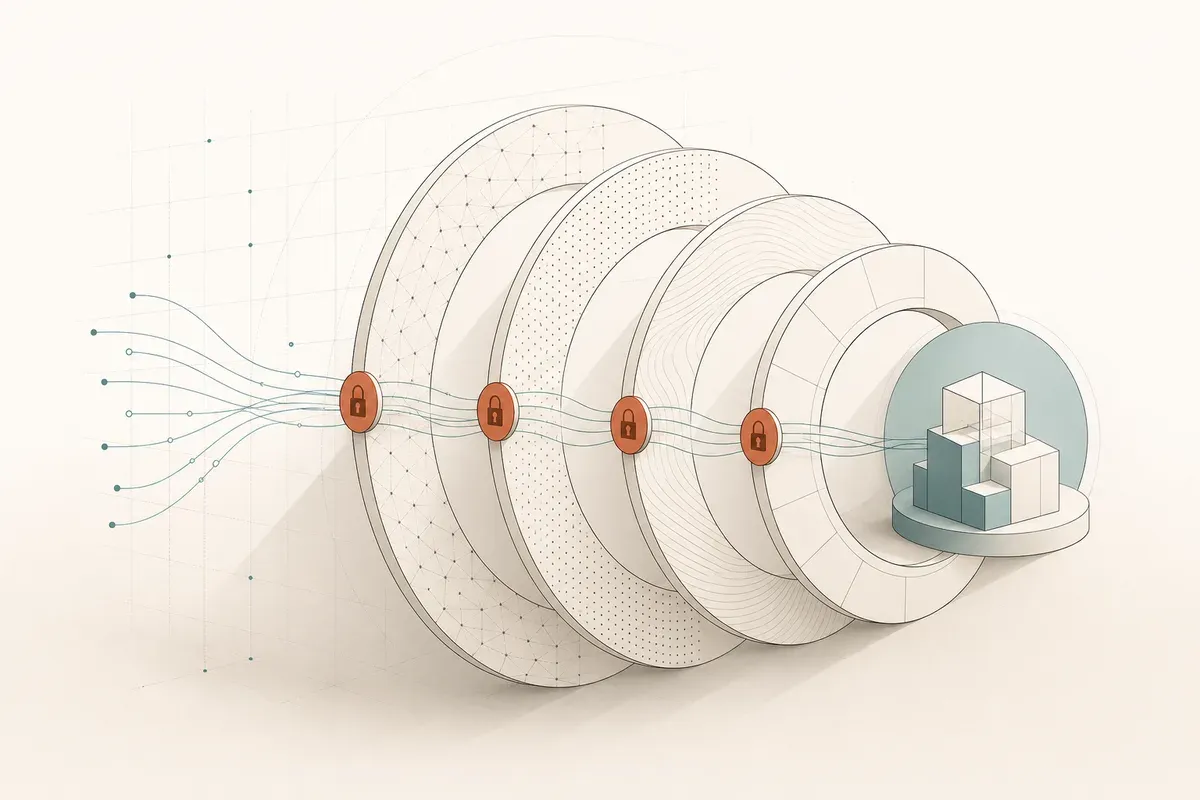
治理框架的三層:上層管「誰能碰什麼」、中層管「能做什麼」、底層橫跨一切持續監督(audit / eval / observability / cost)。
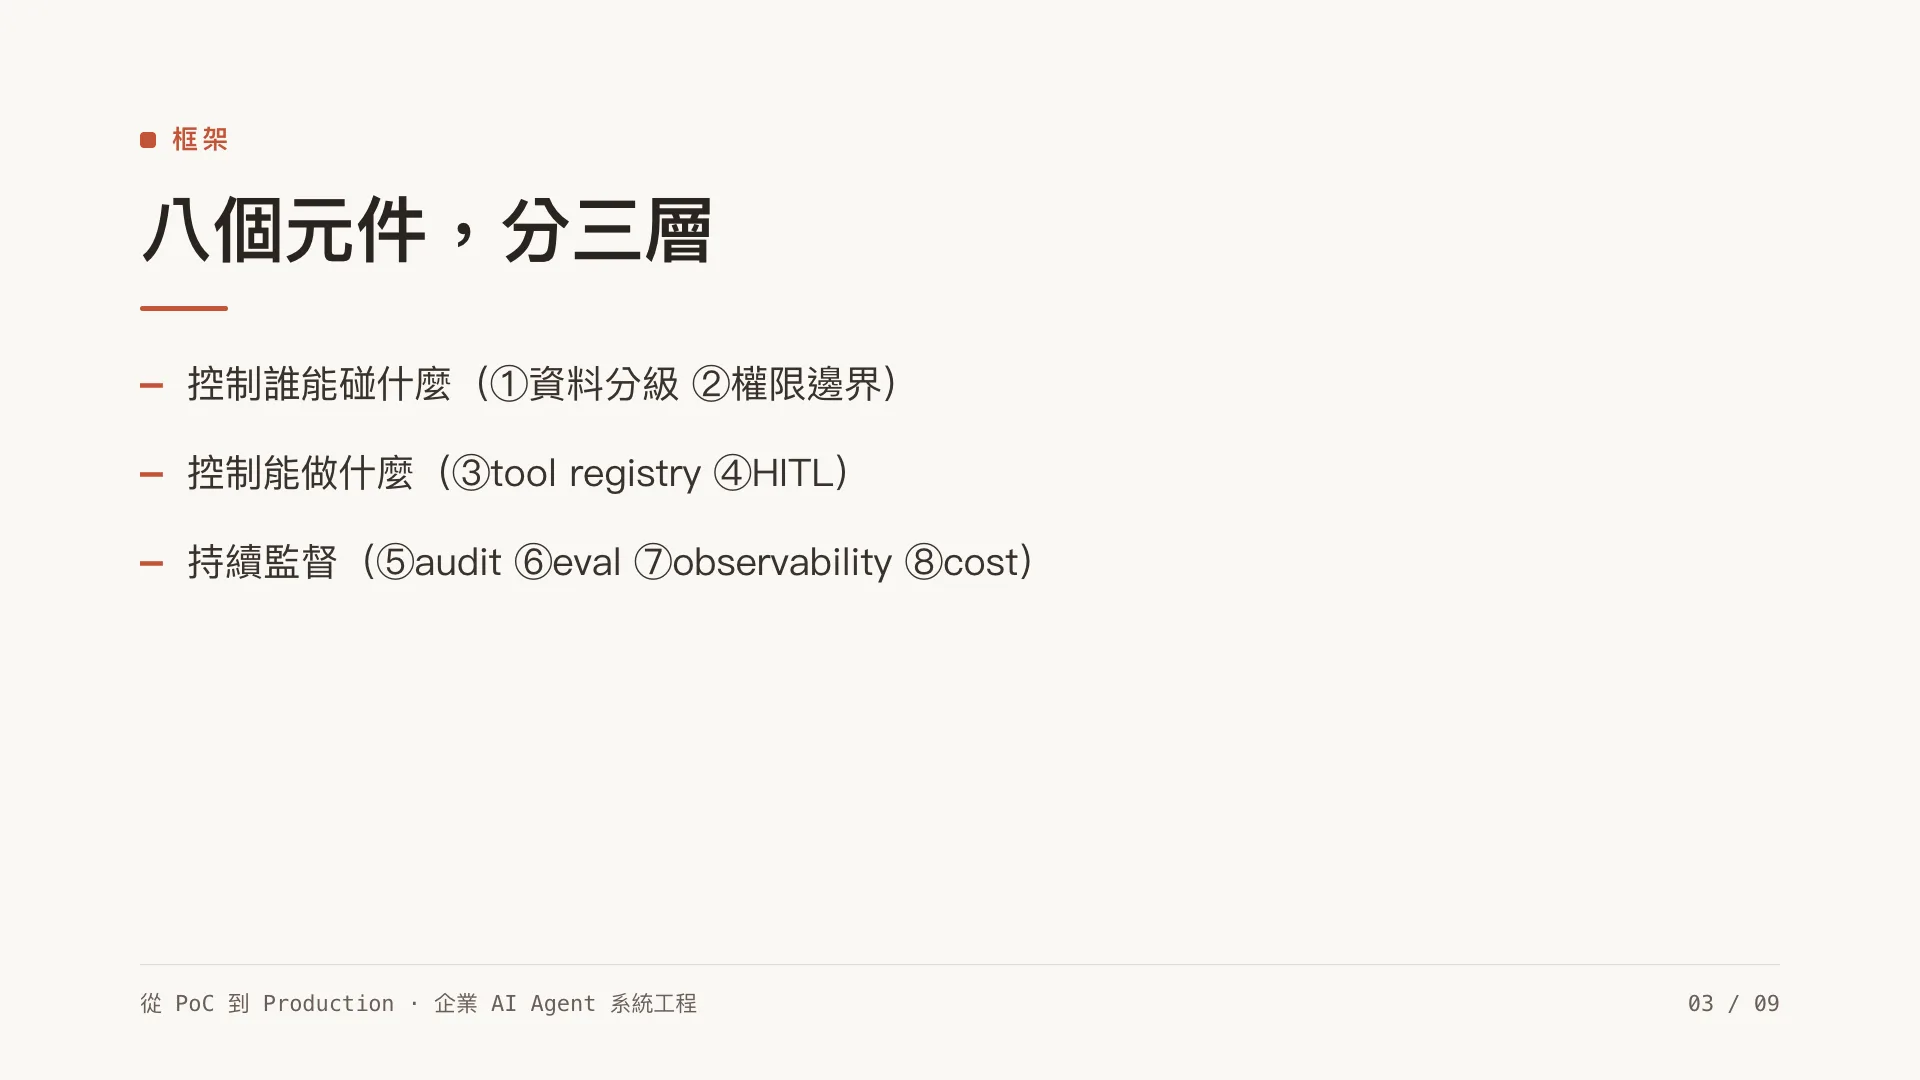
圖裡有八個元件,分成三層:控制誰能碰什麼(①②)、控制能做什麼(③④),以及上線後持續監督(⑤⑥⑦⑧)。
這張圖不是另一套自創名詞,而是把 NIST AI RMF、ISO/IEC 42001 與 EU AI Act 的相關要求,對應到 agent 系統裡常見的工程元件:
| 治理元件 | NIST AI RMF | ISO/IEC 42001 | EU AI Act(高風險) |
|---|---|---|---|
| ① 資料分級 | MAP | Annex A 控制 | Art.10 資料治理 |
| ② RBAC/ABAC・最小權限 | GOVERN | Annex A 控制 | — |
| ③ Tool Registry | MAP / GOVERN | Annex A 控制 | — |
| ④ Human-in-the-loop | GOVERN / MANAGE | PDCA | Art.14 人類監督 |
| ⑤ Audit Log | MEASURE | PDCA | Art.12 紀錄保存 |
| ⑥ Eval Harness | MEASURE | Check(PDCA) | — |
| ⑦ Observability | MEASURE | Check(PDCA) | Art.12 / Art.72 |
| ⑧ Cost/持續監督 | MANAGE | Act(PDCA) | Art.72 上市後監督 |
做這層對應,是為了讓工程、資安與法遵使用同一套語言。法遵關心的是控制措施對應哪一條要求;工程團隊則需要知道那一條要求最後要落在哪個元件和流程裡。
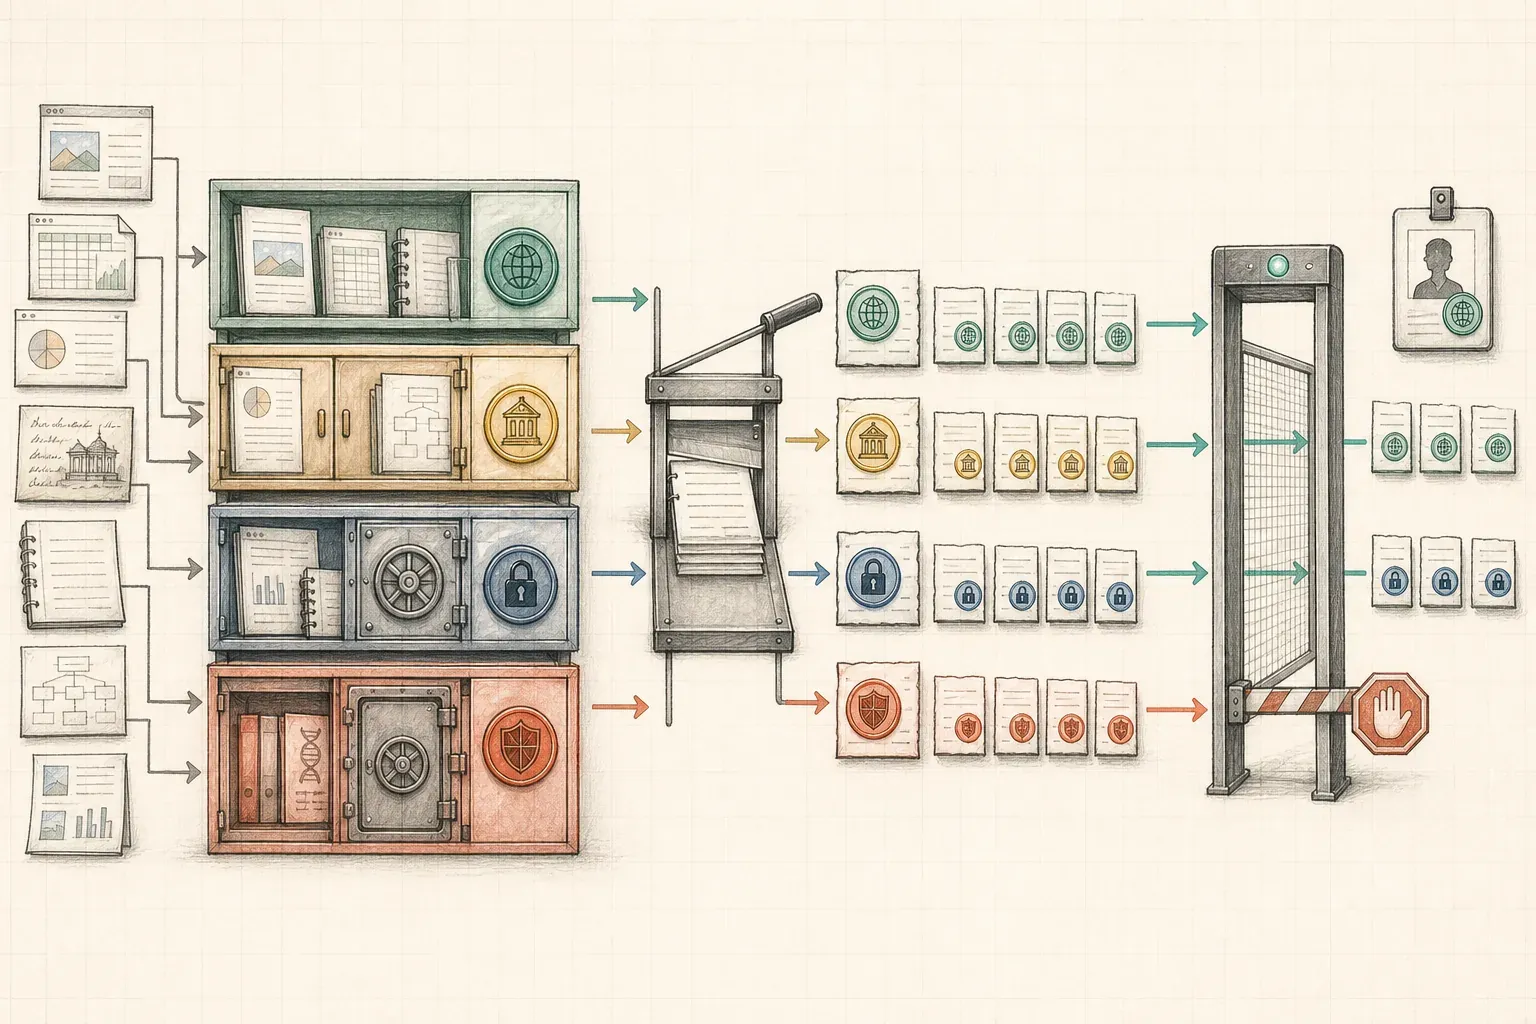
① 資料分級:先知道你在保護什麼
治理通常從資料盤點開始:哪些是公開資料、內部資料、機密資訊,以及個資或其他受法規與合約保護的內容?
沒有分級,後面的權限控制就沒有依據——你不知道哪些資料「碰了會出事」。這一步常常要跟法遵、資安一起做,是治理裡最不技術、卻最不能跳過的一步。分級的結果,會變成第 5 篇那些 chunk 上的權限 metadata 的來源。
② 身分與權限邊界:RBAC / ABAC
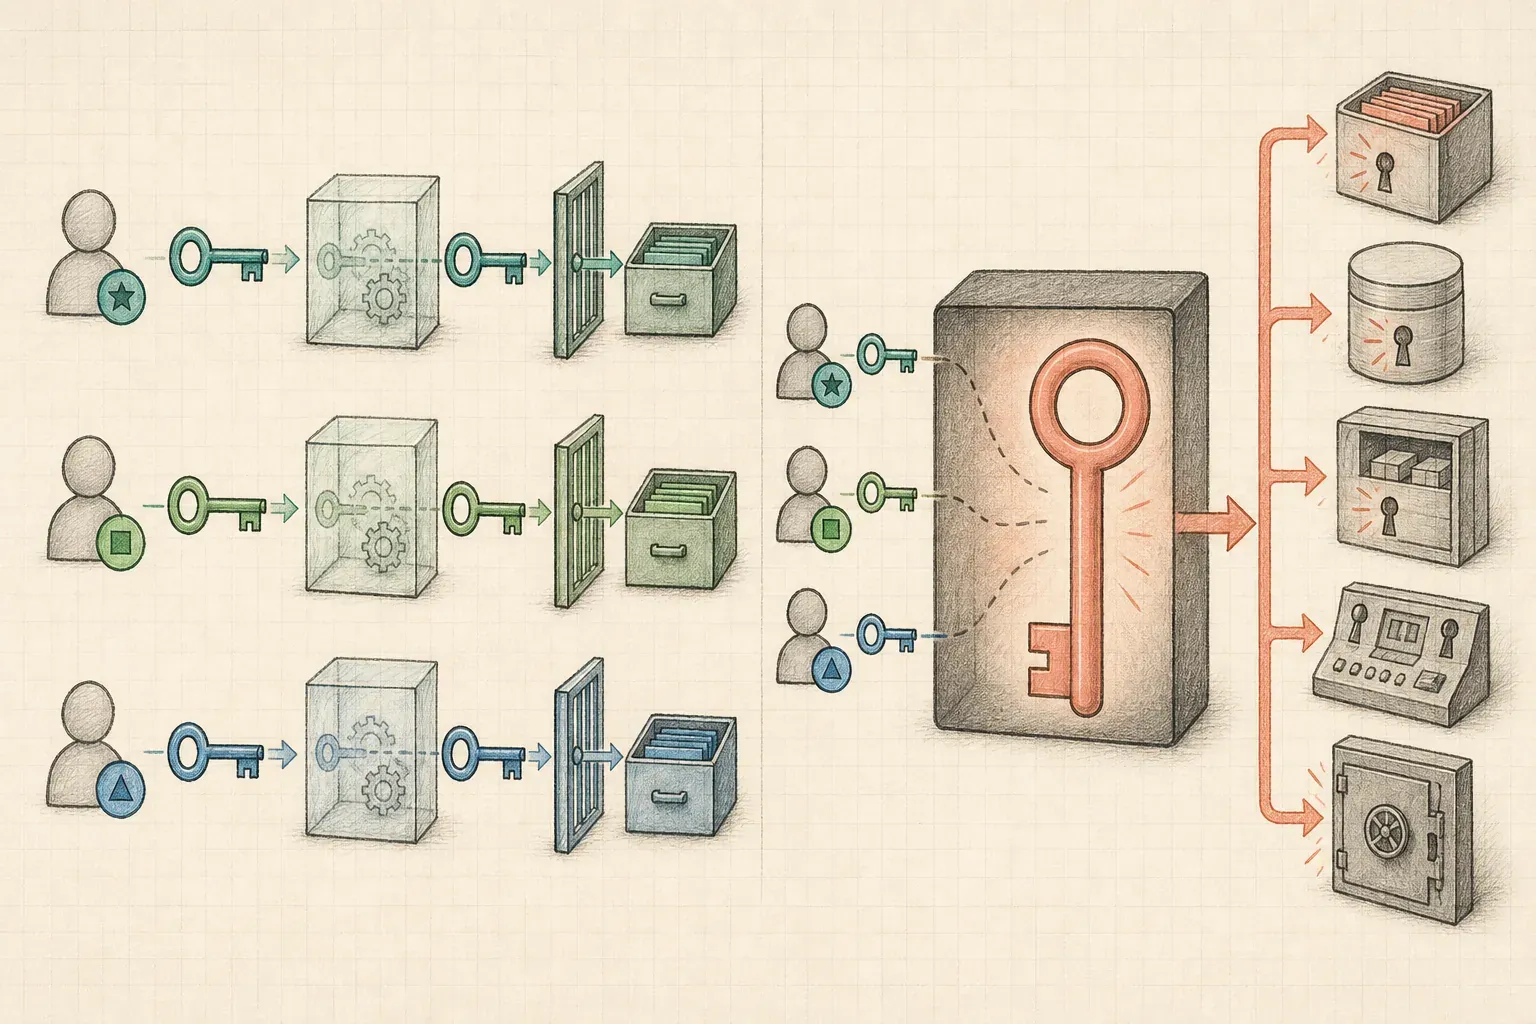
把「誰、能透過 agent、碰到哪些資料和工具」明確定義出來。這是第 5 篇(資料檢索)和第 6 篇(工具動作)的權限,在治理層的統一視角。
- RBAC(角色為本):依角色給權限。工程師能查工單、不能查薪資;主管多一些;HR 又不同。
- ABAC(屬性為本):更細,依屬性動態判斷(部門 + 機密等級 + 地區)。複雜場景用得上。
核心原則是最小權限:agent 代表某使用者行動時,只該有那個使用者該有的權限,一分不多。最該避免的反模式,就是第 2 篇警告過的——agent 用一個服務帳號的最大權限在跑,把自己變成權限放大器。
③ Tool Registry:能做的事,要有一份清單
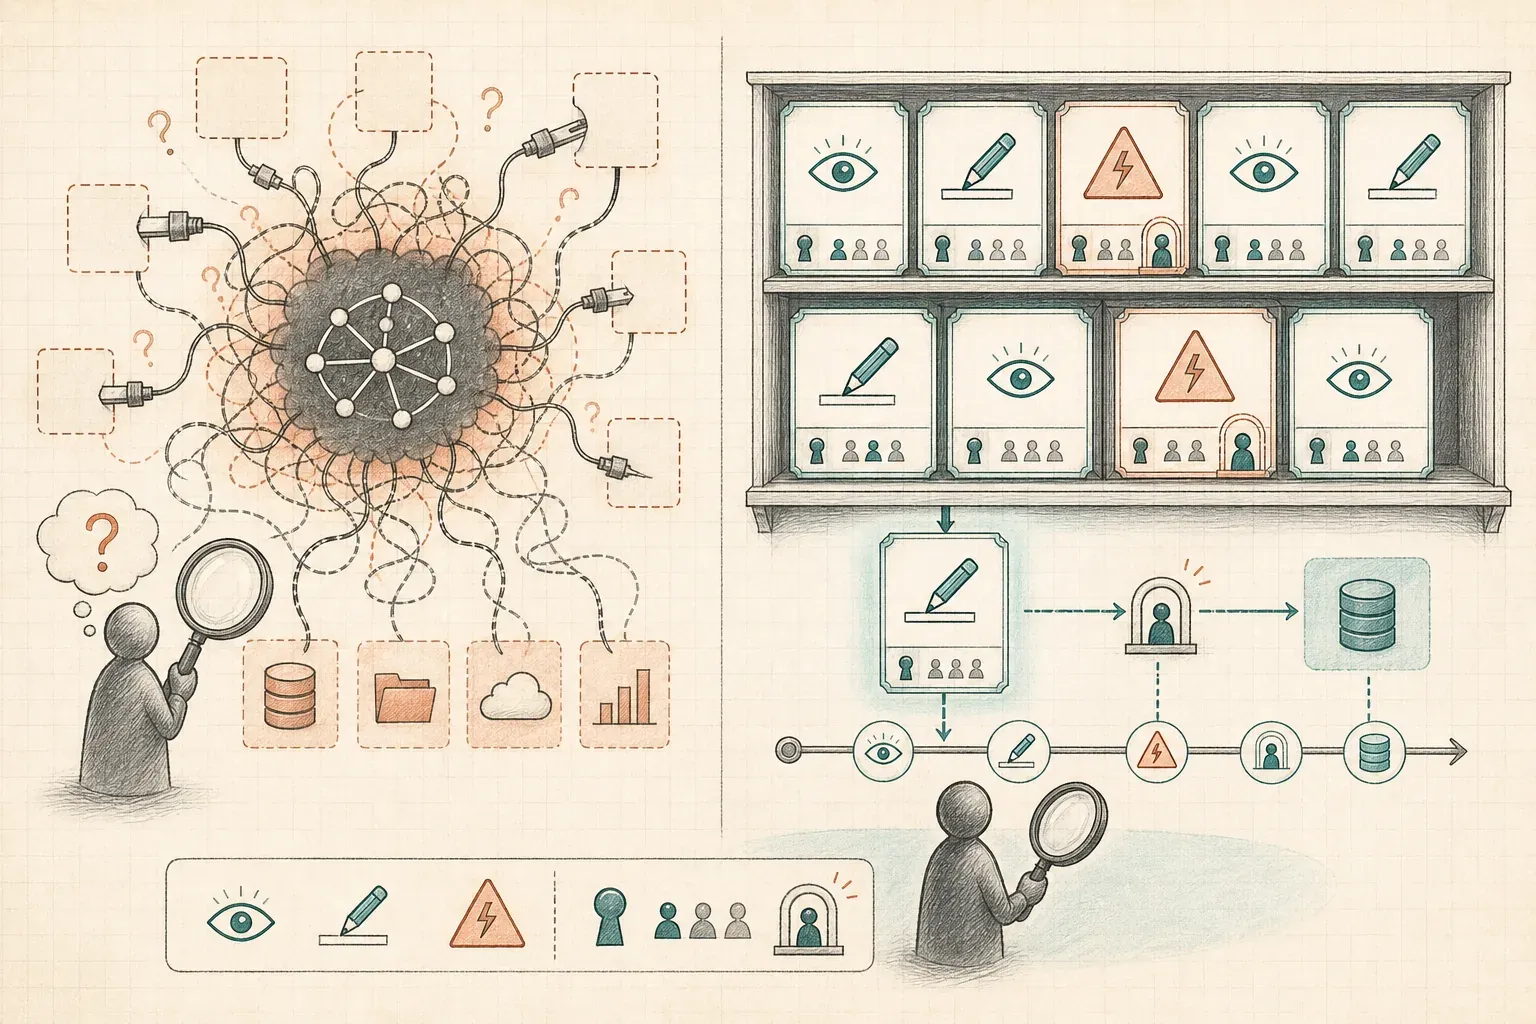
第 6 篇講過,MCP / tool registry 把「agent 能做哪些動作」變成一份可盤點的清單。在治理層,這份清單要再標註:
- 每個工具的 action boundary(唯讀 / 寫入 / 危險)
- 需不需要 approval
- 哪些角色能用哪些工具
當資安問「你們的 agent 到底能對哪些系統做哪些事」,你掏得出這份清單——這就是治理的可稽核性。沒有 registry,你連自己的 agent 能做什麼都說不清楚,更別說讓資安放行。
④ Human-in-the-loop:高風險動作的剎車
第 6 篇講過 approval flow 的機制,治理層要決定的是政策:哪些動作非要人類確認不可?
通常的分界:會造成重大、不可逆副作用的——大量資料異動、對外溝通、金流、改動生產設定——都該有 HITL 關卡。低風險唯讀的放行。這份「哪些要剎車」的清單,是治理的核心決策之一,要跟業務一起定,因為它直接影響效率和風險的平衡。
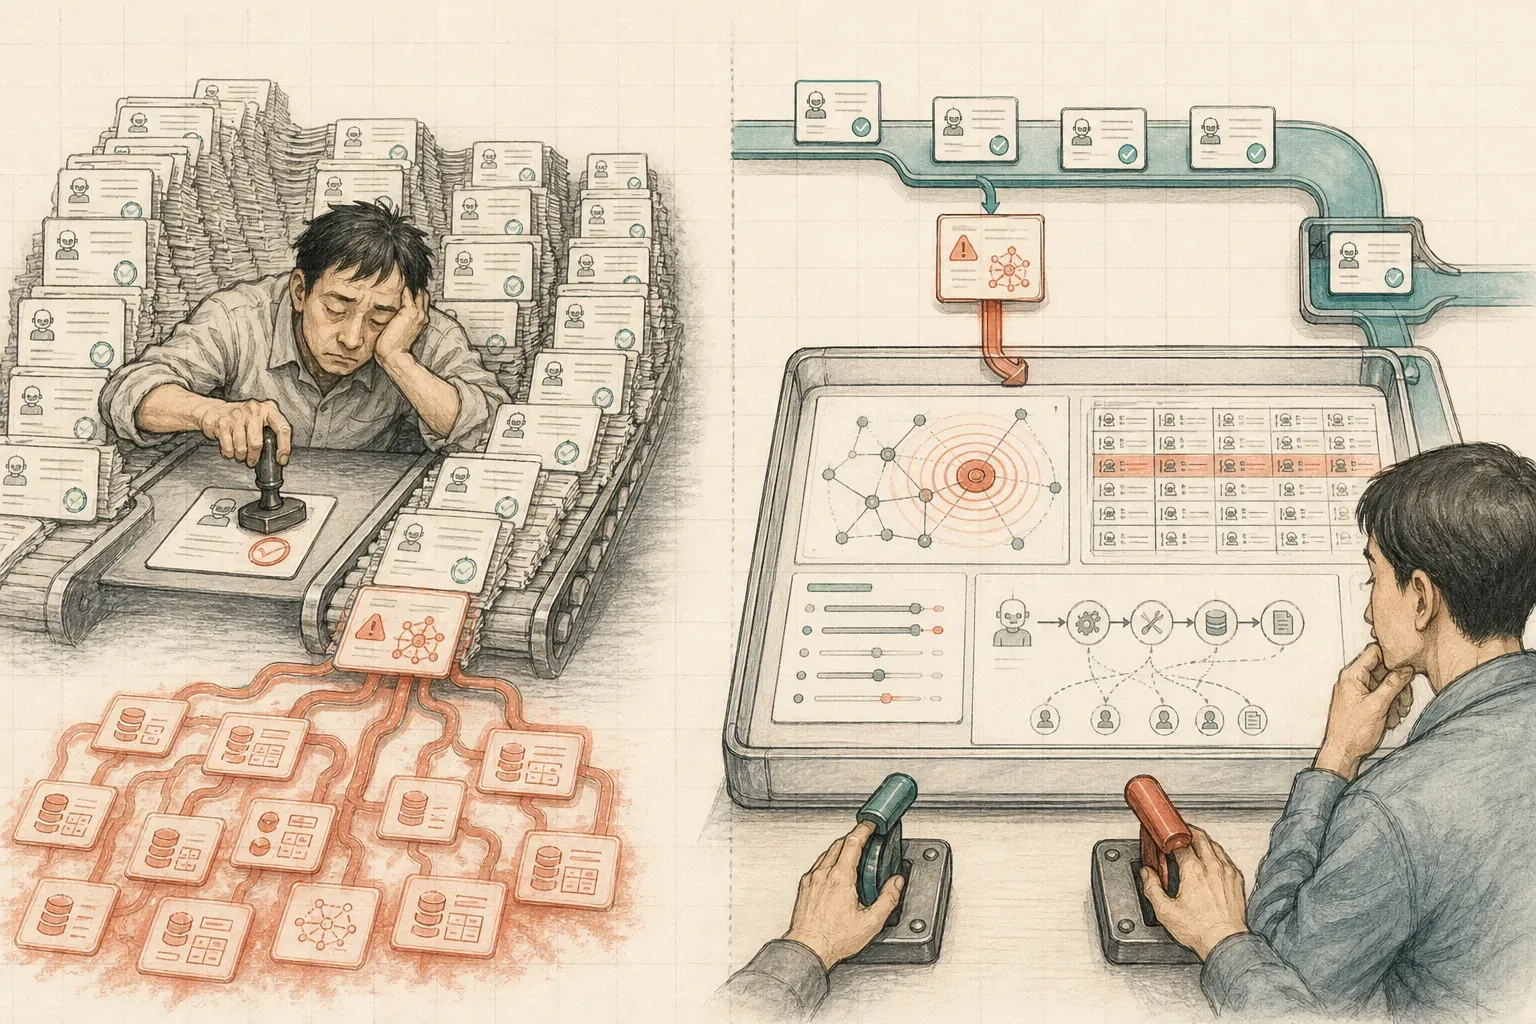
但 HITL 最常見的失效,不是沒放關卡,是放了卻變成橡皮圖章——當待核可的動作又多、又通常是對的,人會很快養成「一律點同意」的習慣,關卡還在、監督已經沒了。這正是 EU AI Act Art.14 想堵的洞:它要的是有意義的、能真正介入的人類監督,不是流程上多一個 approval 按鈕。對 agent 還有個額外的坑:當待核可項是模型生成的一段自然語言,審核者很難在幾秒內判斷它的副作用範圍。所以 HITL 的設計品質,取決於「呈現給人類的資訊,夠不夠讓他做出有意義的判斷」——這動作會改到哪些資料、影響多大、為什麼 agent 這樣選——而不只是「有沒有放一個確認關卡」。
⑤–⑧ 監督層:信任不是一次性的,是持續的
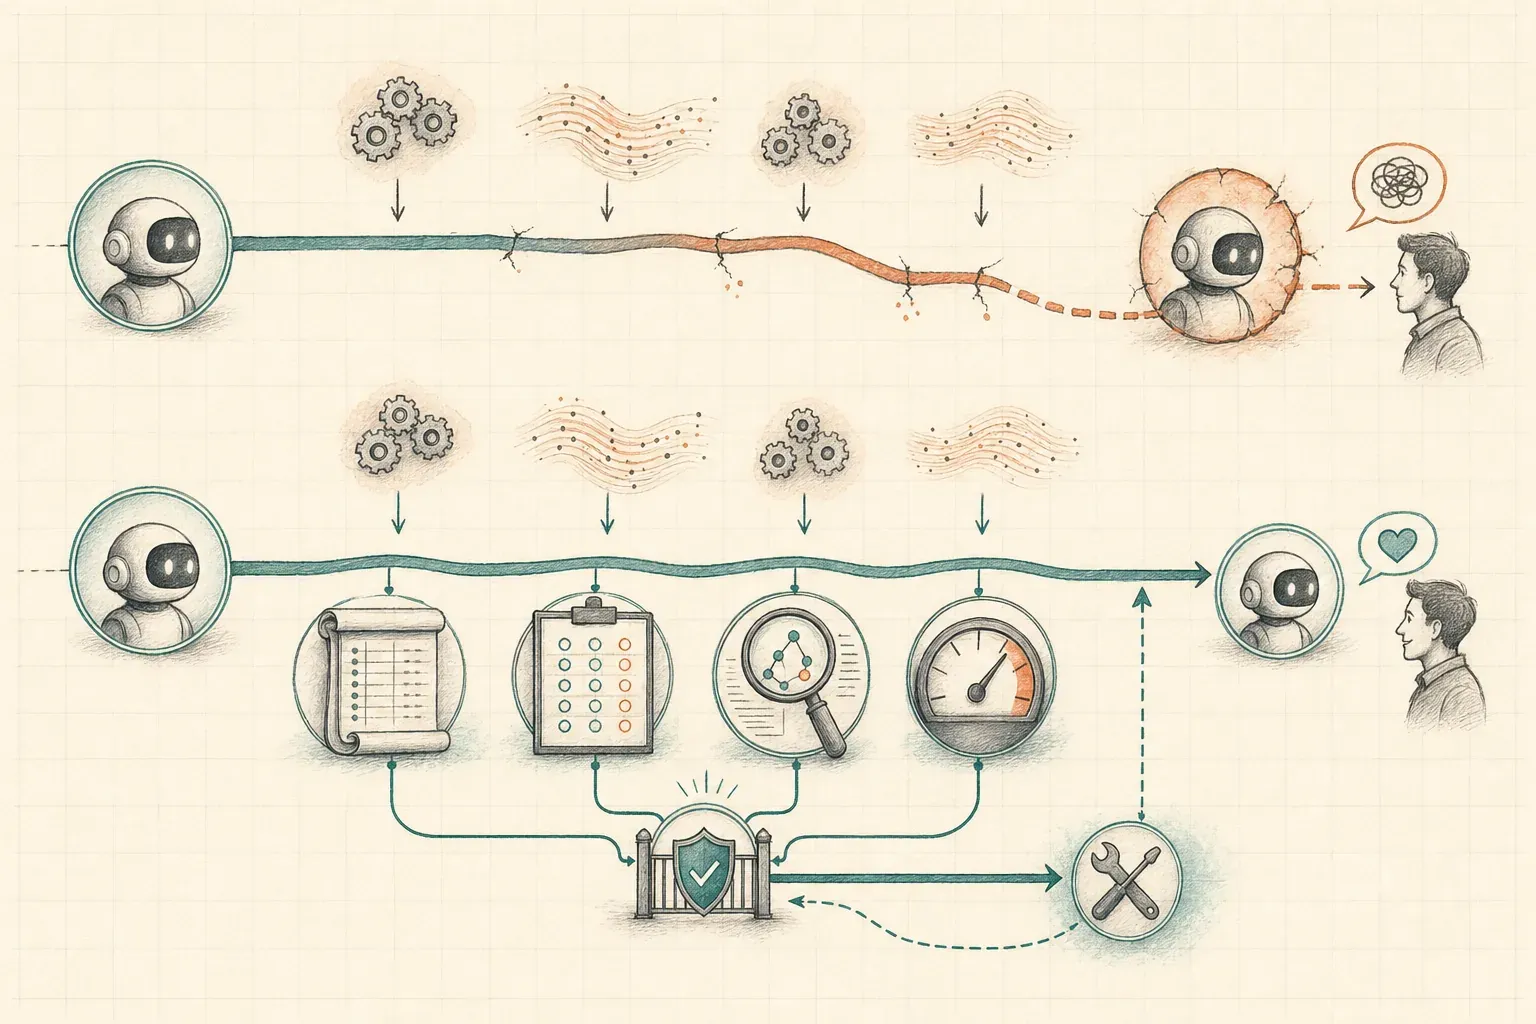
前面四項是「事前控制」,但治理的另一半是持續監督——因為信任會隨時間、隨模型更新、隨資料變化而流失。這四項都在前面章節建好了,治理層把它們組織起來:
- ⑤ Audit Log:誰、何時、透過 agent、存取了什麼、做了什麼動作。合規與事故調查的底線,出事時這是你唯一能還原真相的東西。兩個常被漏掉的細節:(1) 要留多久? EU AI Act Art.12 已把高風險系統的「自動事件記錄」從最佳實踐升級成法定義務,Art.19 對 deployer 給的下限是至少保存六個月——audit log 不只要有,還要回答得出保存期限。(2) 對 agent,光記「呼叫了哪個工具」遠遠不夠,要連 prompt、檢索到的 chunk、工具的輸入輸出一起留,否則事故調查時最關鍵的中間決策過程是一片空白。這份資料跟第 9 篇 observability 的 trace 其實是同一份東西的兩種用途。
- ⑥ Eval Harness(第 9 篇):品質有沒有偷偷掉?模型被供應商更新後行為有沒有漂移?這套持續監督的精神對應 NIST AI RMF 的 MEASURE / MANAGE;NIST 2024 年的 Generative AI Profile(NIST-AI-600-1)甚至把 confabulation(也就是幻覺)獨立列為一個風險類別,對 12 個 GenAI 風險領域給了 200+ 條建議行動,可以直接拿來當 eval 與監控清單的起點——它點名的第一個風險,正好就是這系列開頭的「鴻溝一:正確性沒有底線」。
- ⑦ Observability(第 9 篇):每個決策可追、可重播,出包查得到根因。
- ⑧ Cost Monitor(第 9、10 篇):花費透明、異常可告警。
這四項合起來回答的是:「我們有沒有在持續確認這套系統仍然值得信任?」 一個只做事前控制、卻沒有持續監督的 agent,就像一個通過了上線審查、之後就再也沒人看的系統——遲早出事。
怎麼落地:別想一次到位
框架不必一次做到最完整,可以按風險分階段導入:
- 先做 ①②(分級 + 權限邊界):沒有這個,任何接觸真實資料的 agent 都不該上線。這是入場券。
- 再做 ③⑤(registry + audit):讓「能做什麼」和「做過什麼」可盤點、可追。
- 接著 ④(HITL):把最高風險的動作先用人類關卡保護起來。
- 持續強化 ⑥⑦⑧:監督層隨系統成熟逐步加深。
這四步不是四件可以平行挑著做的事——中間有一道硬性閘門,而且要不要走完全程,取決於這個 agent 的風險高度:
flowchart TD
    A["這個 agent 碰得到什麼資料?<br/>能造成什麼動作?"] -->|"只查公開 FAQ<br/>的內部小工具"| L["治理強度對應風險<br/>不需要這整套"]
    A -->|"接觸機密資料<br/>或不可逆動作"| S1["第一步:① 資料分級<br/>② RBAC/ABAC 最小權限"]
    S1 --> G{"入場券:<br/>①② 到位了嗎?"}
    G -->|"沒有"| STOP["接觸真實資料的<br/>agent 都不該上線"]
    G -->|"有"| S2["第二步:③ Tool Registry<br/>⑤ Audit Log"]
    S2 --> S3["第三步:④ HITL<br/>先擋住最高風險動作"]
    S3 --> S4["第四步:⑥ Eval<br/>⑦ Observability<br/>⑧ Cost Monitor"]
    S4 --> R["模型更新、資料變化<br/>信任隨時間流失"]
    R -->|"隨系統成熟加深"| S4
    S3 -.->|"⑥⑦⑧ 之後再補"| BAD["過了上線審查<br/>就再也沒人看<br/>遲早出事"]
那條虛線是典型的半套做法:事前控制做得很漂亮,⑥⑦⑧ 說「之後再補」,於是系統通過上線審查之後就沒人再看它一眼——而信任正是在上線之後,隨著模型更新與資料變化一點一點流失的。
還有一個外部理由,讓「現在就做」比「等等再說」划算:法規時鐘已經在跑。 但這裡有個 2026 必須講對的眉角——EU AI Act 是分階段生效的:禁止性實務與 AI 素養義務已自 2025-02 適用、GPAI 義務自 2025-08 適用,這幾條都已生效。而大家最在意的高風險義務,原訂 2026 年 8 月起,在 2025 年底的 Digital Omnibus 提案後被往後推(討論中的新時程落在 2027–2028,截至本文撰稿仍待正式定案)。所以如果你還在網路上看到「2026 年 8 月高風險義務全面適用」,那是舊懶人包、已經過期了。給你的訊息很單純:日期會動,但別賭它會無限延。 分級、RBAC、audit、HITL 這套底層工程量大、牽涉法遵與業務,不是兩週能補完的——日期往後挪,剛好是讓你「提早做、做扎實」的窗口。
這幾個日期很容易記混,攤成一條線比較清楚哪些已經生效、哪些還在移動:
flowchart TB
    A["EU AI Act<br/>分階段生效"] --> B["2025-02 已適用<br/>禁止性實務<br/>AI 素養義務"]
    B --> C["2025-08 已適用<br/>GPAI 義務"]
    C --> D["高風險義務<br/>原訂 2026-08"]
    D -->|"2025 年底<br/>Digital Omnibus 提案"| E["往後推<br/>討論中落在 2027–2028<br/>撰稿時仍待正式定案"]
    D -.->|"網路上的舊懶人包"| X["「2026-08 高風險<br/>全面適用」<br/>已經過期"]
    E --> F["日期會動<br/>但別賭它會無限延"]
依風險排序:越是接觸機密資料、越是能造成不可逆動作的 agent,治理就要越完整;一個只查公開 FAQ 的內部小工具,不需要這整套。治理的強度應該對應風險的高度,這本身也是一種工程判斷。
小結
Agent 治理不只是上線審查時交出去的文件。它把平常散在各層的控制整理成三組:
- 控制誰能碰什麼:資料分級 + RBAC/ABAC 最小權限。
- 控制能做什麼:tool registry + 高風險動作的 HITL。
- 持續監督:audit log + eval + observability + cost。
這套做法的前提很務實:系統會犯錯、可能被濫用,品質也會隨模型和資料變化。治理的工作,就是按風險先設好邊界,再用紀錄與評估持續確認它沒有偏離。
最後一篇回到團隊。當人力只有 3 到 8 人時,這些架構、評估與治理工作要怎麼排進日常交付?
文章簡報
延伸閱讀
- 上一篇:延遲、可靠性與成本,該怎麼取捨?
- 回顧:權限感知檢索、Tool use 與 MCP、可觀測性與評估——治理框架的三個技術支柱
- 下一篇(完結):《帶領 3–8 人 AI 工程小隊:把交付做成固定節奏》