向量資料庫與 embedding 怎麼選?多數情況 pgvector 就夠用
本篇是「從 PoC 到 Production:企業 AI Agent 系統工程」系列的第 4 / 12 篇。你可以從系列總覽開始閱讀,也可以直接接著看本文。
這是「從 PoC 到 Production:企業 AI Agent 系統工程」系列第 4 篇(共 12 篇)。上一篇:RAG 架構實作。
上一篇把 RAG 的流程走了一遍,這篇來處理向量資料庫和 embedding。這兩個選擇會互相影響,也很容易一開始就做過頭。我遇過不少團隊還沒估資料量,第一句話已經是「我們要上 Pinecone」。
我的預設選擇其實很普通:
多數企業 RAG 可以先用 PostgreSQL + pgvector。等容量或查詢模式真的超出它的能力,再搬到專用向量庫也不遲。
為什麼先選 pgvector
pgvector 是 PostgreSQL 的 extension,讓既有資料庫也能存向量、做相似度檢索。我通常從它開始,原因有三個。
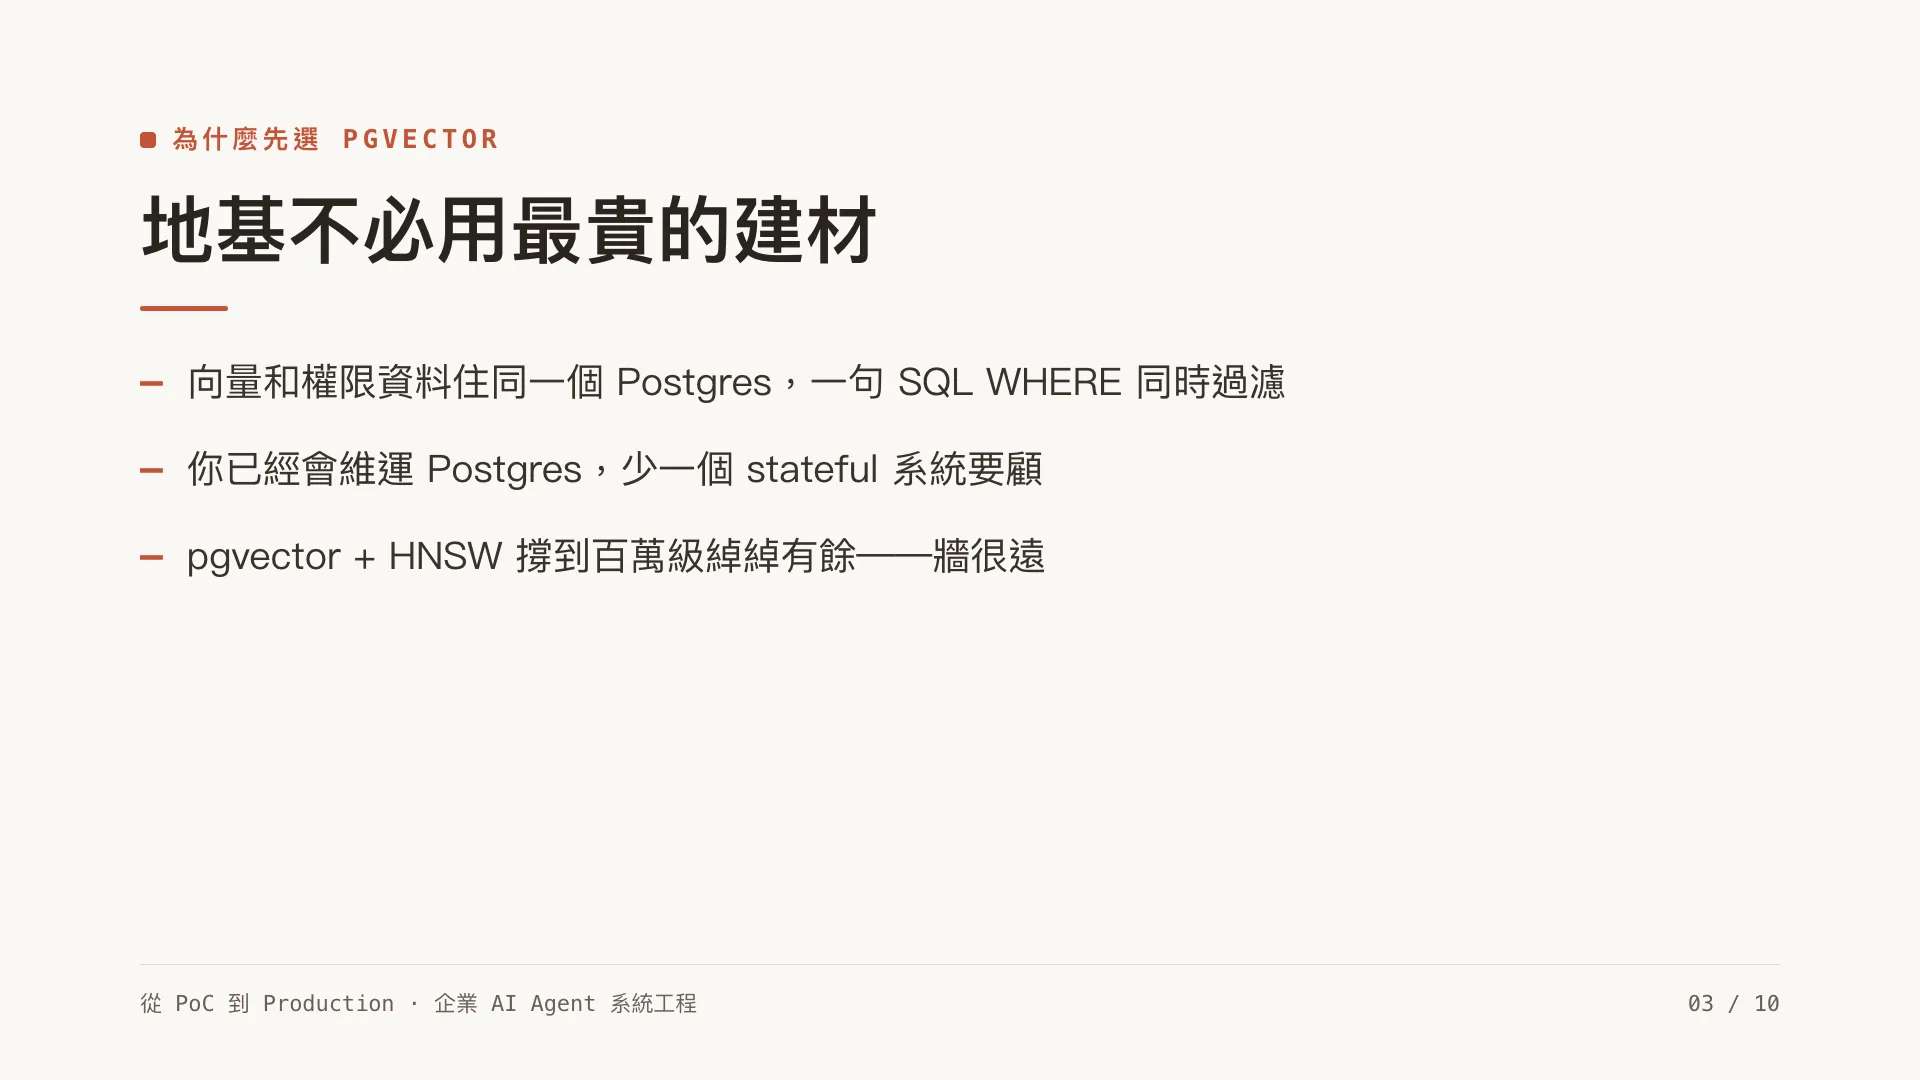
1. 業務資料和向量可以放在一起。 企業 RAG 最難處理的往往是權限(第 5 篇的主題)。如果向量和文件部門、機密等級、可讀群組都在同一個 Postgres,SQL 可以在排序相似度的同時套上權限條件。向量放 Pinecone、權限留在 Postgres 也不是不能做,只是同步與查詢路徑都會多一層,出錯的地方自然更多。
不過這句 WHERE 有個對企業權限過濾特別致命的細節:pgvector 做的是 post-filtering——先用 HNSW 取回 ef_search 個候選,再套 WHERE 過濾,不是 native pre-filtering。當權限很「選擇性」(例如某人只看得到全庫 2% 的文件),HNSW 撈回的候選很可能在 WHERE 之後幾乎被刷光,導致 recall 暴跌、甚至回傳不足——也就是「他其實有權看的相關文件,因為不在那批候選裡而檢索不到」。pgvector 0.8 的 iterative index scan 是緩解,但仍是 workaround。這正是第 5 篇權限感知檢索要正面處理的坑,也是 Qdrant 那種 native pre-filtering 相對 pgvector 真正有優勢的地方。能用一句 SQL 過濾權限是真的,但「零成本」是假的。
2. 團隊多半已經會維運它。 Postgres 的備份、replication、監控與調校都有成熟做法,團隊也可能早就在用。多一套專用向量庫,就多一個要學、要監控、要備份的 stateful 系統。對小團隊來說,少顧一套服務差很多。
3. 它的牆很遠。 pgvector 加上 HNSW index,撐到百萬級向量、合理的延遲,對絕大多數企業內部知識庫綽綽有餘。你真的要到千萬、上億向量、極端低延遲、超高 QPS,才會開始需要專用向量庫的本事。
先給一組數字讓「牆很遠」不只是口號:pgvector 0.8 + HNSW,100k 向量 p50 約 2ms、p99 約 4ms;2M 向量 p50 約 11ms、p99 約 22ms(recall 都在 0.95 以上)。對照 RAG 裡 LLM 本身一次呼叫就要 800–2000ms,向量檢索這層根本不是瓶頸。但這個好延遲有個前提,也是 pgvector 在 production 最常見的翻車點:HNSW index 要裝得進記憶體;一旦資料量讓 index 超過 shared_buffers、被 evict 到 disk,p99 會從個位數 ms 跳到數十甚至上百 ms——所以容量規劃真正要看的不是「幾筆向量」,是「index 大小 vs RAM」。而就算撞到這道記憶體牆,也先別急著跳 Pinecone:pgvectorscale(Timescale / Tiger Data 出的擴充)提供 StreamingDiskANN index,把圖存到 SSD、記憶體跟資料量脫鉤,直接解掉「HNSW 吃記憶體」這個痛點,公開 benchmark 在 5000 萬筆向量這個量級已能在成本與延遲上勝過 Pinecone。換句話說:百萬級用純 pgvector,要往千萬到低數億推就先加 pgvectorscale,真到「十億級+極端讀並發」再考慮專用庫——那堵牆比我原本寫的還遠一截。
什麼時候該上專用向量庫(Pinecone、Qdrant、Weaviate、Milvus,或 serverless 的 Cloudflare Vectorize)?
- 向量量級很大(千萬以上)且要極低延遲
- 你需要它特有的功能(某些 metadata filtering、multi-tenancy 的原生支援)
- 你的架構本來就 serverless / edge,配 Vectorize 這類比自己顧一台 Postgres 更省事
與其把它們含糊歸成一組「專用向量庫」,2026 的市場其實有清楚分工:Milvus / Zilliz 是真・十億級企業規模的代表;Qdrant(Rust 寫的)強在高效能的 filtered search 加上最靈活的 multi-tenancy / sharding——剛好是企業權限場景的首選;Weaviate 主打內建 hybrid search;Pinecone 是全託管 serverless 的開創者,零容量規劃但較貴。至於決策表裡推薦給 serverless 的 Cloudflare Vectorize,選之前要先確認一個硬限制:單一 index 上限 1000 萬向量(2026-01 才從 500 萬翻倍)、維度上限 1536。它適合「資料量在數百萬以內、而且本來就跑在 CF Workers / Pages」的場景;接近千萬就得靠多 index / namespace 拆,別讓它跟你決策表裡「千萬就該換庫」那條自己打架。
把上面這些條件串起來,實際選型的順序長這樣——注意 pgvector 到專用庫之間還有一階,很多人會直接跳過:
flowchart TD
    S{"你本來就有 Postgres 嗎?"}
    S -->|"沒有,架構本來就 serverless / edge"| V["Cloudflare Vectorize<br/>先確認單 index 上限 1000 萬向量"]
    S -->|"有"| Q1{"向量量級大概多少?"}
    Q1 -->|"百萬以內"| P1["pgvector<br/>權限能跟相似度寫在同一句 SQL"]
    Q1 -->|"千萬到低數億"| P2["pgvector + pgvectorscale<br/>StreamingDiskANN 把 index 移到 SSD"]
    Q1 -->|"十億級且極端讀並發"| D["專用向量庫<br/>Milvus / Qdrant / Weaviate / Pinecone"]
    P1 --> W{"權限很選擇性嗎<br/>只看得到全庫的幾 %?"}
    W -->|"是"| N["留意 pgvector 是 post-filter<br/>recall 會被權限吃掉,見第 5 篇"]
    W -->|"否"| OK["就這樣,先別換"]
那個容易被跳過的中間階是 pgvectorscale:撞到「HNSW 裝不進記憶體」這道牆時,它把圖搬到 SSD,讓記憶體跟資料量脫鉤——所以牆比多數人以為的還遠一截,不必一撞牆就跳去專用庫。
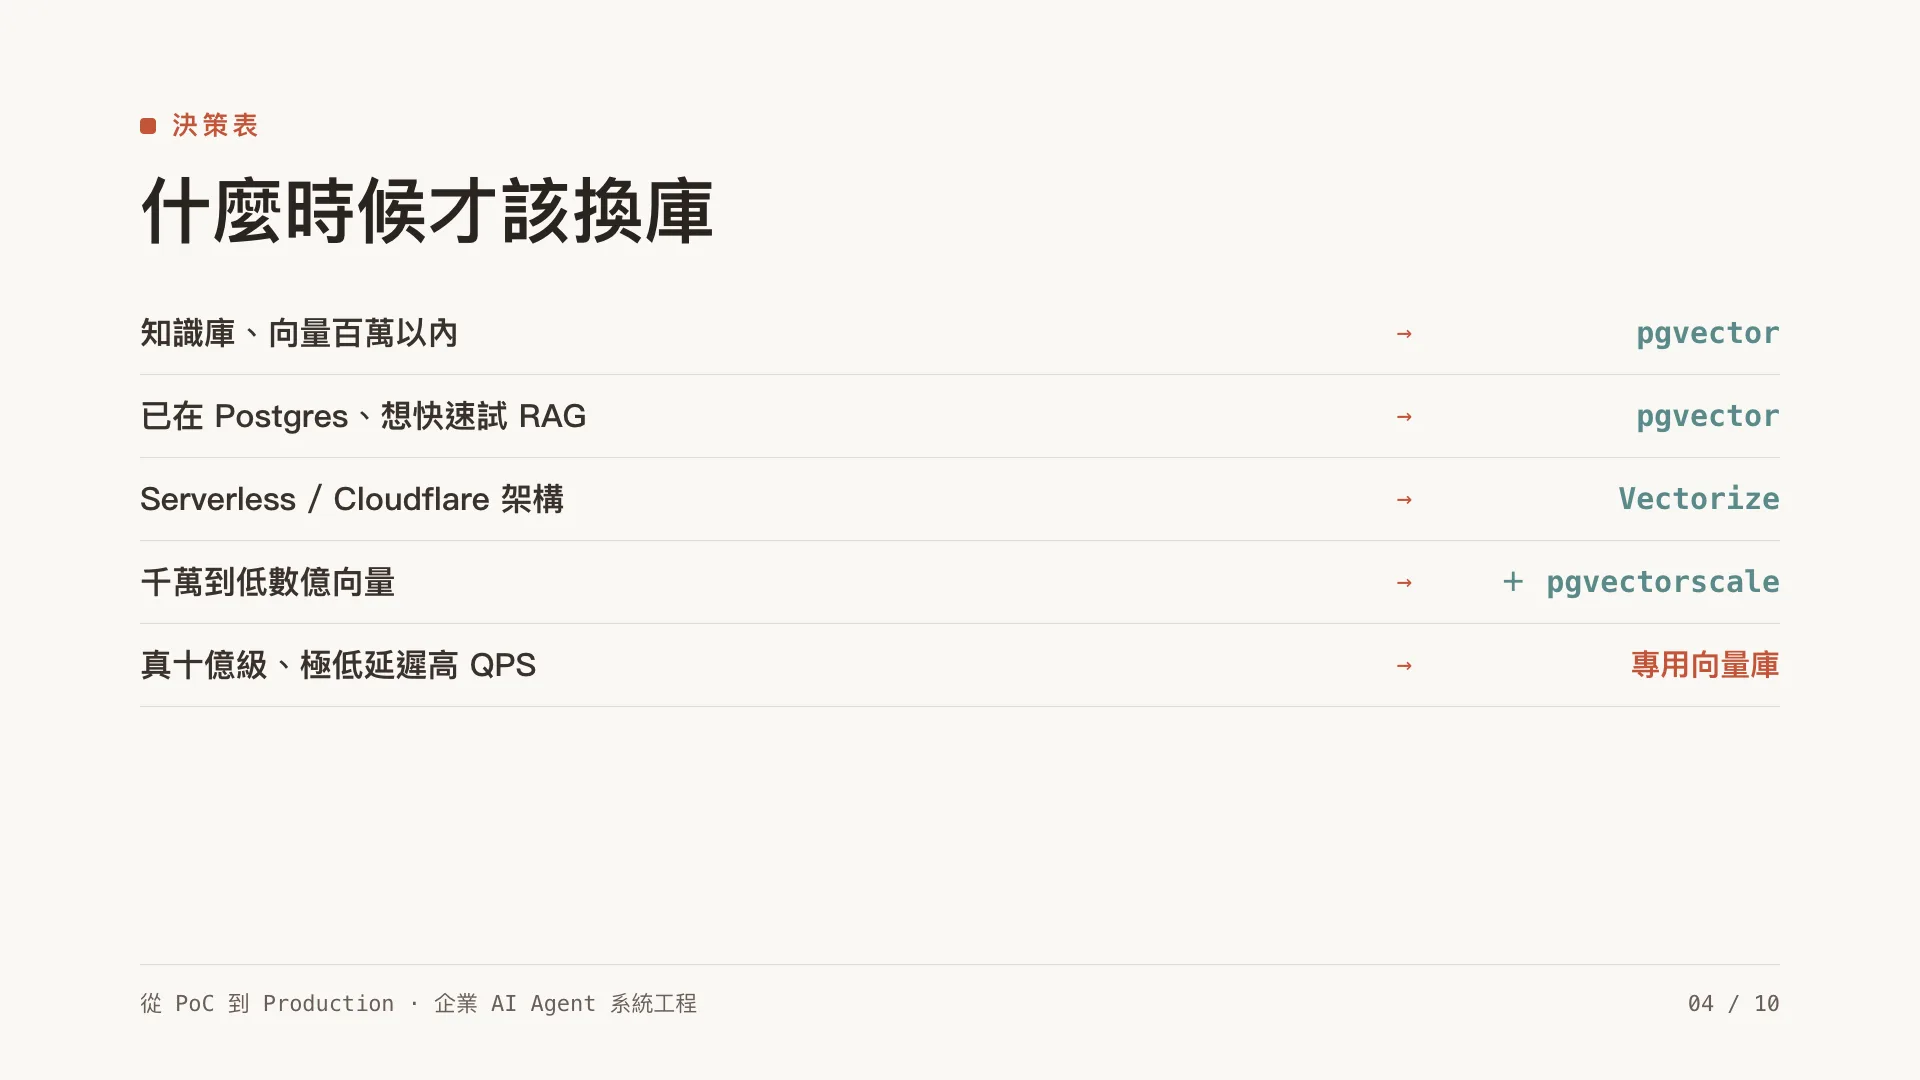
決策表
| 情境 | 建議 | 為什麼 |
|---|---|---|
| 企業內部知識庫、向量 < 百萬 | pgvector | 權限好做、維運成本低、夠快 |
| 已經在 Postgres 上、想快速試 RAG | pgvector | 不必多養一個系統 |
| Serverless / Cloudflare 架構 | Vectorize | 跟既有 edge 架構同源 |
| 千萬級向量、極低延遲、高 QPS | 專用向量庫 | pgvector 開始吃力 |
| 需要原生 multi-tenant 隔離 | 專用向量庫 | 某些庫對此支援較成熟 |
我一向偏好先用團隊已經熟悉的資料庫。新工具當然可以上,但最好先講清楚:它到底解決了哪個既有工具做不到、或做起來代價太高的問題,而不只是看起來比較新。
Embedding 模型:換一次就要付一次成本
Embedding 模型負責把文字變成向量。它的選擇牽涉幾個取捨,而且有一個很現實的約束:
一旦你用某個 embedding 模型把整個知識庫向量化了,要換模型就等於整庫重算。
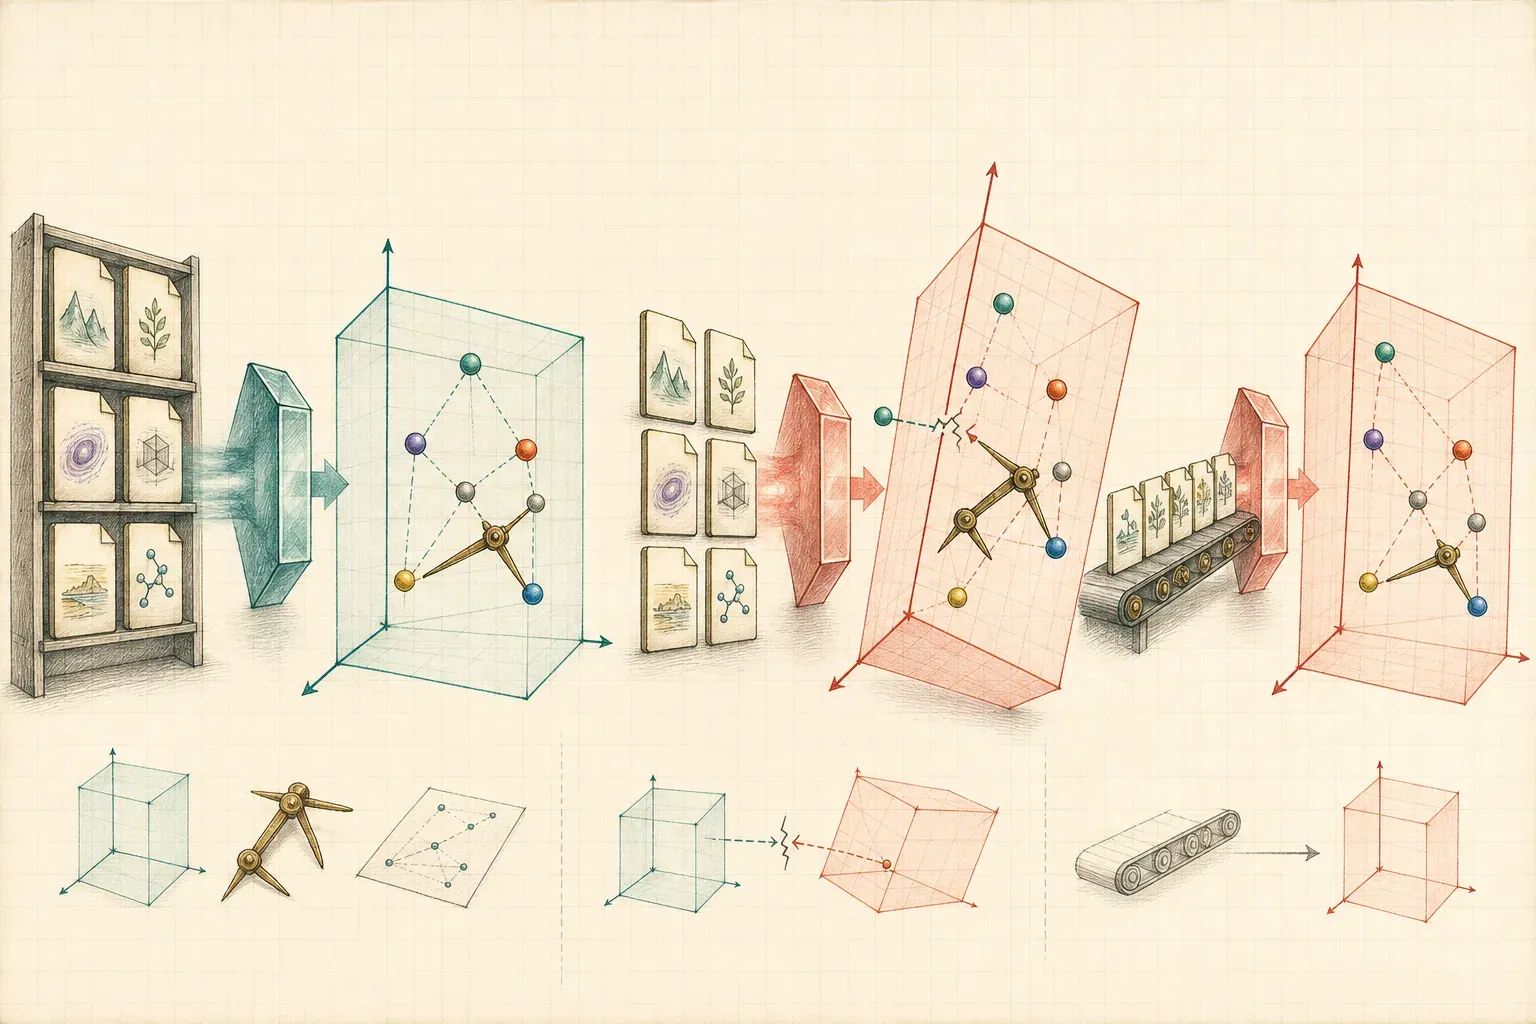
因此選模型前,至少要看下面四件事。
1. 維度(dimension)。 embedding 向量的長度。維度高,理論上能表達更細的語意,但每一筆都更佔空間、檢索更慢、index 更大。維度低則相反。不是越高越好——要對應你的資料複雜度和規模。很多場景中等維度就夠,盲目追高維度只是讓成本上升。
這裡有個 2026 的好消息能把「不是越高越好」從原則變成工具:2024 後主流模型(OpenAI 的 text-embedding-3、Qwen3-Embedding 等)多用 Matryoshka representation learning(MRL) 訓練——同一個向量可以「截斷」到較短維度仍保有大部分檢索品質。意思是你可以存高維、查短維,依成本和延遲動態取捨,不必一開始把維度賭死。官方數據夠說服力:text-embedding-3-large 截到 256 維,MTEB 表現仍勝過舊的 ada-002 在 1536 維。pgvector、Qdrant 都支援這種維度截斷。
2. 領域契合度。 通用 embedding 模型對一般語意很好,但如果你的資料充滿專業術語(半導體製程、醫療、法律、特定產品料號),通用模型可能抓不準那些術語之間的關係。這時候要嘛選領域更貼的模型,要嘛用 hybrid search(下面講)補。
3. 多語言。 台灣企業常常中英夾雜,文件裡專有名詞是英文、敘述是中文。要確認你選的 embedding 模型對中英混合的處理夠好——這點一定要用你自己的真實資料測,不要看 benchmark 數字就信。
「要測」之後總得知道「先測哪幾個」。2026 中英 / 多語的開源實務首選蠻明確,可以從這兩個開始:BGE-M3(100+ 語言,原生支援 dense + sparse + multi-vector——它的 sparse 輸出剛好能直接餵上面講的 hybrid search)和 Qwen3-Embedding 系列(0.6B / 4B / 8B,MMTEB 多語榜領先,還支援前面提的彈性維度)。但這只是起跑點,最終仍以你自己的中英混合資料為準。順帶一提,這兩個都是開源權重,要完全不出境就自架,剛好接到下面的「自架 vs API」。
4. 自架 vs API。 用 OpenAI / Cohere 之類的 embedding API 方便,但你的文件內容會送出去。「會送出去」是真的,但別把它講成「直接觸法」——更精準的說法是:這是資料治理與(個資)跨境、合約風險,是否觸法取決於你的資料分級、產業法規(醫療 HIPAA、個資跨境)和有沒有簽約。實務上主流 API 的預設政策沒那麼可怕(預設不拿輸入訓練模型、僅短期保留),企業還能簽 DPA、申請 Zero Data Retention、或用 Azure OpenAI 做 region pinning 來緩解。但對最敏感的資料,最乾淨的解法仍是自架——2026 的 BGE-M3、Qwen3-Embedding 都是開源權重,可在自家 GPU / VPC 跑、資料完全不出境。這是資料治理(第 11 篇)會回來的議題。
Hybrid Search:語意之外,字面也要中
純向量檢索(語意相似)有個盲區:它對「必須字面精準命中」的東西不可靠。使用者問「錯誤碼 E-1043 怎麼解」,語意檢索可能撈回一堆「跟錯誤排除有關」但不是 E-1043 的東西。
解法是 hybrid search:把向量檢索(dense,語意)和關鍵字檢索(sparse,BM25,字面)合起來,兩邊的結果用一個加權(或 reciprocal rank fusion)合併。
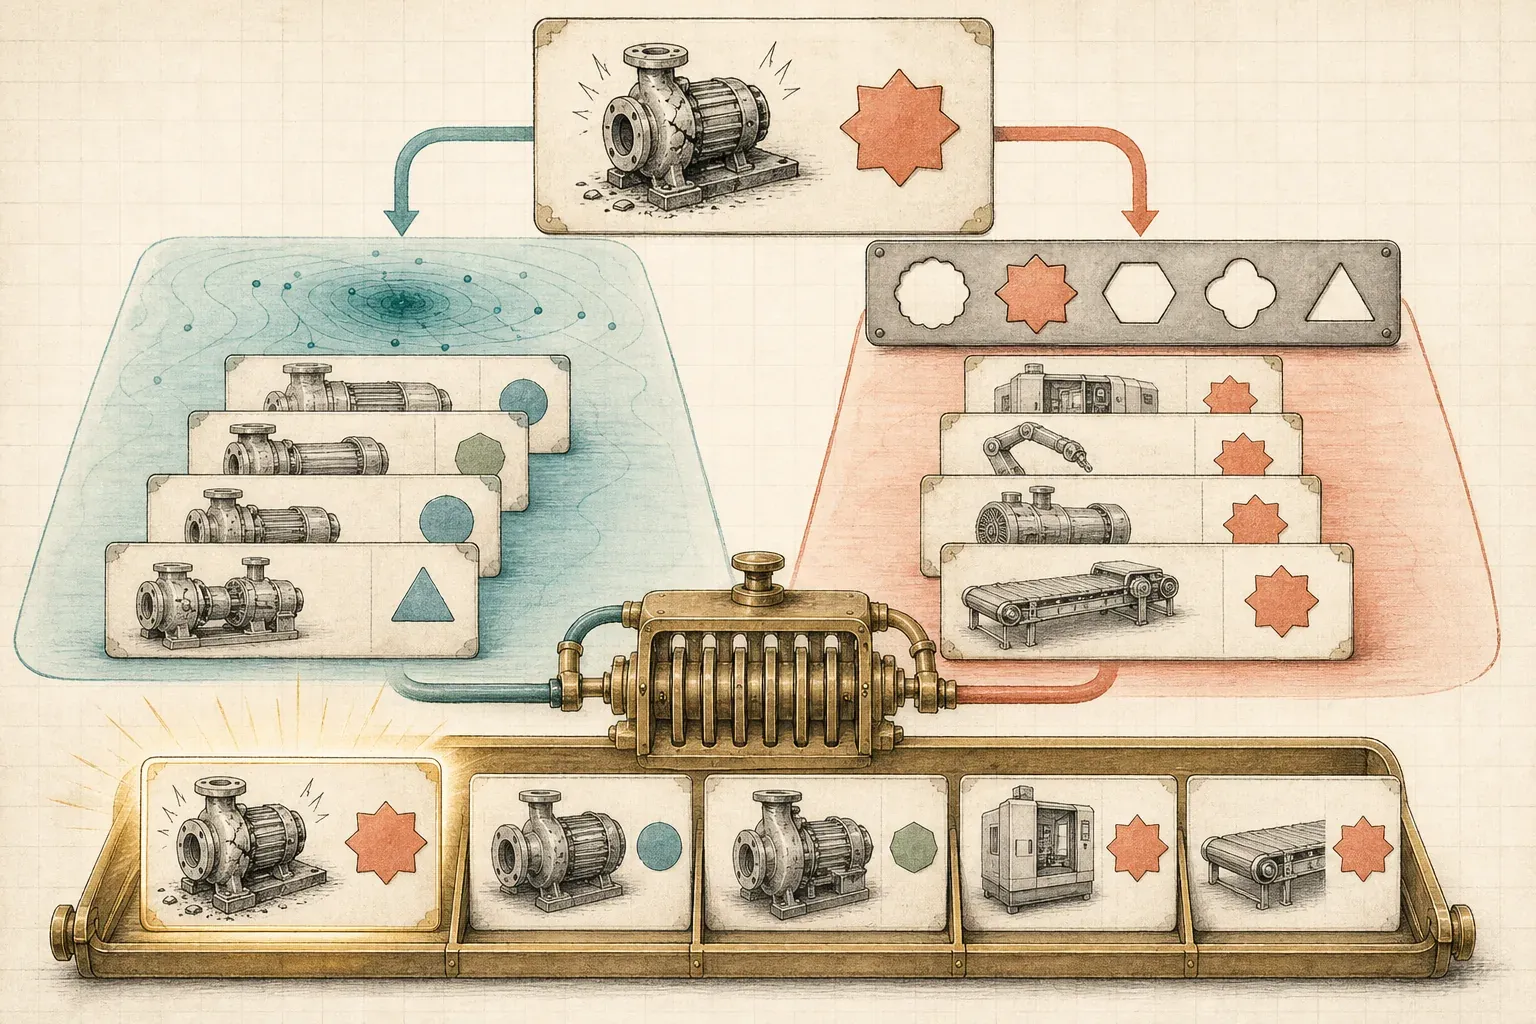
- 料號、錯誤碼、人名、API 名稱這種精準字面 → 關鍵字救場
- 「怎麼讓系統跑更快」這種模糊語意 → 向量救場
企業資料常常兩種都有,所以 hybrid search 在 production RAG 幾乎是標配。pgvector 也能跟 Postgres 的全文檢索(或 tsvector)組成 hybrid,不一定要專用庫。
不過這裡要拆穿一個很多人沒注意的細節:Postgres 原生的 tsvector / ts_rank 不是 BM25。它沒有 IDF、沒有 term-frequency 飽和、也沒有用文件長度做正規化——而這三件事正是 BM25 的精華。所以 pgvector + tsvector 確實能組出語意+字面的 hybrid,但它的字面排序品質明顯遜於真 BM25。想在 Postgres 跑真 BM25,得另外裝擴充:ParadeDB 的 pg_search(底層 Tantivy)、VectorChord-BM25,或 TigerData 2026 推的 pg_textsearch。值不值得多裝一個擴充,看你的料號、錯誤碼這類字面命中有多重要。兩路結果的合併同樣建議用 RRF(reciprocal rank fusion,k=60),用排名而非分數,免去 BM25 與向量分數量綱不一的麻煩。
Index:HNSW vs IVF,你至少要知道在選什麼
向量檢索如果每次都跟全部向量算距離(暴力檢索),量一大就爆。所以要建 index 做近似最近鄰(ANN)。兩個最常見的:
- HNSW(圖結構):檢索快、召回率高,但建 index 慢、記憶體吃得兇。適合「寫入不那麼頻繁、但要查得快」的知識庫——大多數 RAG 屬於這類。
- IVF(分群):建得快、省記憶體,但別把它的品質落差想成「平滑地略遜」——它更像「沒調好就斷崖」。IVFFlat 預設
probes=1(只搜最近的一群)召回會很差,要把probes調到約 10–100 才平衡;而且向量分布不均勻、群聚或稀疏時(企業文件很常是這樣)recall 會再掉一截。更實際的是 pgvector 的 IVFFlat 不能建在空表上,得等資料進來、有足夠樣本才能算分群中心,資料大幅成長後分群還會走樣、要重建。HNSW 沒有這個訓練步驟,空表就能建、邊插邊長,預設參數通常就有 95%+ recall——對「持續 ingest」的知識庫省事得多。
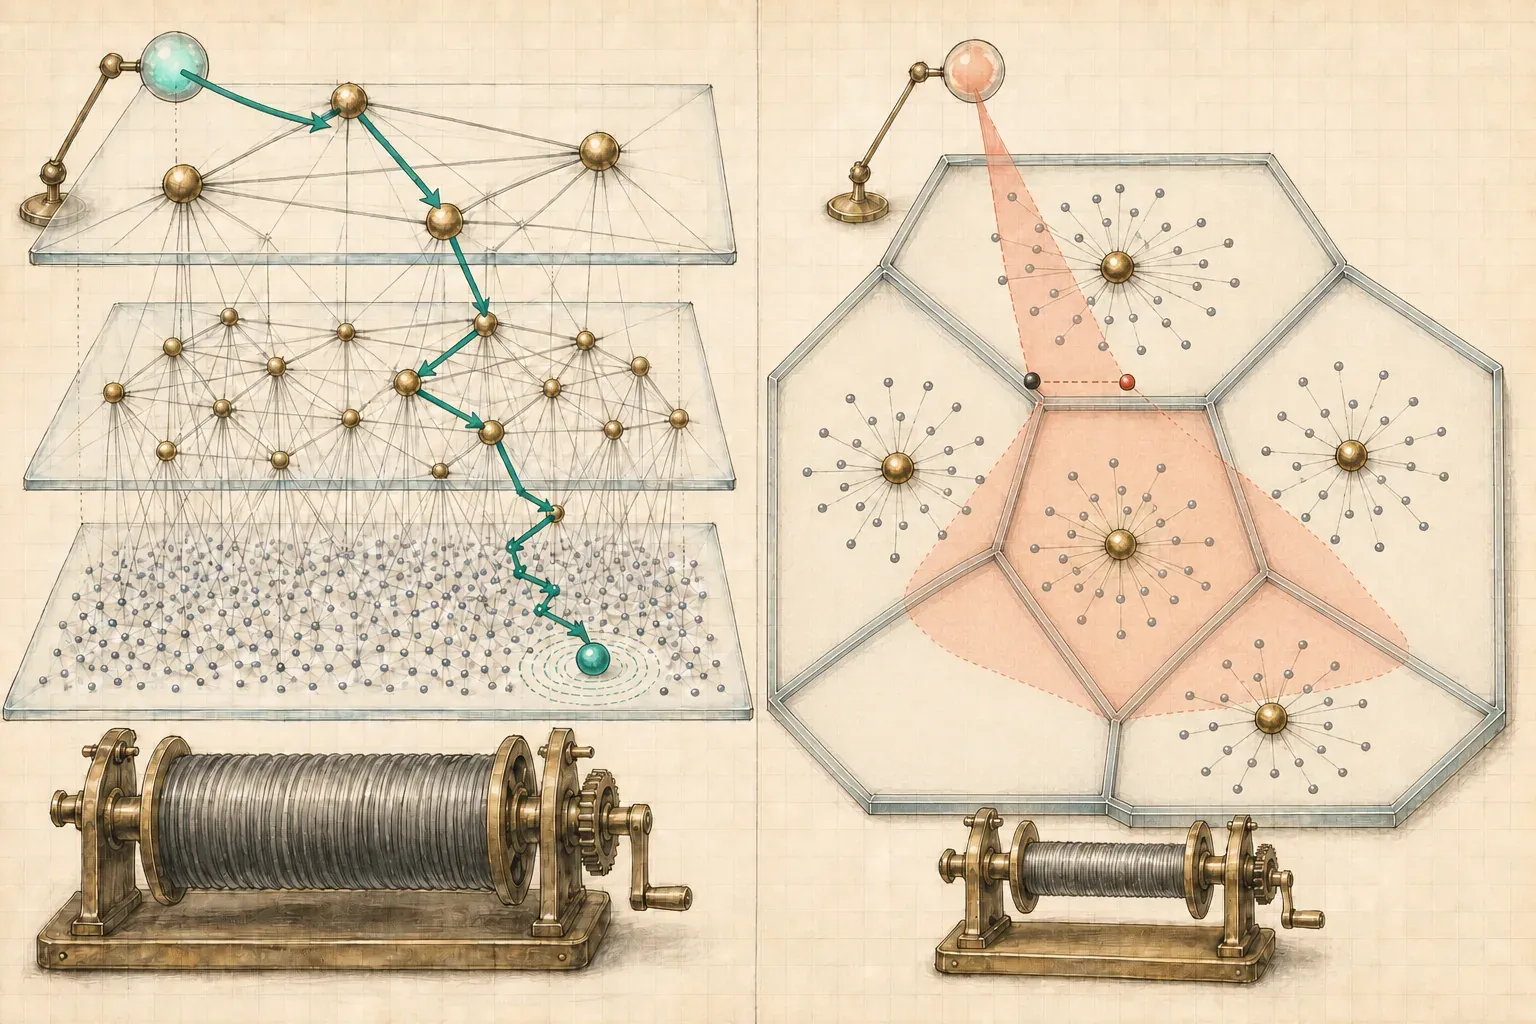
對大部分企業 RAG,HNSW 是預設好選擇,因為知識庫通常是「偶爾更新、大量查詢」。但要記得它吃記憶體——這會回到你的成本(第 10 篇)。
不必死背兩種索引的所有細節,但要知道向量檢索是近似結果。調整 index 參數時,就是在召回率、速度和記憶體之間換取平衡。
既然講到「有參數可調」,就把那幾顆旋鈕的名字交給你:HNSW 上線後主要調 hnsw.ef_search(預設 40,可往上調到 1000,越大召回越高但越慢——而且它是唯一不用重建 index 就能即時拉 recall 的旋鈕,production 救火很關鍵);建 index 時影響品質的是 m(預設 16)和 ef_construction(預設 64)。IVFFlat 則是調 lists(建索引時分幾群)和 probes(查詢時搜幾群)。
資料新鮮度:別讓庫裡躺著過期的真相
最後一個 production 才會痛的問題:文件會改,向量庫要跟著更新。
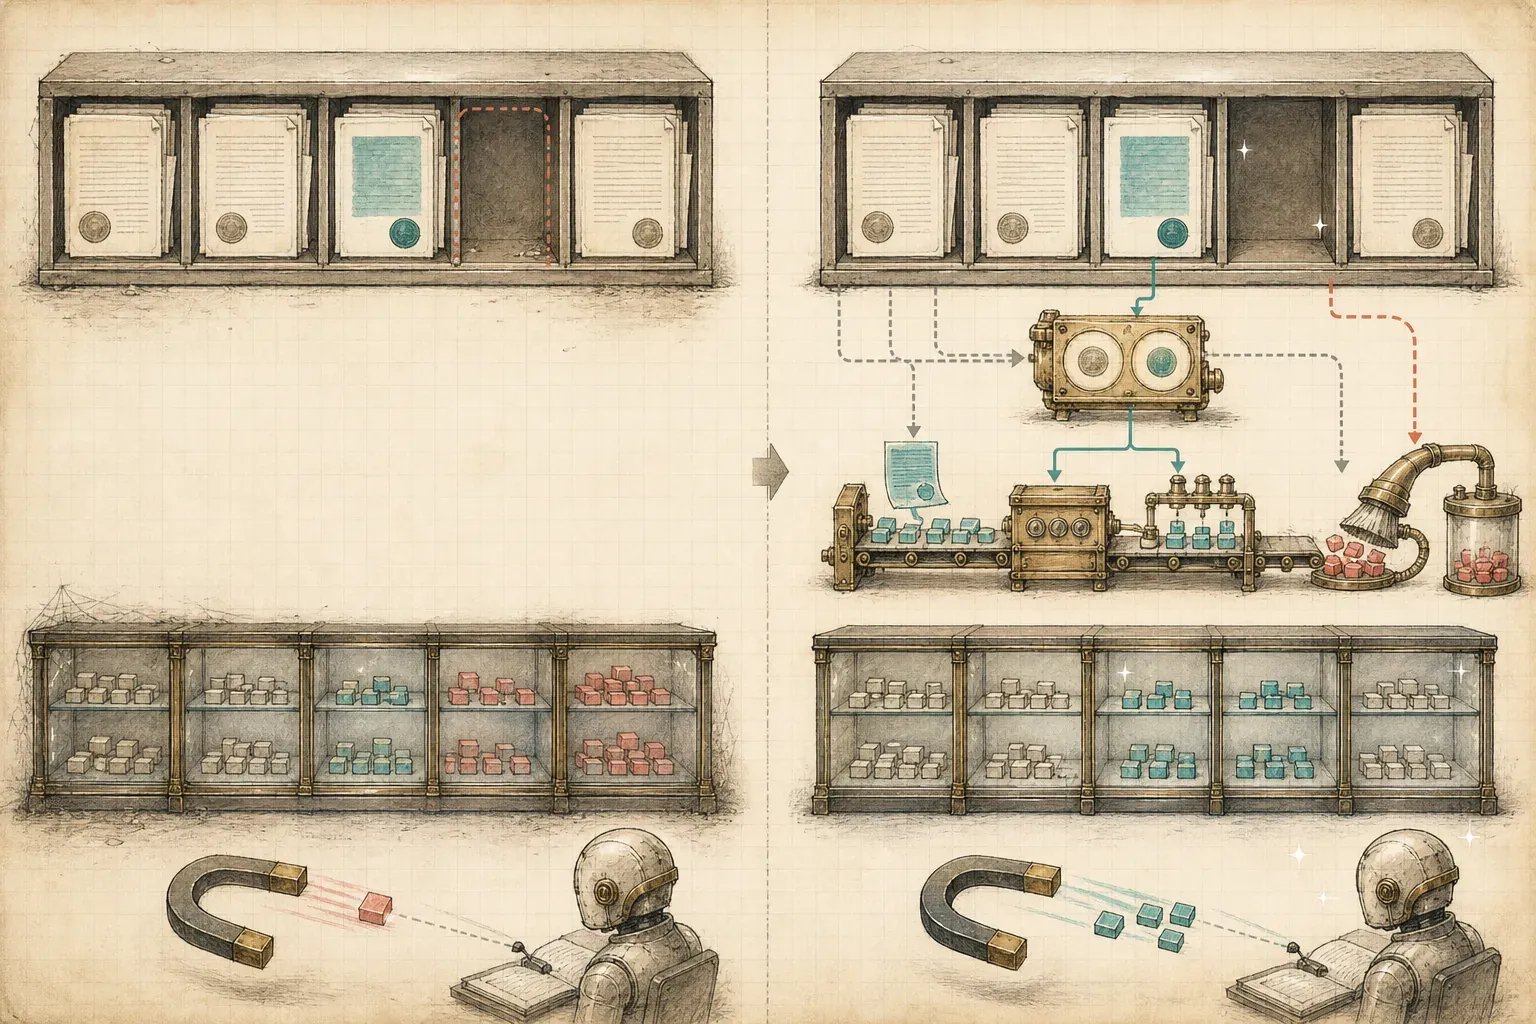
- 增量更新:文件異動時,只重新處理那幾份(重新 chunk + embedding + upsert),而不是整庫重建。需要你在 ingestion 時記好每份文件的版本 / hash。
- 刪除與失效:文件下架了,對應的向量也要刪,不然 agent 會引用一份已經不存在的「真相」。
- 重新 embedding 的成本:如果哪天真要換 embedding 模型,整庫重算的時間和錢要先算進去——這也是為什麼一開始就要選對。不過這條「換模型=整庫重算」的鐵律,到 2026 也能鬆一點綁:出現了一類「embedding migration adapter」做法——訓一個輕量轉換層把新模型映射回舊向量空間、沿用既有 index,代表性的 Drift-Adapter(EMNLP 2025)宣稱能回復 95–99% 的召回、成本比整庫重建低兩個數量級。但這是有損近似,追求最高品質仍會老實重算——所以「選對」還是重要,只是換模型不再是非死即生的局。
小結
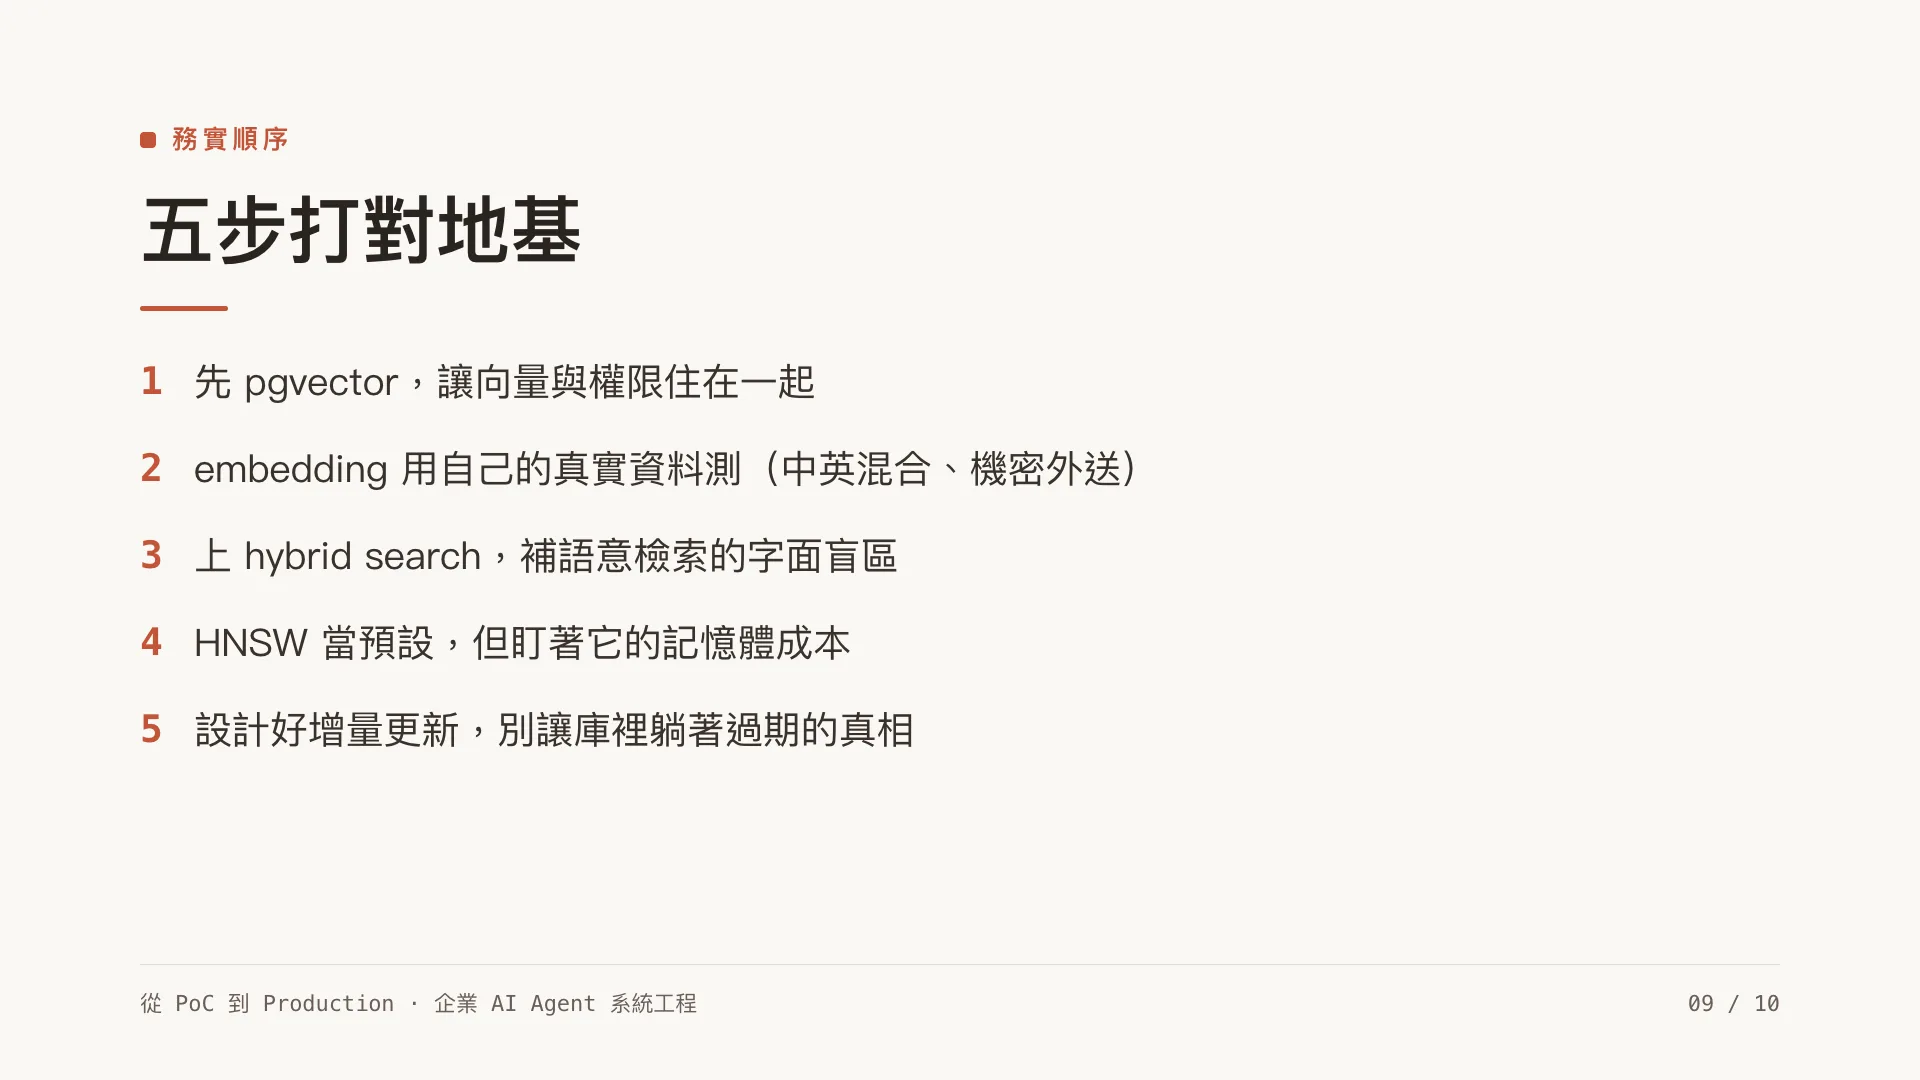
這一層不需要一開始就選最貴的方案。我會照下面的順序做:
- 先 pgvector,讓向量和權限資料住一起、少養一個系統。
- embedding 模型用自己的真實資料測,特別是中英混合和機密外送問題。
- 上 hybrid search,補語意檢索的字面盲區。
- HNSW index 當預設,但盯著它的記憶體成本。
- 設計好增量更新,別讓庫裡躺著過期的真相。
下一篇處理權限感知檢索:同一套知識庫給不同人查詢時,怎麼確保每個人只拿得到原本就有資格看的內容。
文章簡報
延伸閱讀
- 上一篇:RAG 架構實作
- 用 Cloudflare Vectorize 與 AI Gateway 打造 RAG——一個具體的向量檢索實作
- 下一篇:《企業 RAG 的權限怎麼做?》