生產級 LLM 的評估與可觀測性:每次改動都要知道有沒有退步
本篇是「從 PoC 到 Production:企業 AI Agent 系統工程」系列的第 9 / 12 篇。你可以從系列總覽開始閱讀,也可以直接接著看本文。
這是「從 PoC 到 Production:企業 AI Agent 系統工程」系列第 9 篇(共 12 篇)。上一篇:多代理協作。
Demo 階段通常靠幾個人工問題確認效果,正式上線後就不夠了。Prompt 改一個字、模型換一版、檢索參數調一下,都可能同時修好某些問題,又讓另一批問題退步。
這就是 eval 和 observability 要處理的事:前者回答「改完有沒有變好」,後者回答「這次為什麼出錯」。缺少 eval 的 agent 專案,就像沒有回歸測試的軟體,很難長期維護。
為什麼 agent 的「測試」這麼難,但更不能省
傳統程式常能用固定輸入、固定輸出和 assertEqual 來驗證。
Agent 不太一樣。輸入「請幫我總結這份報告」,每次用字都可能不同;兩個版本都可能正確,也可能看起來很像,其中一個卻誤解了原文。只比字串無法判斷。
輸出不固定並不代表只能靠感覺。若長期只用「我試了幾題還不錯」判斷,下面幾種退步很容易漏掉:
- 你換個模型版本(連 vendor 都可能 silent update),行為就漂移。
- 你改一句 prompt 修好 A 問題,常常默默弄壞 B 問題。
- 你調個檢索參數(第 3、4 篇),不知道整體變好還變壞。
所以測法需要調整,但不能直接省略。至少要有一組固定題目,讓每次改動都能和上一版比較。
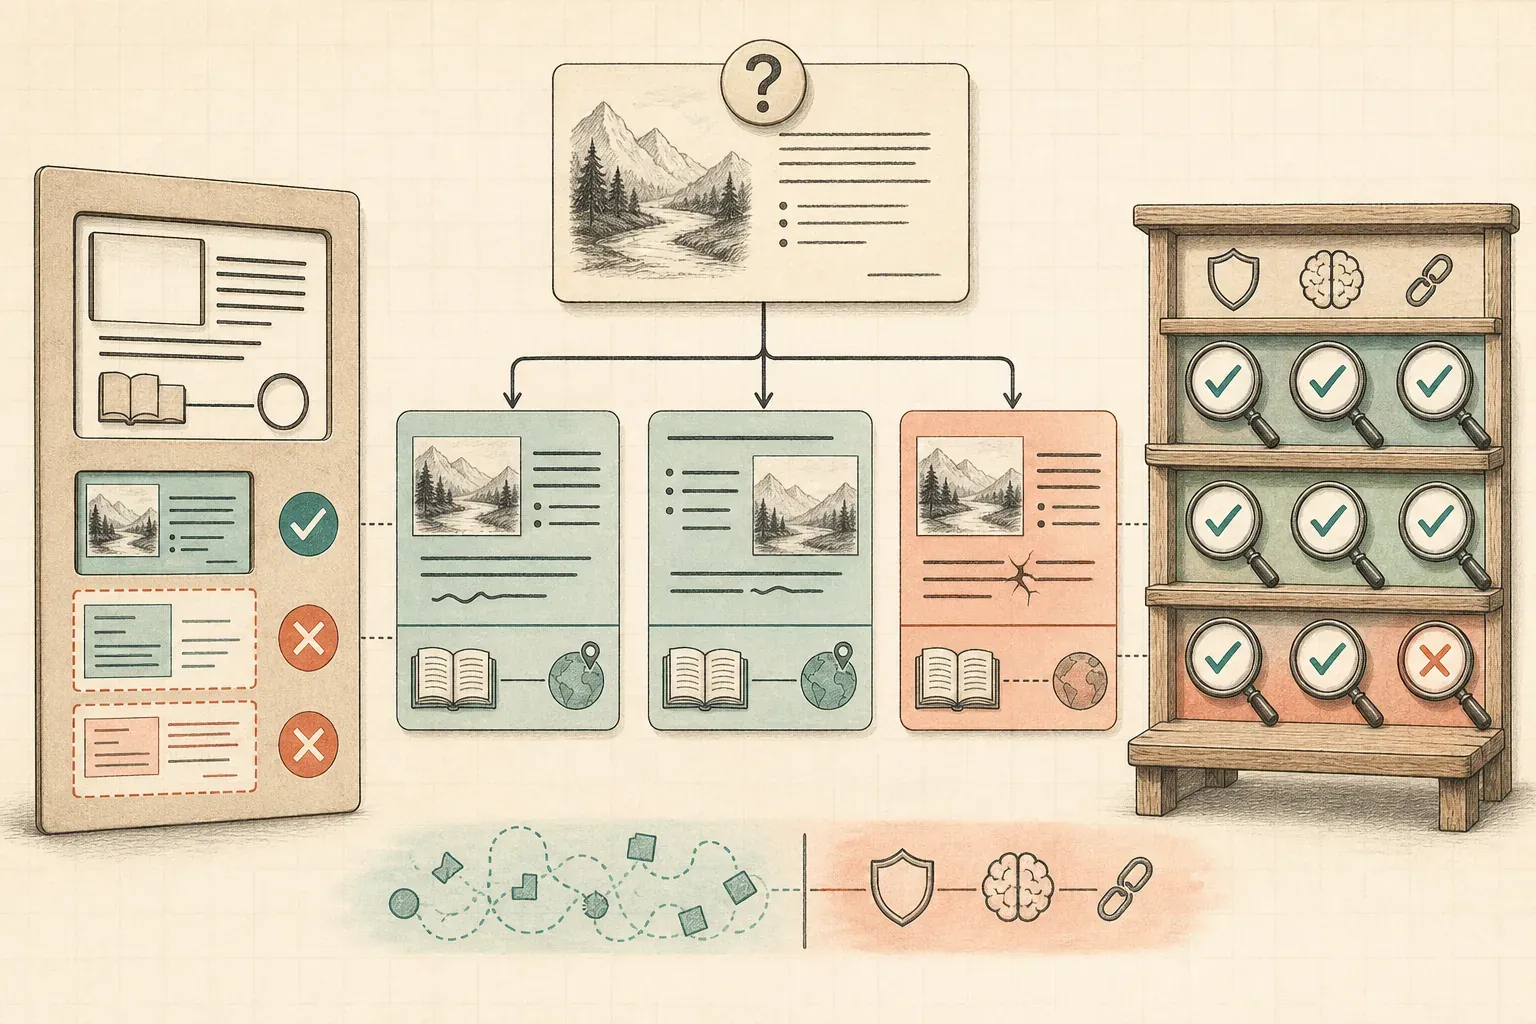
Eval Harness:給 agent 蓋一套測試
1. 黃金題庫(golden set)
準備一組「問題 + 期望答案 / 期望性質」的題目,涵蓋常見情境、邊界情境、和已知會出包的情境。每次你改任何東西(prompt、模型、檢索),自動把整組題庫跑一遍,看通過率。
這就是 agent 版的回歸測試。題庫不必一開始就很大,先整理 30 題最常見、風險最高的情境,已經比完全沒有基準好得多。之後每遇到一個線上問題,就把它補進題庫。
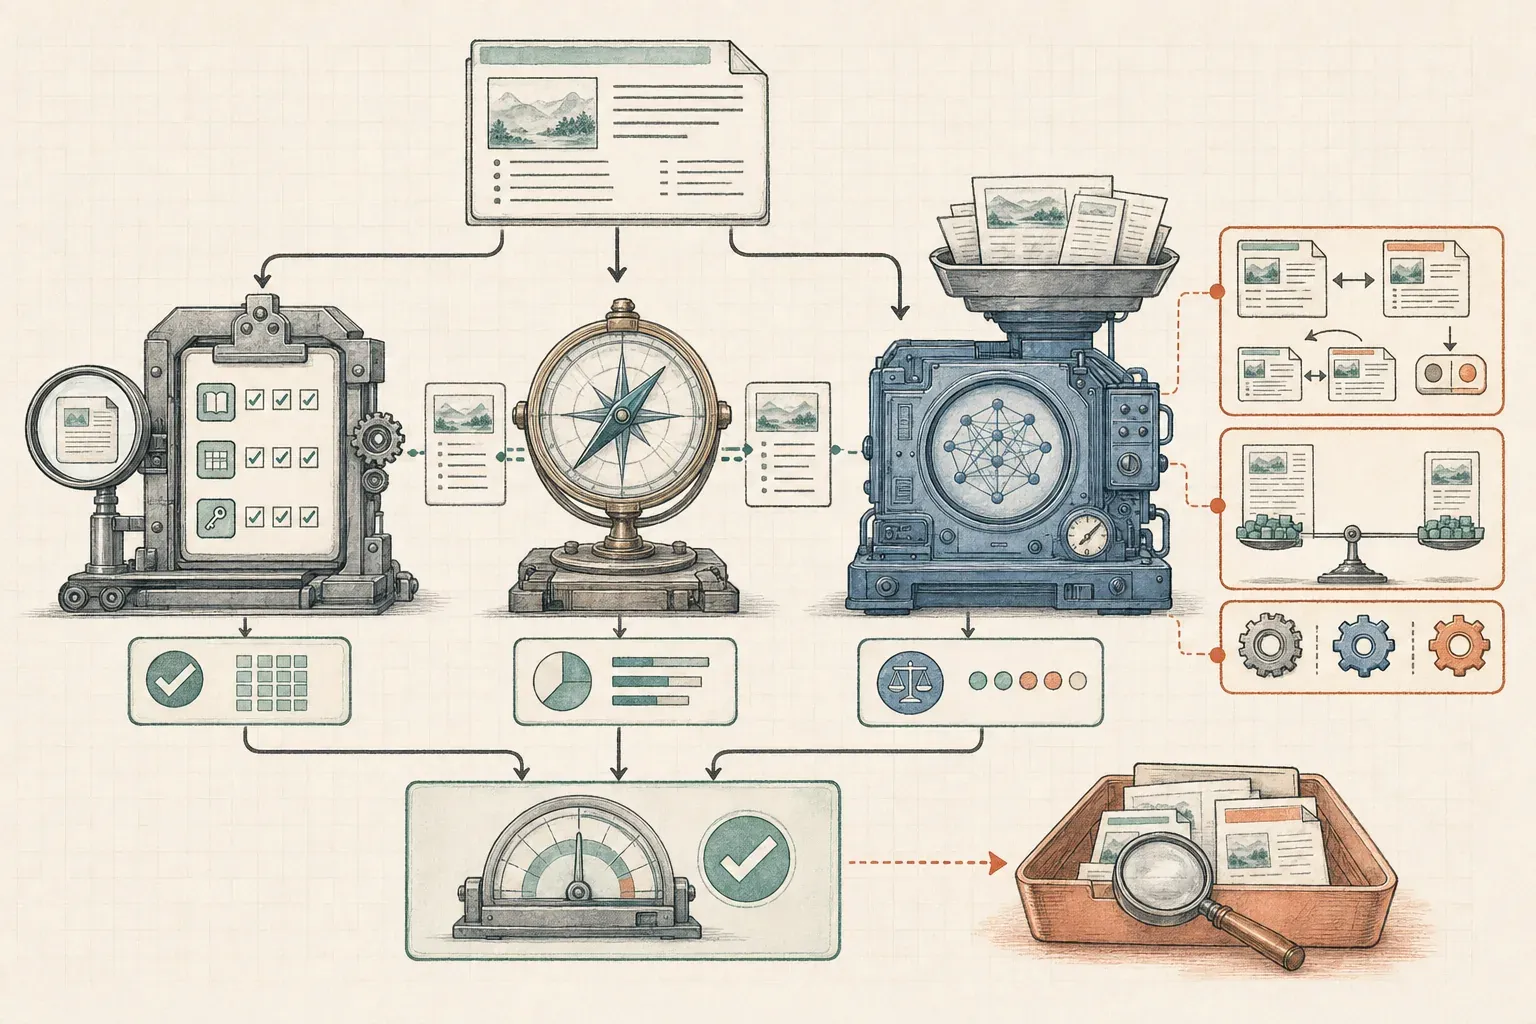
2. 怎麼判斷「答對」:三種尺
輸出不固定,怎麼自動判分?由寬到嚴:
- 規則 / 字串:答案裡有沒有包含某關鍵事實、有沒有附來源、格式對不對。便宜、確定,但只能驗「硬性質」。
- 語意比對:用 embedding 比對答案和標準答案的語意相近度。能容忍用字不同。
- LLM-as-judge:用另一個(通常更強的)模型,照你給的標準(正確性、完整性、有沒有幻覺)來評分。最有彈性,但「要小心偏誤」不是句口號——judge 有三個有名字、可被緩解的已知偏誤要主動防:position bias(偏好排前面的答案,緩解法是交換順序評兩次取一致)、verbosity bias(偏好較長的答案,即使長度沒帶來品質)、self-preference bias(偏袒自己或同家族模型的輸出——所以別拿同一個模型既當 judge 又當被評對象)。把這三個釘死,「要小心」才從感覺變成可勾的檢查清單,也才需要搭配規則與語意比對交叉驗證。
實務上常常三種混用:硬性質用規則、整體品質用 LLM-as-judge。
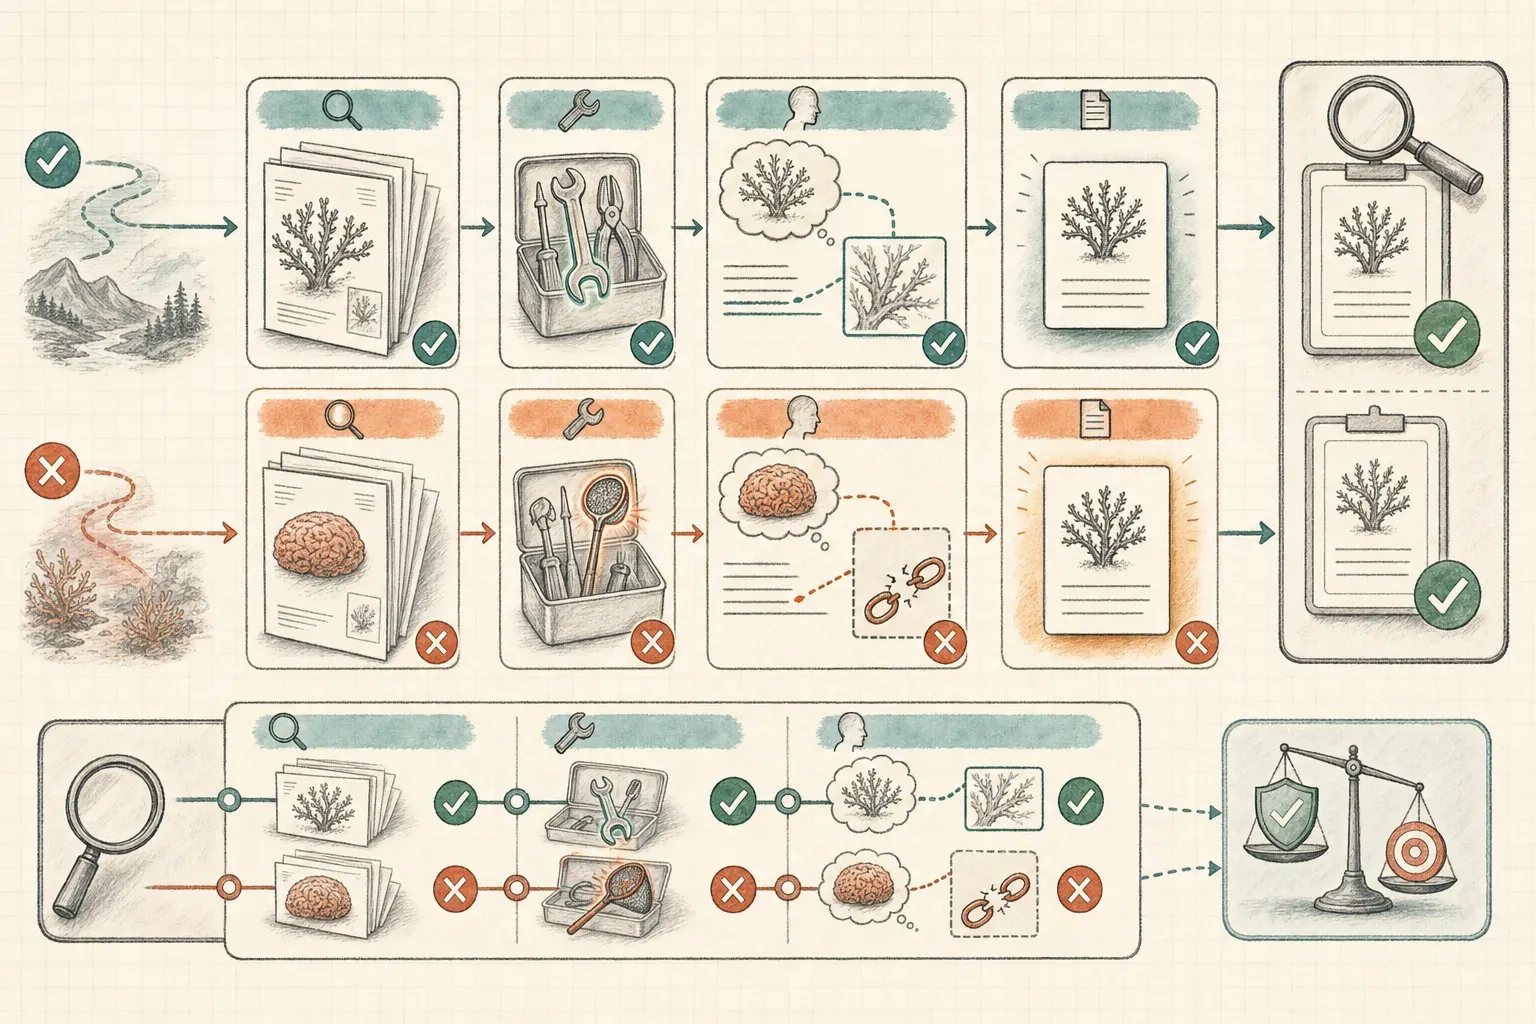
3. 別只測最終答案,要測中間步驟
對會做事的 agent,光看最終輸出不夠。一個答案剛好對,不代表過程沒問題(可能檢索撈錯,但模型瞎猜對了)。所以 eval 也要看:它檢索到的東西對不對、它選的工具對不對。這需要下面的 tracing 撐著。
這幾件事在業界都有正式名字,方便你搜:整條決策路徑對不對叫 trajectory evaluation(軌跡 / step-level evaluation);檢索層有現成指標——context precision / recall(該撈的有沒有撈到、撈到的對不對)和 faithfulness(答案有沒有忠於檢索內容,也就是抓幻覺),RAGAS、Arize Phoenix 都內建;工具選對沒對則看 tool-selection accuracy。白話講對是第一步,知道學名你才搜得到工具去自動量它。
Tracing:把 agent 的黑盒打開
第 1 篇的鴻溝三講過:agent 答錯,你常常什麼線索都沒有。Tracing 就是要把那條從問題到答案的完整路徑,變成一條可以攤開來看的紀錄。
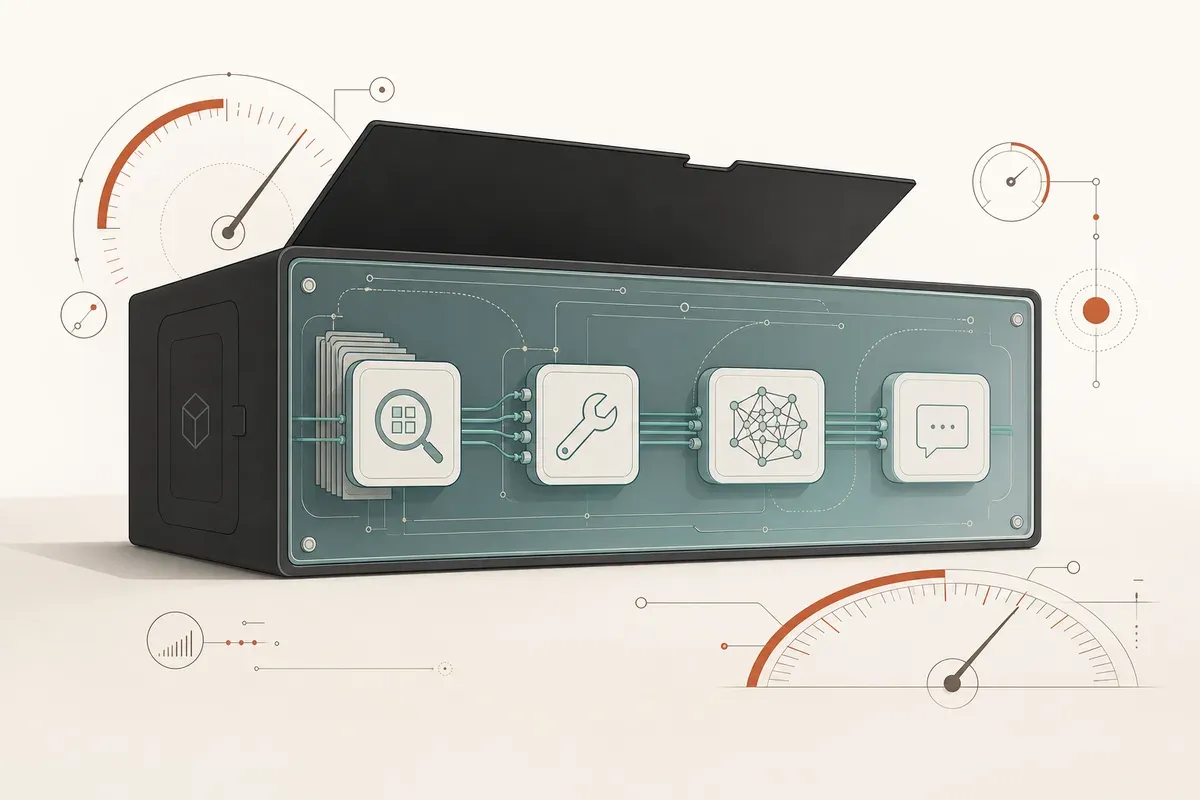
對 agent,一條 trace 應該記錄這些 span:
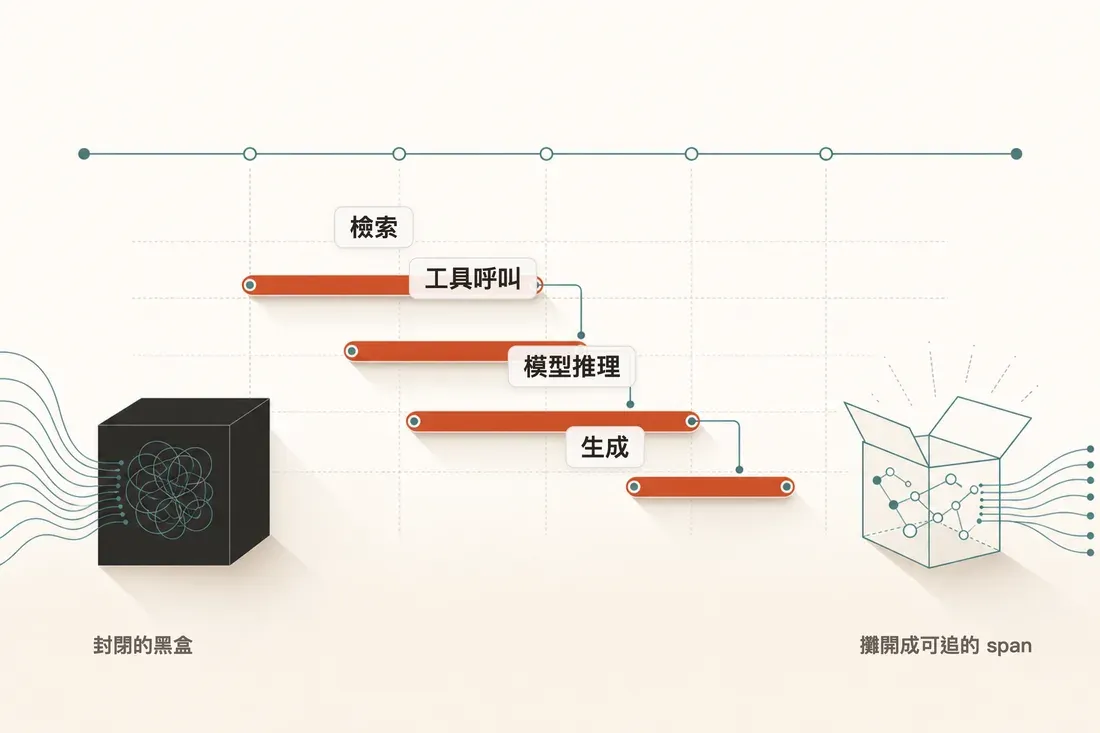
把一個 agent 請求拆成檢索、工具、模型、生成幾個可量測的 span——打開黑盒,每一步的耗時與花費都看得見。
有了 trace,除錯時就能逐段查:檢索是否撈錯、工具是否回傳異常資料,或模型拿到正確內容後仍然判斷錯誤。比起重新問一次碰運氣,至少有一條路徑可以追。
做過後端的人對這套方式不陌生,它就是把 distributed tracing 用在 agent 上。我以前用 tracing 查 PHP-FPM 記憶體洩漏時,看的可能是 DB query 和 HTTP call;換到 agent,只是 span 變成 retrieval、tool call 和 model call,留下每一步足跡的原則沒有改。
而且這件事在 2024 後已經不只是「概念上像」了——它有了正式的開放標準。OpenTelemetry 的 GenAI SIG 從 2024 年起在制定 GenAI Semantic Conventions(CNCF 旗下),直接把「LLM / agent 的 span 該長什麼樣」標準化:模型呼叫叫 chat / inference、工具呼叫叫 execute_tool、agent 層級叫 invoke_agent,屬性有 gen_ai.request.model、gen_ai.usage.input_tokens、gen_ai.tool.name 這些。意思是上面那張 trace 圖不是各家自己亂畫的,而是一套有共識的 schema。一個誠實的提醒:截至 2026 它仍是 experimental 狀態,屬性名還可能變,採用時要留意版本相容。
成本與 Token 監控:因為它會悄悄燒錢
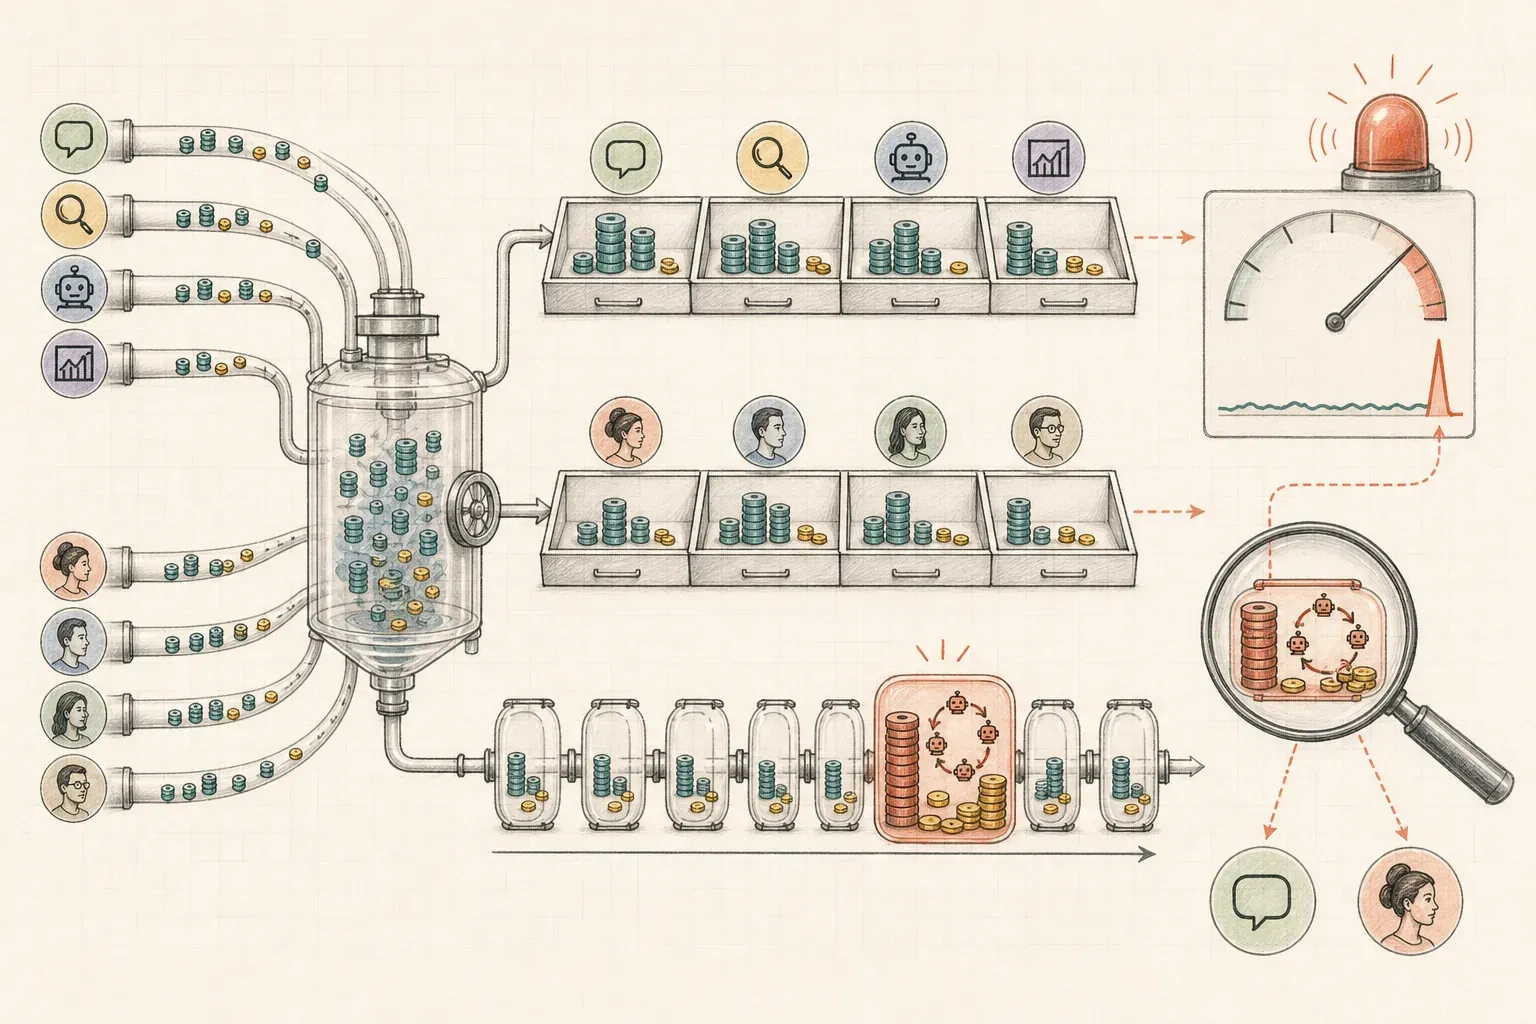
LLM 系統有個傳統服務沒有的特性:每一次呼叫的成本是浮動的,取決於 token 量。一個沒人注意的功能,可能因為 context 越塞越大、或一個 multi-agent 迴圈(第 8 篇)失控,悄悄把帳單翻倍。
所以要把「成本」當成一級 metric 來監控:
- 每個功能 / endpoint 平均花多少 token、多少錢?
- 每個使用者 / 租戶燒多少?(抓異常、做計費)
- 有沒有哪個 trace 異常昂貴(爆 token)?要能告警。
這直接餵給第 10 篇的成本權衡——你不先把成本看見,就無從優化。
上線後:偵測「品質漂移」
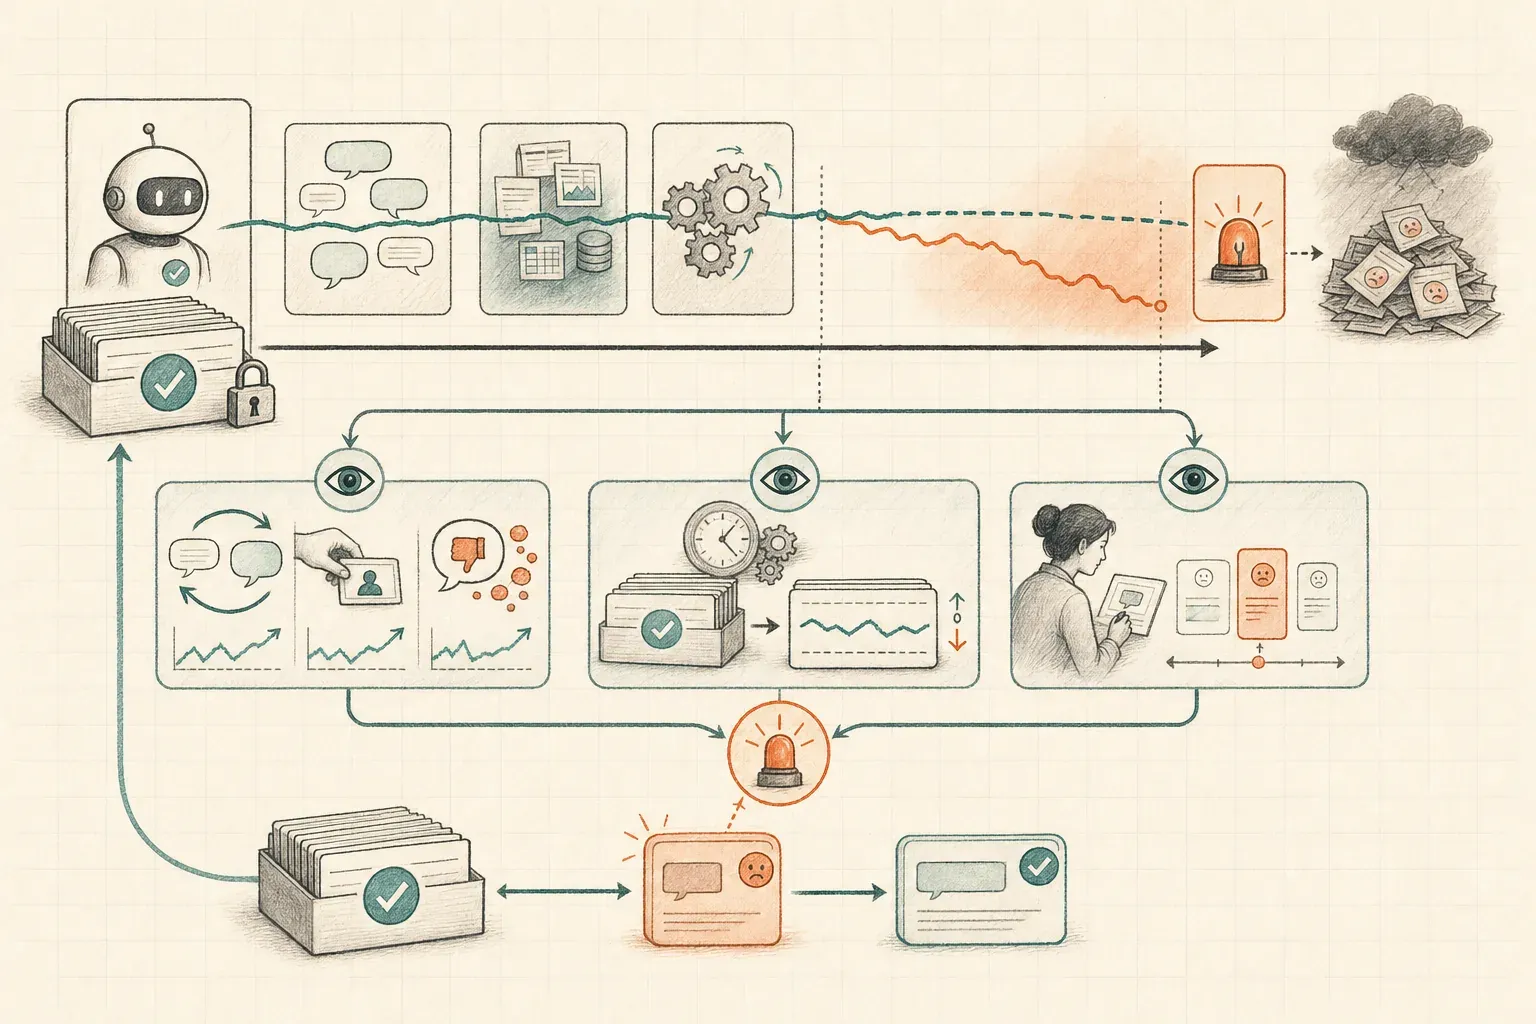
最後一層,是上線後的持續監控。你的黃金題庫是固定的,但真實世界的問題會變、資料會變、模型會被 vendor 偷偷更新。所以要盯著線上的健康訊號:
- 代理指標:使用者重問率、轉人工率、負評率、「這個答案沒幫助」的比例——這些不需要標準答案,就能反映品質掉了。
- 定期回歸:固定排程重跑黃金題庫,模型供應商一更新就可能漂移,你要第一個知道,而不是等客訴。
- 抽樣人工複查:定期抽真實對話人工看,補進黃金題庫。
工具地景(會變,但方向很清楚)
你可能會問:實際上用什麼做?我刻意不把這篇綁死在某個工具上(它們明天就可能改名),但給你一個 2026 的版圖方便開始搜:開源自架有 Langfuse、Arize Phoenix、Opik;商業 SaaS 有 LangSmith、Braintrust;既有 APM 則有 Datadog、New Relic 的 LLM Observability。但比「選哪個」更重要的是一個正在發生的收斂——這些工具都在往 OpenTelemetry GenAI conventions 靠。所以選型第一個該問的不是「dashboard 漂不漂亮」,而是「它能不能吐標準的 OTel span」——能,你換工具時 trace 還搬得走,不會被單一廠商鎖死。
把這個順序畫成決策樹,會發現真正的岔路只有一個,剩下的才是口味問題:
flowchart TD
    A["選型第一個該問的<br/>不是 dashboard 漂不漂亮"] --> B{"能不能吐標準的<br/>OTel GenAI span?"}
    B -->|"不能"| C["被單一廠商鎖死<br/>換工具時 trace 搬不走"]
    B -->|"能"| D{"想怎麼跑?"}
    D --> E["開源自架<br/>Langfuse<br/>Arize Phoenix<br/>Opik"]
    D --> F["商業 SaaS<br/>LangSmith<br/>Braintrust"]
    D --> G["既有 APM<br/>Datadog<br/>New Relic"]
    E --> H["提醒:GenAI conventions<br/>截至 2026 仍是 experimental<br/>屬性名可能變,留意版本相容"]
    F --> H
    G --> H
小結
這篇可以整理成四件要持續做的事:
- Eval harness:黃金題庫 + 混合評分(規則 / 語意 / LLM-as-judge),每次改動都跑回歸,出包的 case 一定補進去。
- Tracing:把每一步(檢索 / 工具 / 模型)變成可攤開的 span,debug 從許願變成看圖。
- 成本監控:把 token 與花費當一級 metric,別讓它悄悄燒。
- 漂移偵測:用線上代理指標 + 定期回歸,在客訴之前發現品質掉了。
四者會組成一個循環:線上 trace、成本告警或品質訊號抓到問題,修正後再把案例補進黃金題庫,避免同一種退步再次上線。
flowchart TD
    A["改動<br/>prompt / 模型版本<br/>檢索參數"] --> B["自動跑一遍<br/>黃金題庫"]
    B --> C{"通過率<br/>掉了嗎?"}
    C -->|"掉了"| D["修好 A 卻弄壞 B<br/>回頭改"]
    D --> A
    C -->|"沒掉"| E["上線"]
    E --> F["Tracing<br/>攤開每一步<br/>看根因"]
    E --> G["成本監控<br/>異常昂貴<br/>就告警"]
    E --> H["漂移偵測<br/>代理指標<br/>+ 定期回歸<br/>搶在客訴之前"]
    F --> I["線上抓到<br/>出包的 case"]
    G --> I
    H --> I
    I --> J["補進黃金題庫<br/>同樣的錯不再犯第二次"]
    J --> B
這些做法和後端測試、可觀測性的思路很接近,只是評分方式與 span 內容不同。下一篇會直接用這些數據來處理延遲、可靠性與成本的取捨。
文章簡報
延伸閱讀
- 上一篇:多代理協作
- Agentic Engineering:測試與安全——把測試與安全紀律套用在 agent 上的另一個視角
- 下一篇:《AI agent 的延遲、可靠性與成本,該怎麼取捨?》