企業 AI Agent 為什麼卡在 PoC?正式上線前要補的六件事
本篇是「從 PoC 到 Production:企業 AI Agent 系統工程」系列的第 1 / 12 篇。你可以從系列總覽開始閱讀,也可以直接接著看本文。
這是「從 PoC 到 Production:企業 AI Agent 系統工程」系列第 1 篇(共 12 篇)。呼叫 LLM API 的教學已經很多了,這個系列想談的是 demo 做完以後,那段比較麻煩、也比較少人寫的工程工作。
兩天的 demo,六個月的卡關
這個場景我看過不只一次:工程師花兩天,用 Claude 或 GPT 串出一個 agent。它會讀公司文件、查資料庫,也能呼叫內部 API。現場問了幾題,答案看起來都不錯,主管當場決定要做。
然後這個專案就卡在那裡,六個月上不了線。
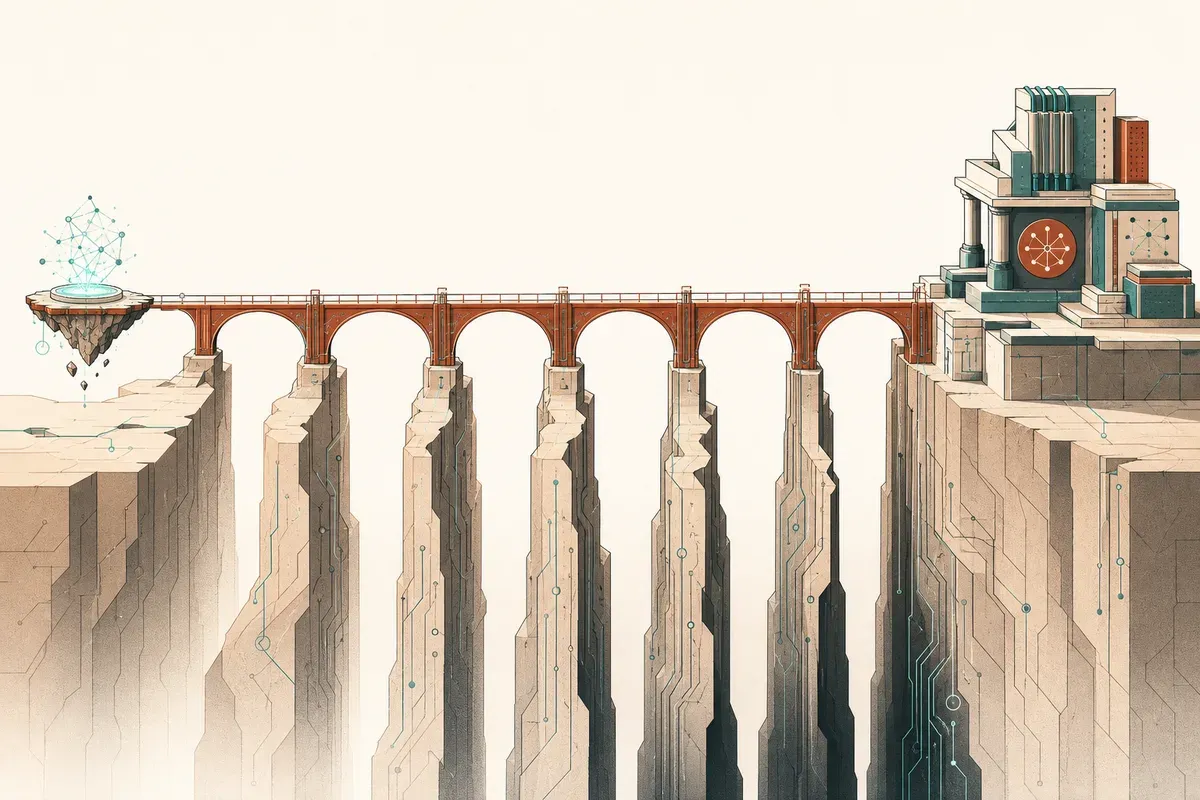
通常不是團隊不努力,也不是模型太弱。Demo 只要把事先準備好的幾題答對;正式系統卻要面對幾千種沒人預先想過的問法,還得把出錯的代價控制住。兩者看起來只差一個部署按鈕,實際上差了一整套工程。
這一年我把 agent 用進不少日常工作:用 Claude Code 寫程式、自己做 MCP server,也把一些耗時任務交給 agent workflow 跑。用得越多,越能感覺到一件事:
讓 agent 動起來不難,難的是讓大家真的敢把工作交給它。
所以第一篇先把問題攤開,看看 demo 到正式上線之間,最常卡住的是哪六件事。後面 11 篇再逐一處理。
鴻溝一:正確性沒有底線
Demo 階段,答錯一題你會笑著說「啊它有時候會這樣」。Production 階段,答錯一題可能是給客戶錯誤的保固資訊、給工程師錯誤的製程參數、給財務錯誤的數字。
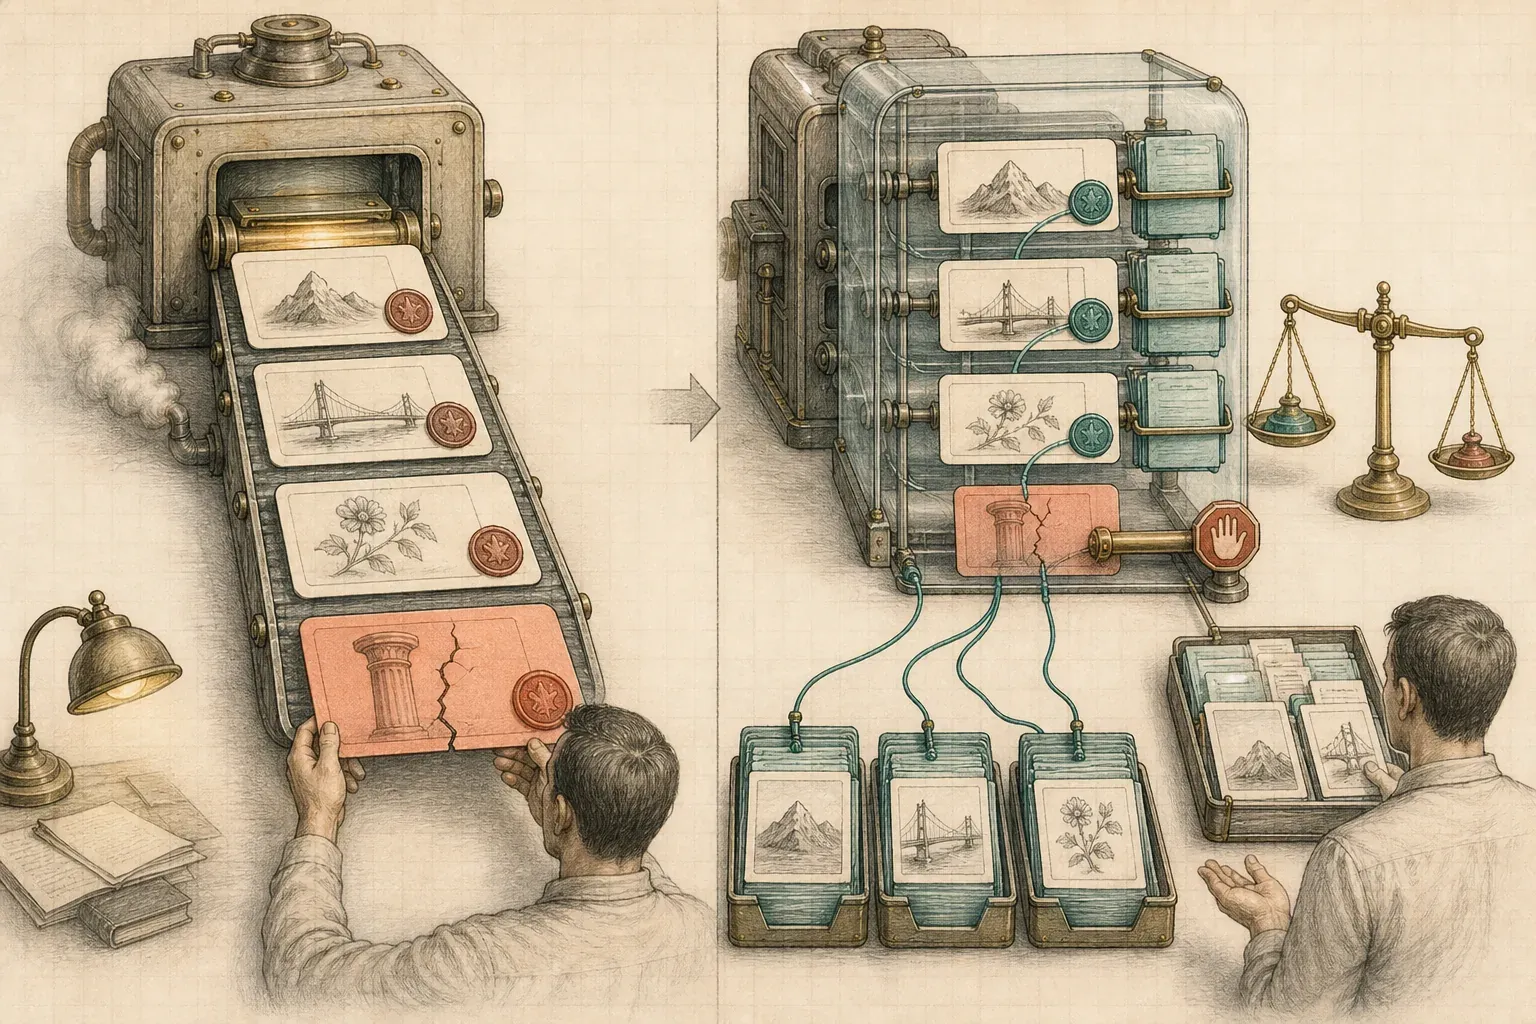
LLM 依機率產生文字,沒有足夠資料時也可能把答案補得很像真的。Demo 現場答錯一題,大家笑一笑就過了;正式系統如果持續用同樣方式答錯,就會變成可重複發生的風險。
因此不必再問模型會不會錯,它一定有答錯的時候。比較實際的是先確認:
- 它錯的時候,系統知不知道?
- 它沒把握的時候,會不會老實講,還是照樣硬answer?
- 答案有沒有來源可以追,讓人能驗證?
這就是為什麼後面要花三章談 RAG 與權限感知檢索(第 3、4、5 篇)——把答案綁回可追溯的來源,是讓正確性有底線的第一步。
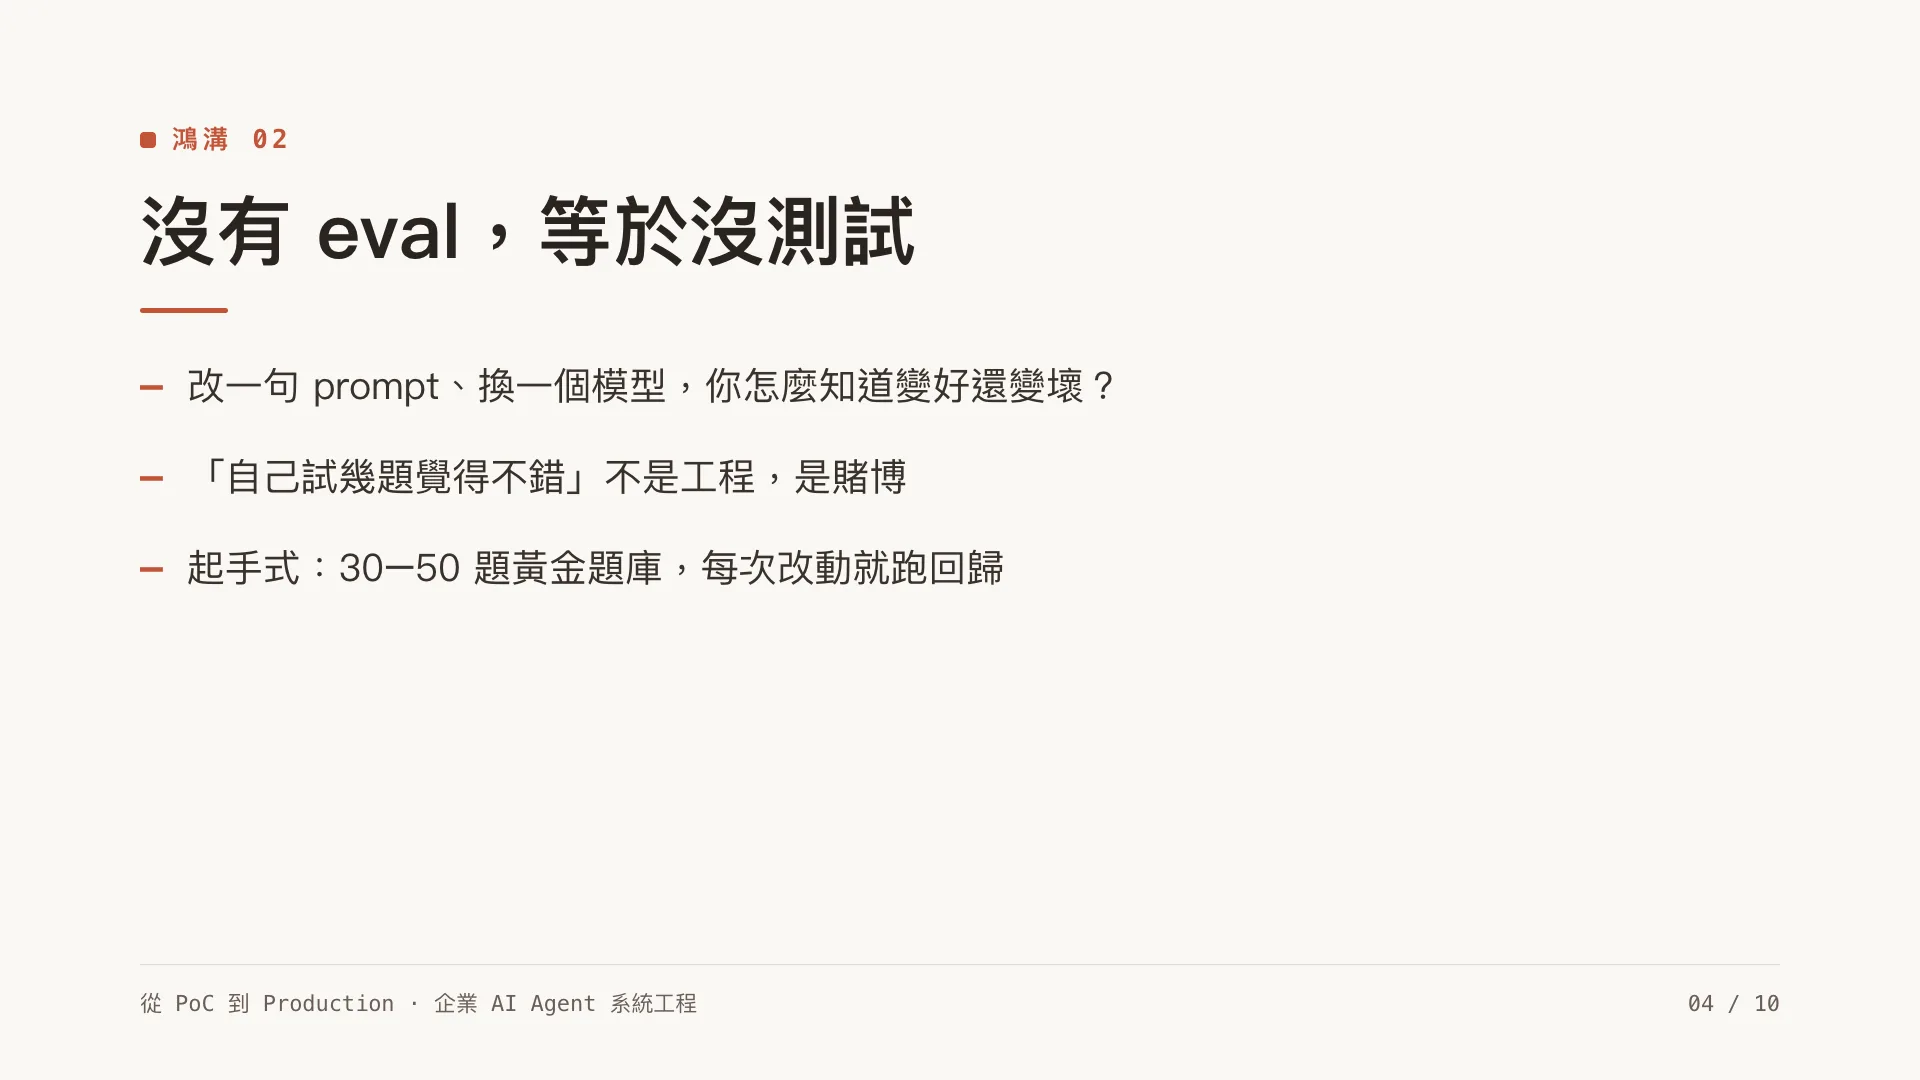
鴻溝二:沒有 eval,你根本不知道有沒有變好
傳統軟體你改一行 code,跑一遍測試,綠燈就敢上。AI agent 你改一句 prompt、換一個模型、調一個檢索參數,你怎麼知道它變好還是變壞了?
只靠「我試了幾題,感覺不錯」就上線,風險實在太高。
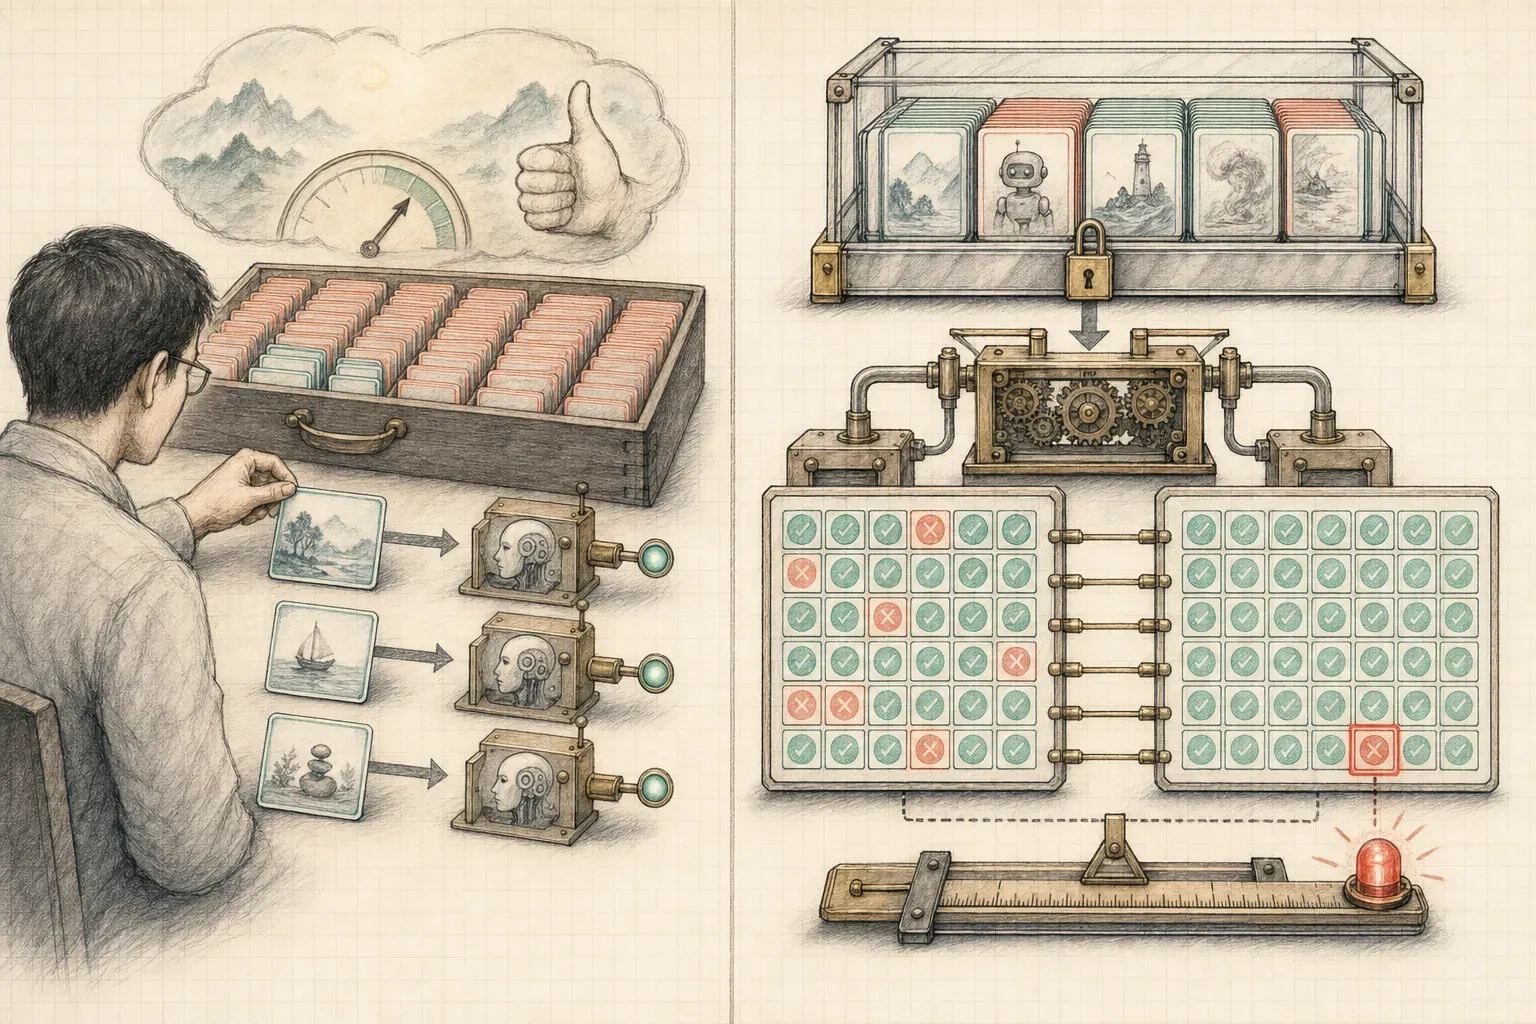
Demo 不需要 eval,因為你只 demo 你知道會過的題目。Production 一定要 eval,因為:
- 換模型版本(連 vendor 自己 silent update 都可能)會讓行為漂移
- 改 prompt 修好 A 問題,常常默默弄壞 B 問題
- 沒有一組「黃金題庫」當回歸測試,你每次上線都是裸奔
而且別把 eval 想成什麼龐大基礎建設。起手式可以很小:先盯著你最痛的那幾類問題,整理 30 到 50 題「標準答案我心裡有數」的黃金題庫,每次改 prompt、換模型、調檢索參數就跑一遍,看通過率往哪邊動。光是有這條基準線,你就從「我自己試了幾題覺得不錯」升級成「這次改動讓通過率從 82% 掉到 76%,先別上」。
沒有 eval harness,就像改完軟體卻沒有回歸測試。第 9 篇會再細談怎麼把 eval 和可觀測性補起來。
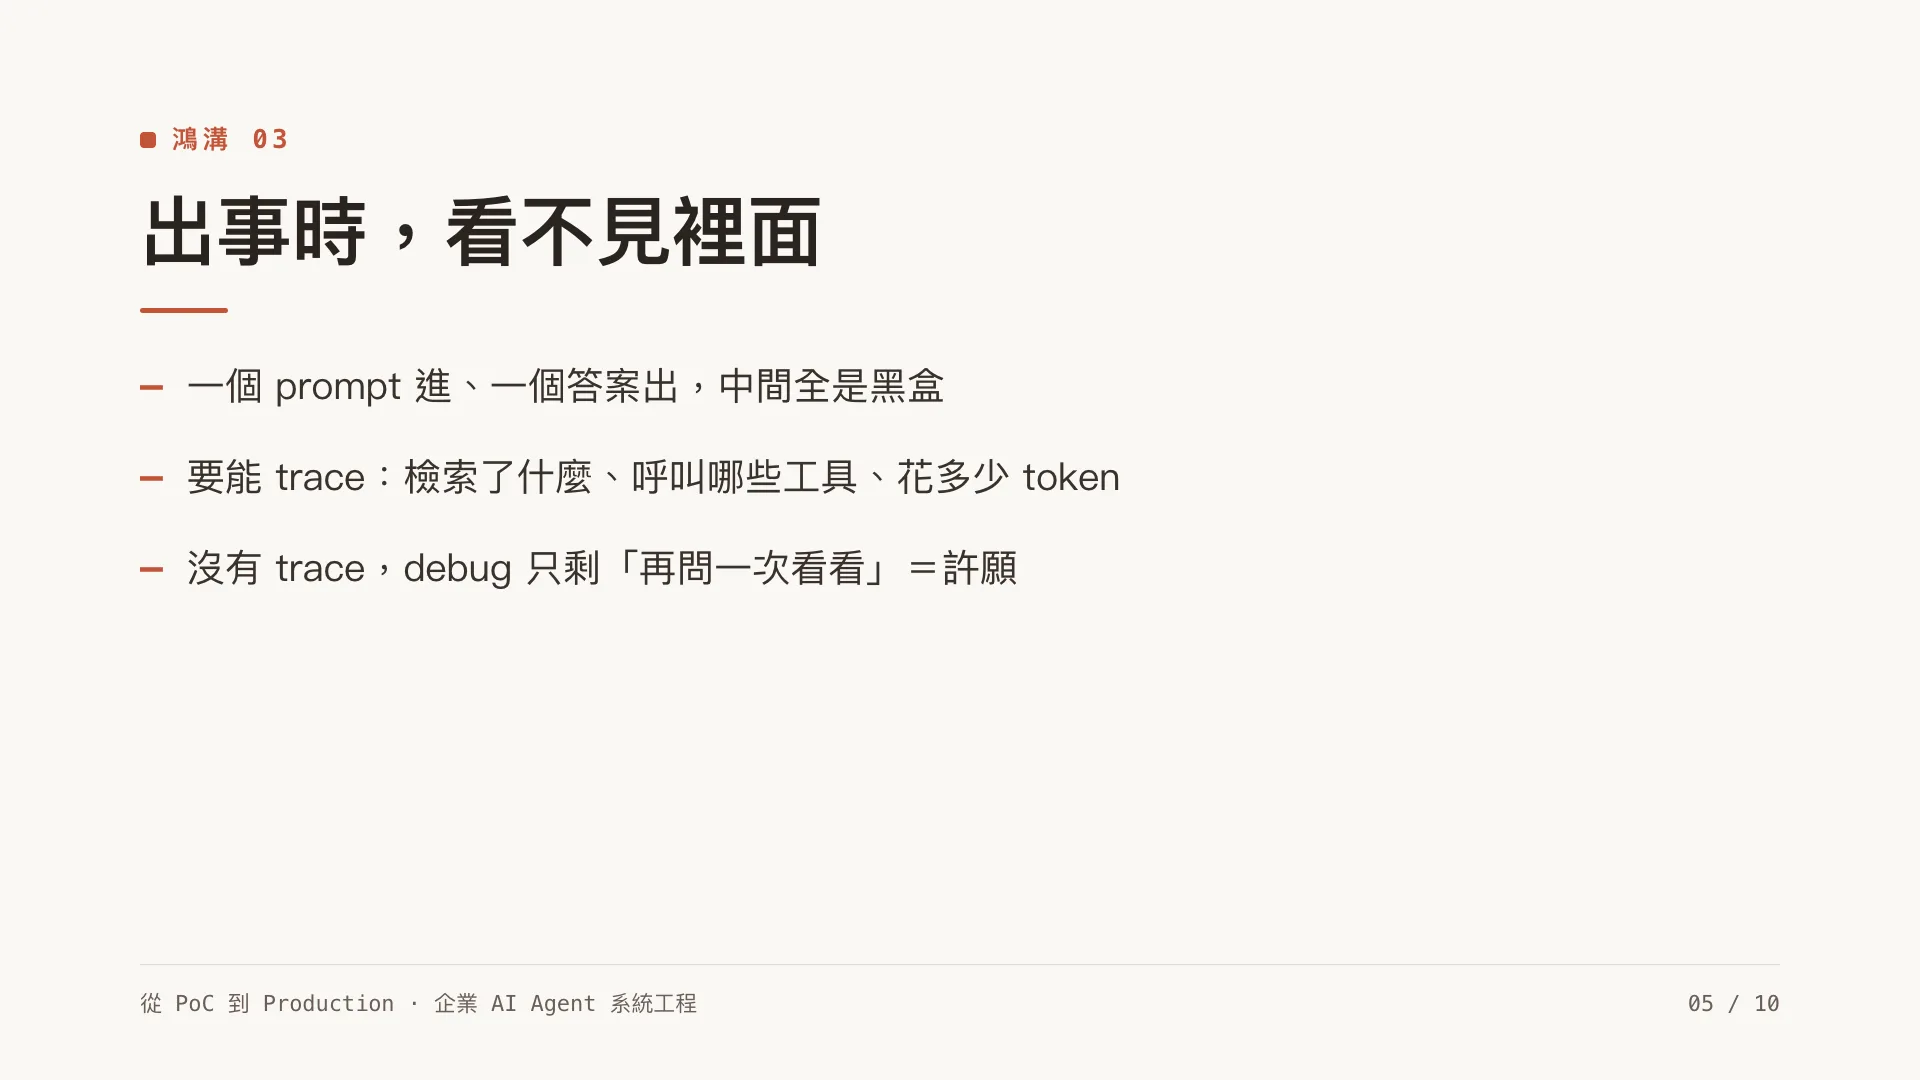
鴻溝三:出事的時候,你看不見裡面發生什麼
傳統後端掛了,你有 log、有 trace、有 metrics,可以一路追到哪個 service、哪個 query、哪一行。
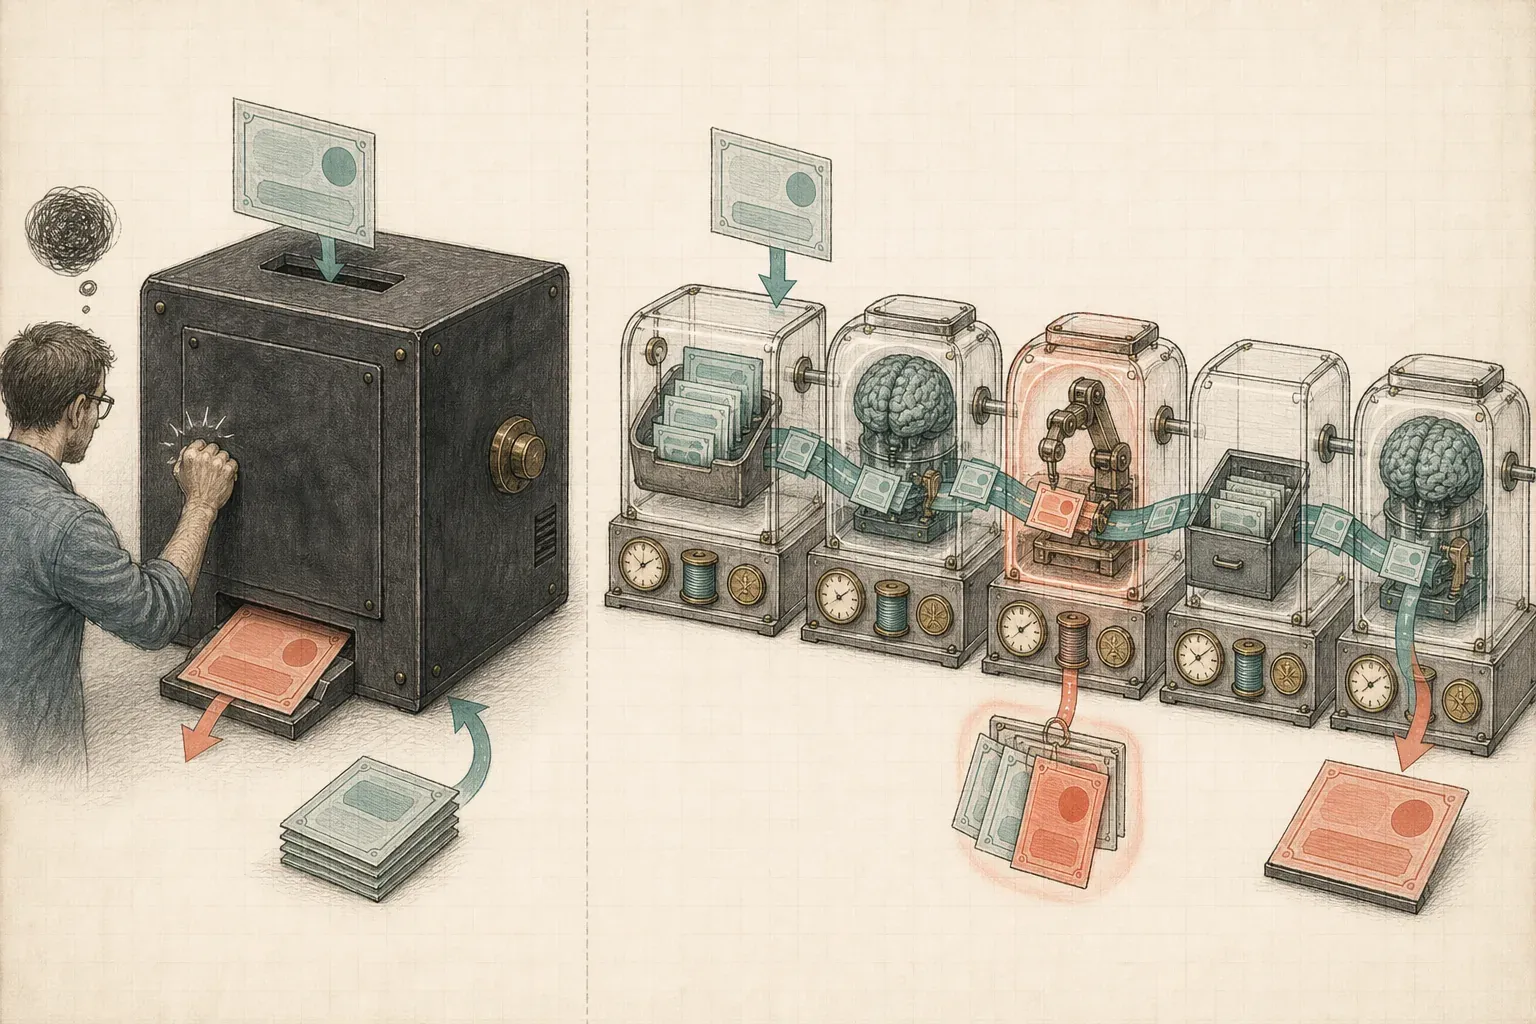
Agent 答錯了,你有什麼?很多 PoC 的答案是:什麼都沒有。一個 prompt 進去、一個答案出來,中間它檢索了什麼、呼叫了哪個工具、為什麼選這條路,全是黑盒。
正式系統至少要留得下足跡。對 agent 來說,下面幾個問題都應該查得到答案:
- 這個答案是基於哪幾份檢索到的文件?
- Agent 呼叫了哪些工具、傳了什麼參數、拿回什麼?
- 每一步花了多少 token、多少時間、多少錢?
- 哪一步是整條鏈失敗的根因?
我以前靠 tracing 抓過一個 PHP-FPM 的記憶體洩漏——沒有那條 trace,你只會看到「服務又慢了」,永遠不知道是哪一段在吃記憶體。Agent 是一模一樣的處境,只是黑盒更深:一個答案背後可能串了三次檢索、兩個工具呼叫、一輪 reasoning。今天這層觀測已經有現成的標準和工具可以接(第 9 篇細談),差別只在你願不願意把它當成跟後端一樣的基本要求。
沒有 trace,agent 答錯時就只剩「再問一次看看」這招。這跟維運沒有太大關係,比較像碰運氣。(至於要默念阿們、阿拉,還是阿彌陀佛,就看個人信仰了。)
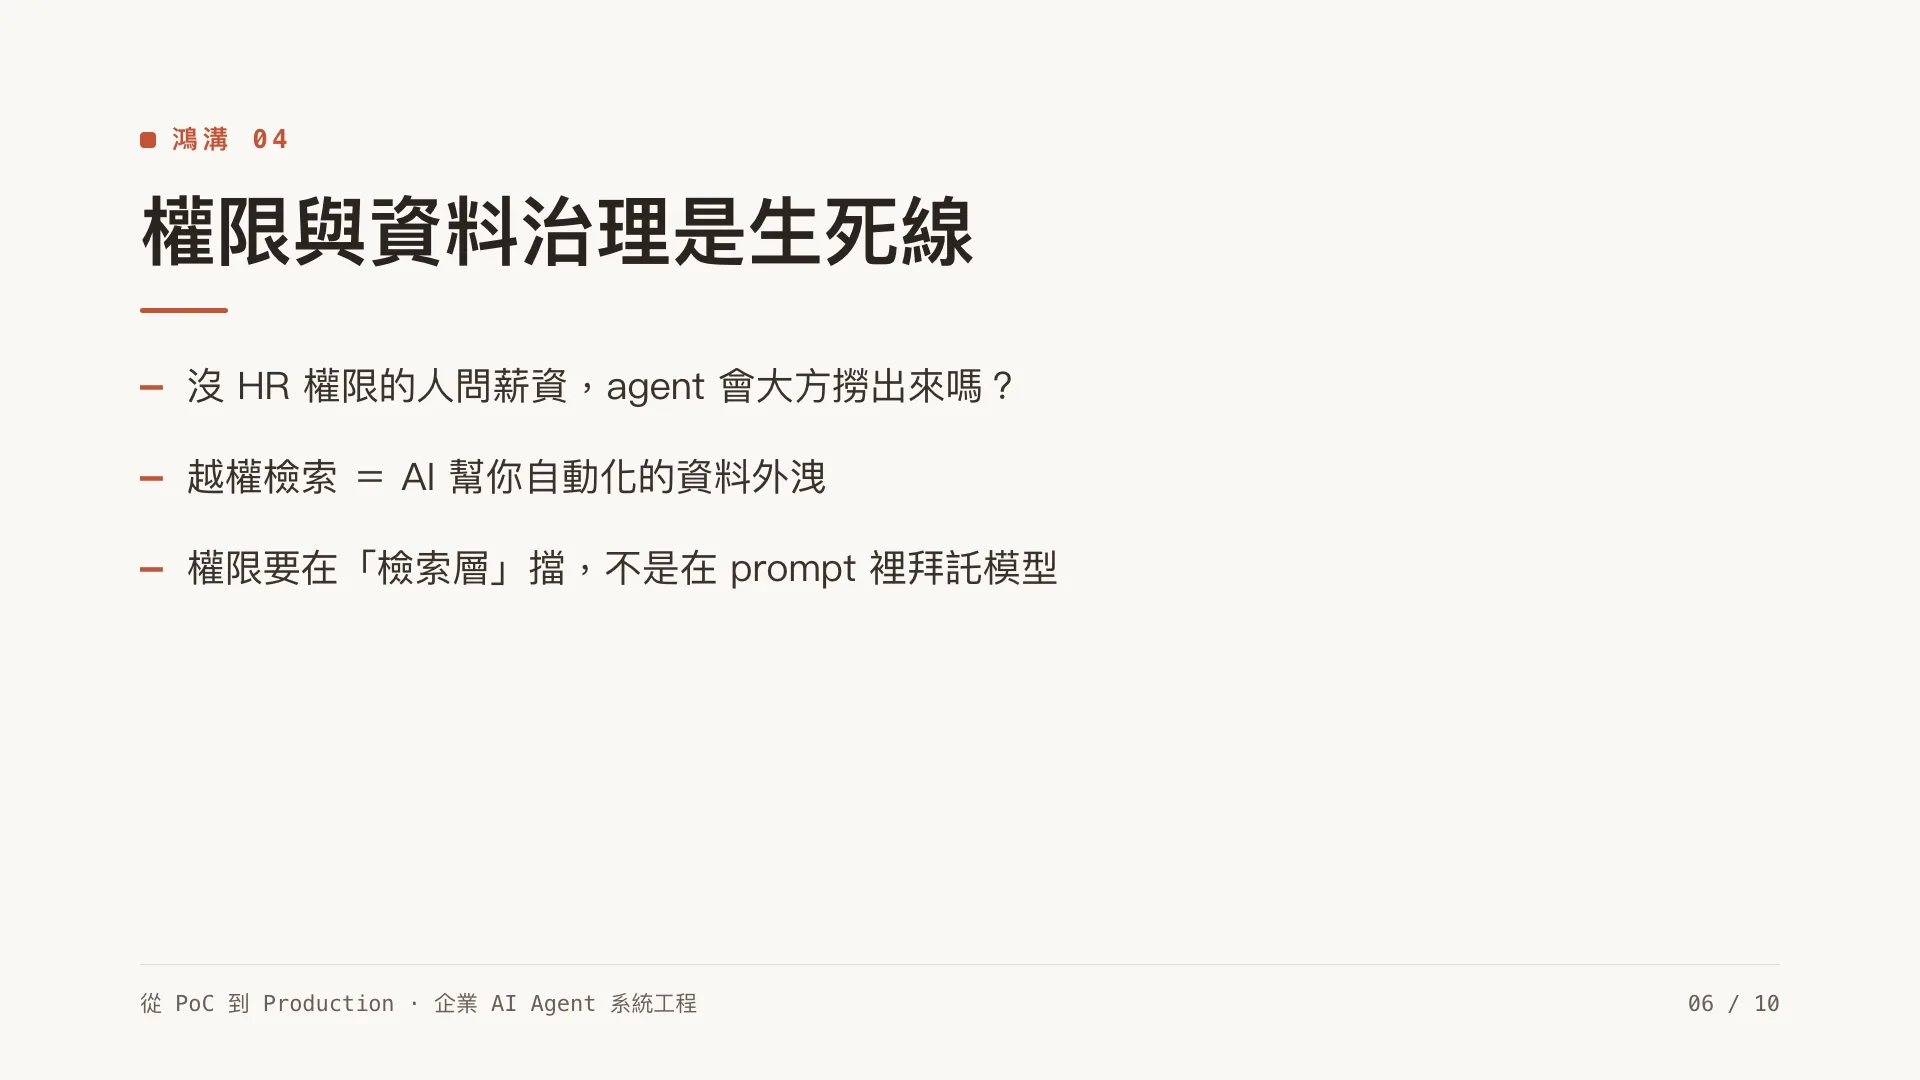
鴻溝四:權限與資料治理,是企業的生死線
個人做 RAG 時,資料通常全是自己的,很容易忽略權限。放到公司裡就完全不同,而這也正是很多 PoC 到資安審查才突然卡住的原因。
你的 RAG agent 會檢索公司文件。問題來了:
- 一個沒有 HR 權限的員工問「某某人的薪資」,agent 會不會因為那份文件剛好在向量庫裡,就大方檢索出來回答?
- 不同部門、不同機密等級的資料,retrieval 的時候有沒有照使用者的權限過濾?
- 答案引用了某份文件,那位使用者本來有沒有資格看那份文件?
Demo 常用一個權限全開的帳號,這個問題自然看不見。正式上線後,只要檢索到了使用者原本不能看的內容,就已經是資料外洩。第 5 篇會專門處理權限感知檢索;就我的觀察,這也是企業 RAG 最難補的一塊。
鴻溝五:成本與延遲,不是「之後再優化」
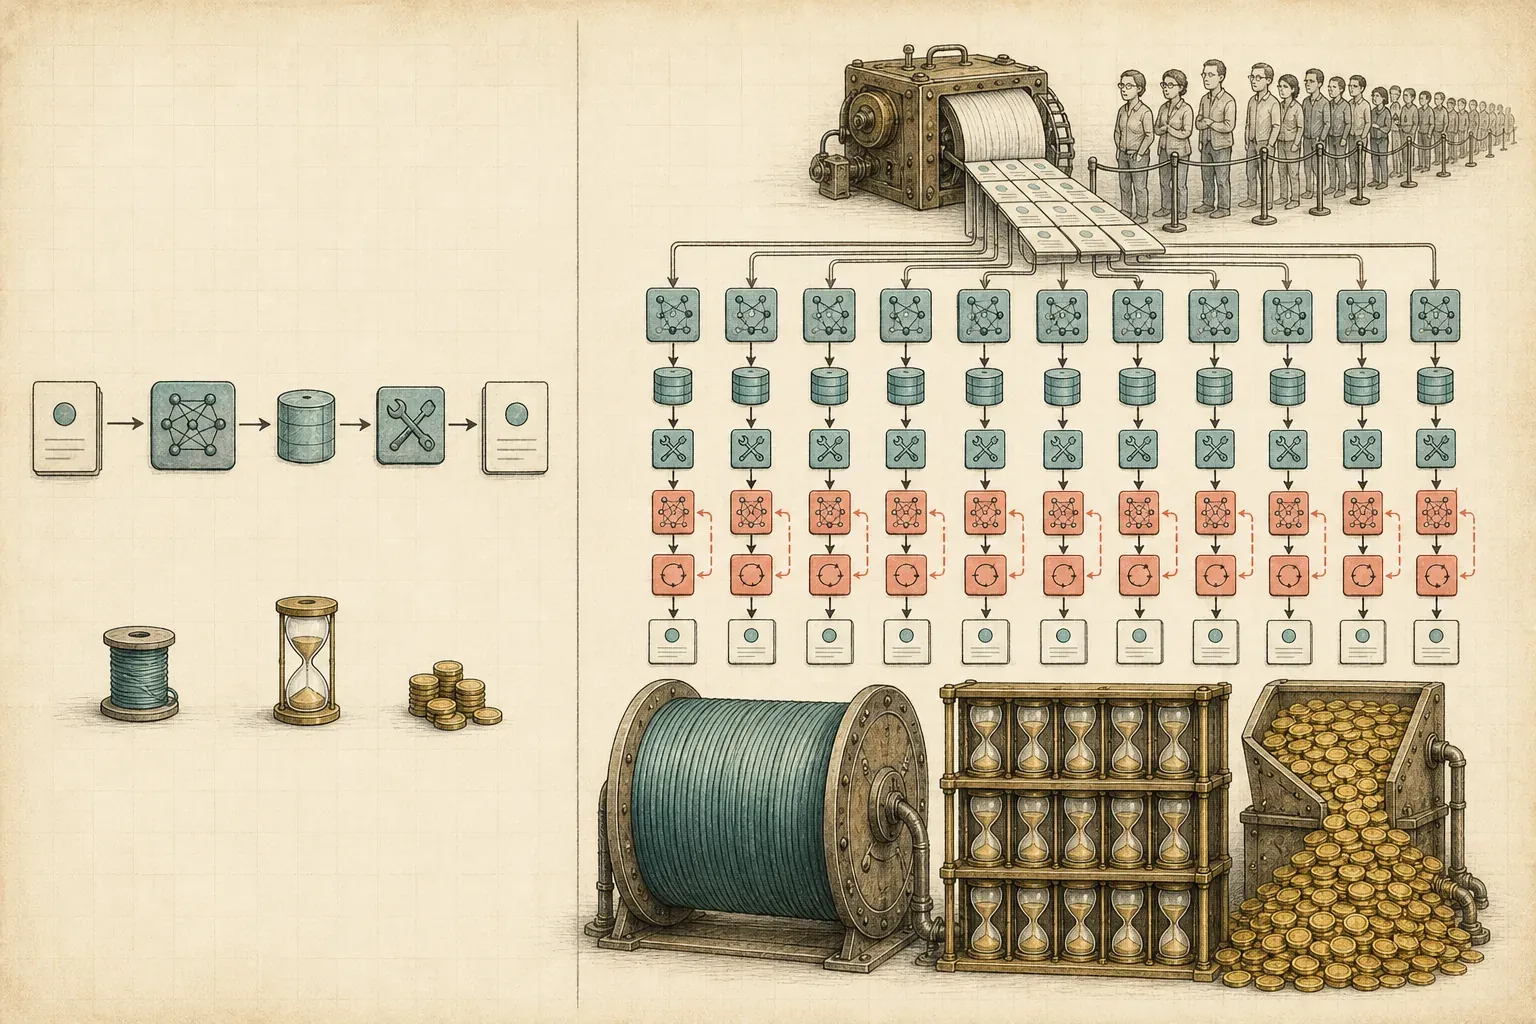
Demo 一天被呼叫 20 次,你不在乎一次花多少 token。Production 一天被呼叫 20 萬次,每次多串一個 model call、多檢索 10 份文件、多跑一輪 reasoning,乘上 20 萬,就是真金白銀和使用者等到關掉分頁的延遲。
AI agent 有個 demo 階段看不到的特性:它很容易「想很多」。一個 multi-agent 的設計、一個 reasoning chain,在 demo 裡是「哇好聰明」,在 production 裡可能是「一個問題燒掉 5 萬 token、跑了 40 秒」。
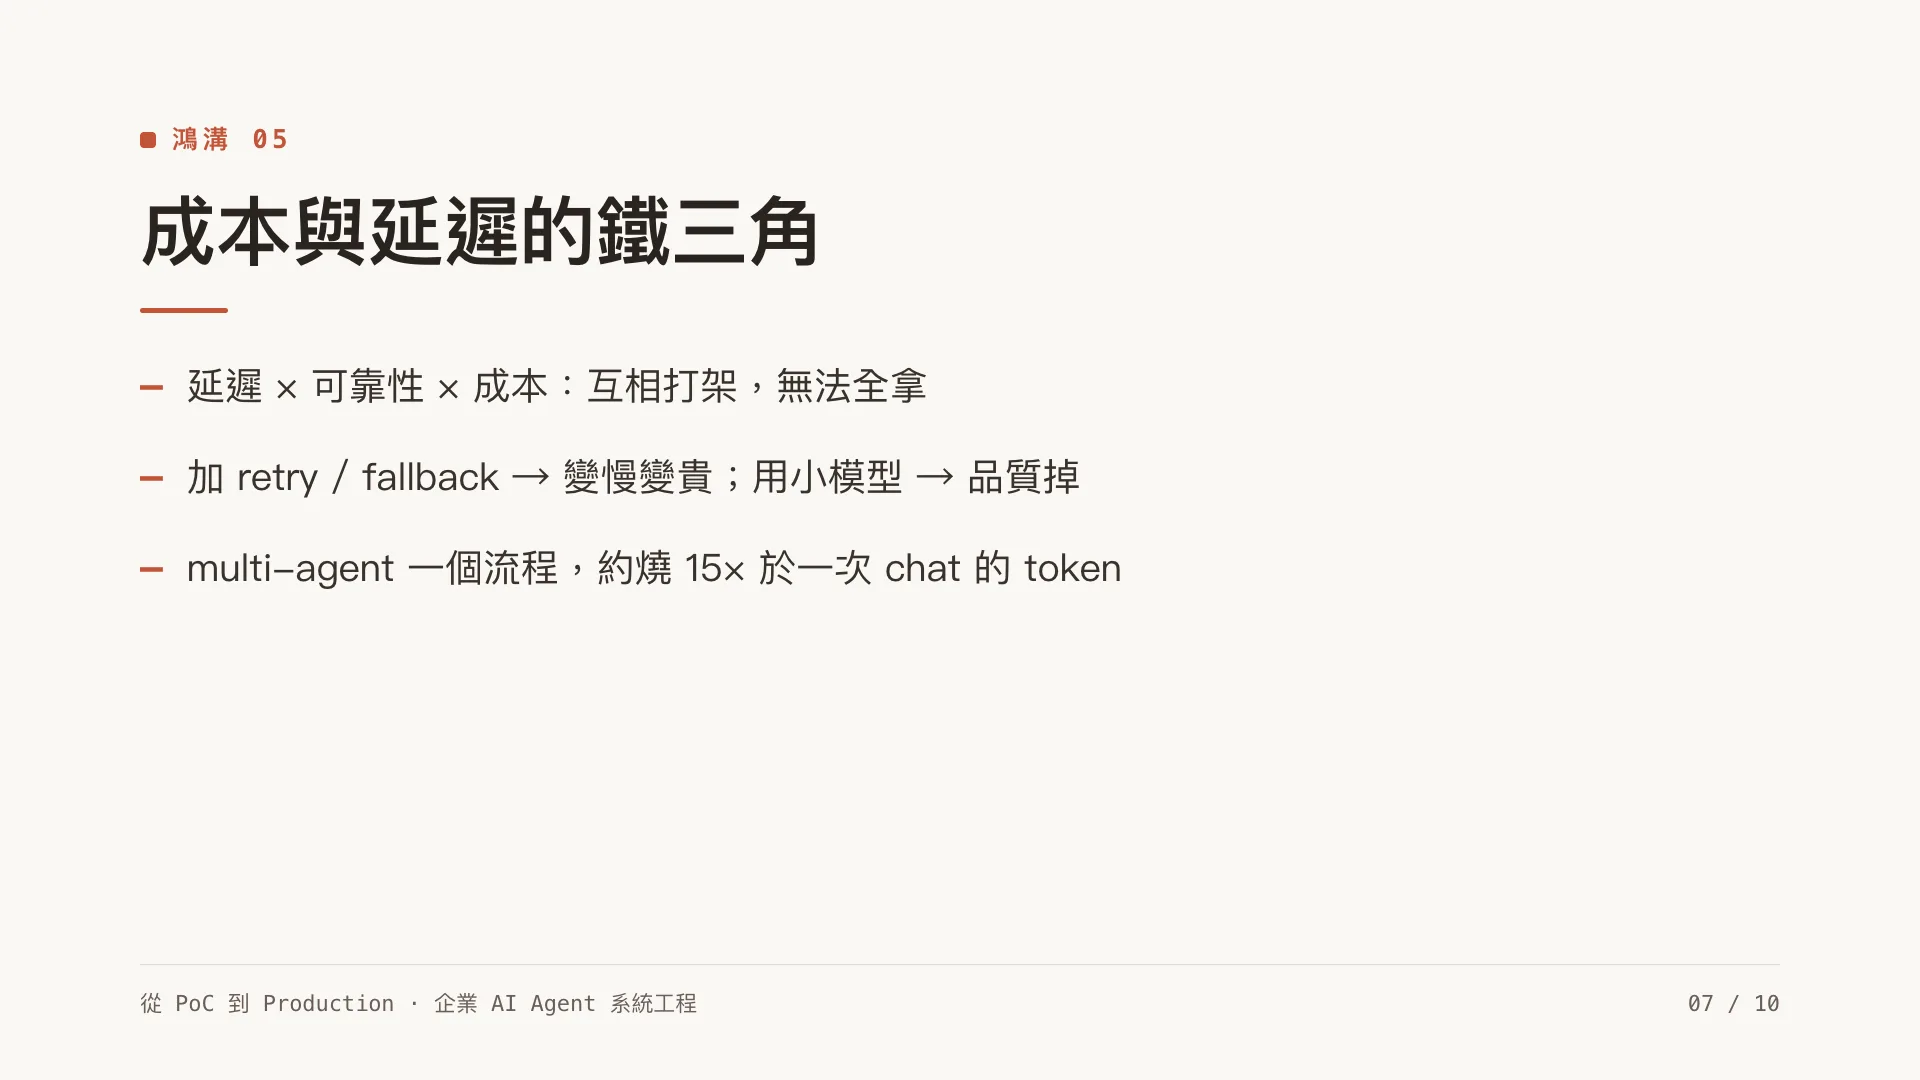
這不是憑感覺嚇你。Anthropic 自己揭露過他們的 multi-agent research 系統:一個 multi-agent 流程用掉的 token,大約是一次普通 chat 的 15 倍(單一 agent 也有 4 倍)。multi-agent 之所以顯得聰明,很大一部分就是因為它燒得多——這在 demo 裡你看不到帳單,乘上 production 每天幾十萬次呼叫,就是會被約談的數字。(我以前在 CatchPlay 同時開過500台EC2進行轉檔, 也被約談過… XD)
麻煩的是,延遲、可靠性和成本往往會互相拉扯:
- 想可靠 → 加 retry、加 fallback model → 變慢、變貴
- 想便宜 → 用小模型、少檢索 → 品質掉
- 想快 → 少 reasoning、激進 cache → 可能犧牲正確性
這些取捨最好在設計時就算進去,不能等帳單來了才處理。第 10 篇會完整討論這三者怎麼平衡。
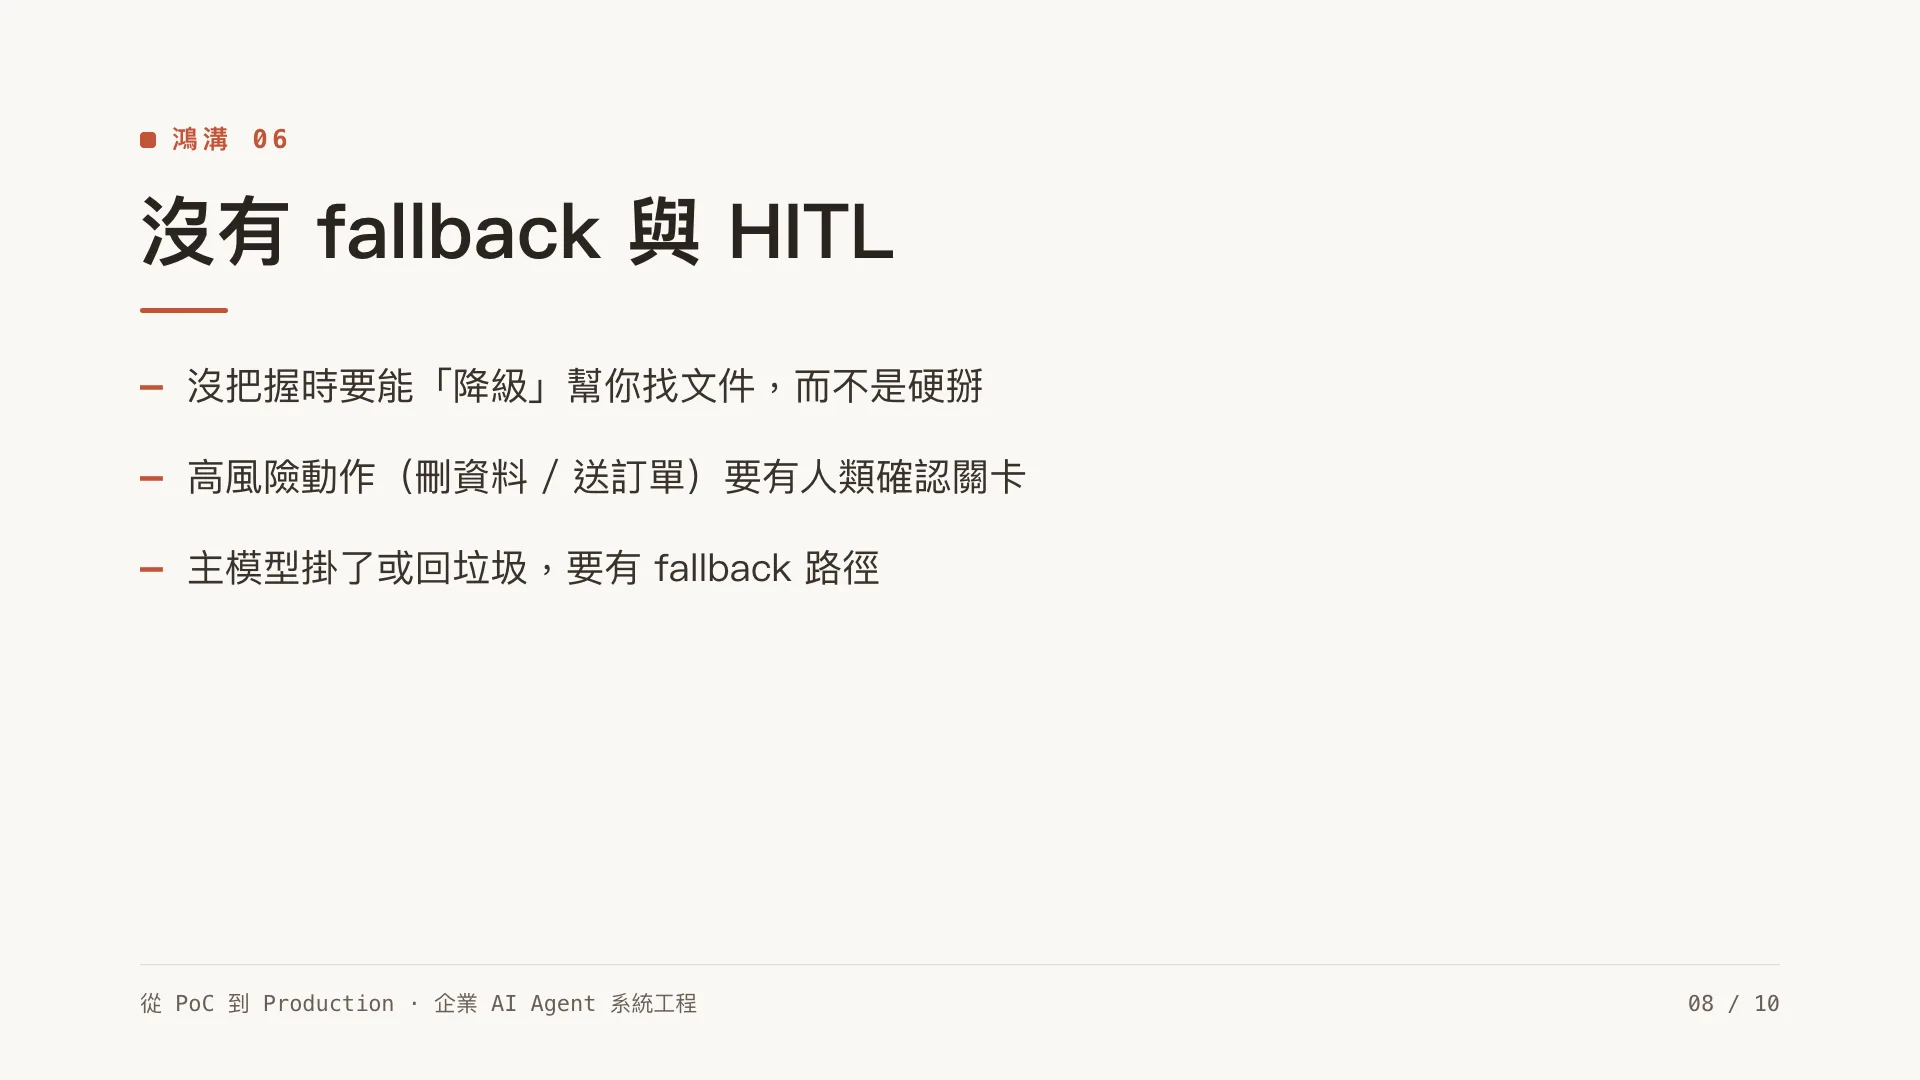
鴻溝六:沒有 fallback 和人類介入點
最後一件事,是先接受 agent 一定會失敗。成熟的系統不會假設它每次都能自己搞定,而是預先安排失敗時要往哪裡走。
- Agent 沒把握的時候,能不能降級到「我幫你找到這幾份文件,請你自己判斷」,而不是硬掰一個答案?
- 高風險的動作(刪資料、送出訂單、改設定),有沒有一個 human-in-the-loop 的確認關卡?
- 主要模型掛了、或回了垃圾,有沒有 fallback 路徑?
會使用工具的 agent,風險不只在回答錯誤。它可能真的改到資料、動到錢,或送出收不回來的內容。因此 action boundary 和 approval flow(第 6、11 篇)應該一開始就設計,不適合等上線後再補。
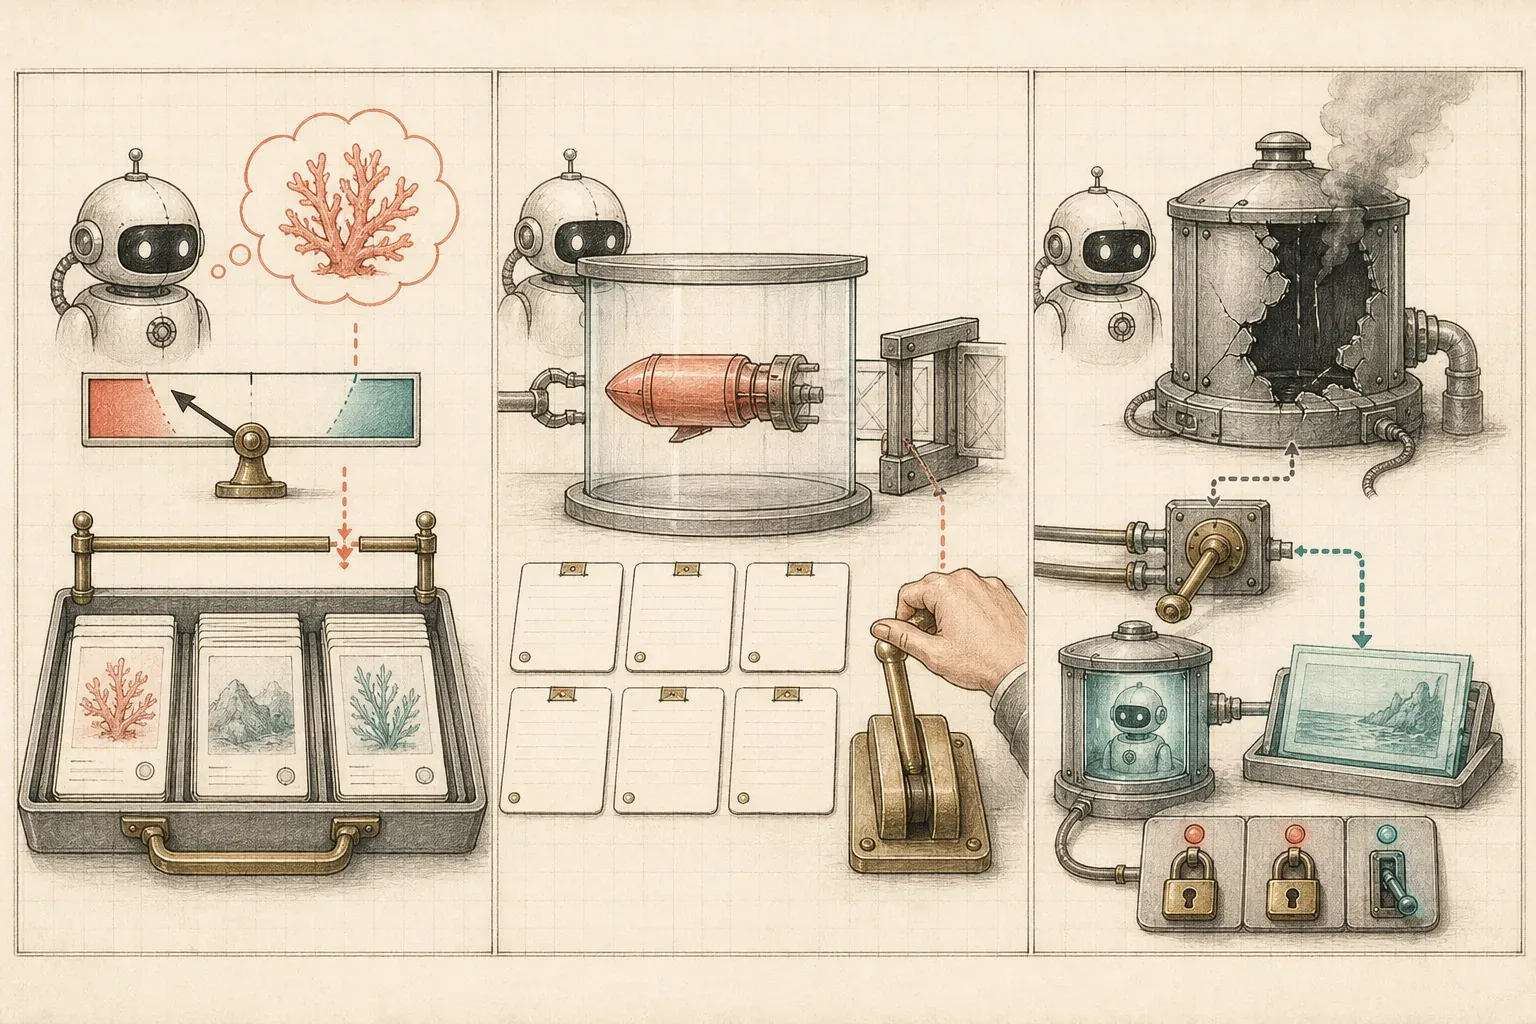
把六道鴻溝變成一張地圖
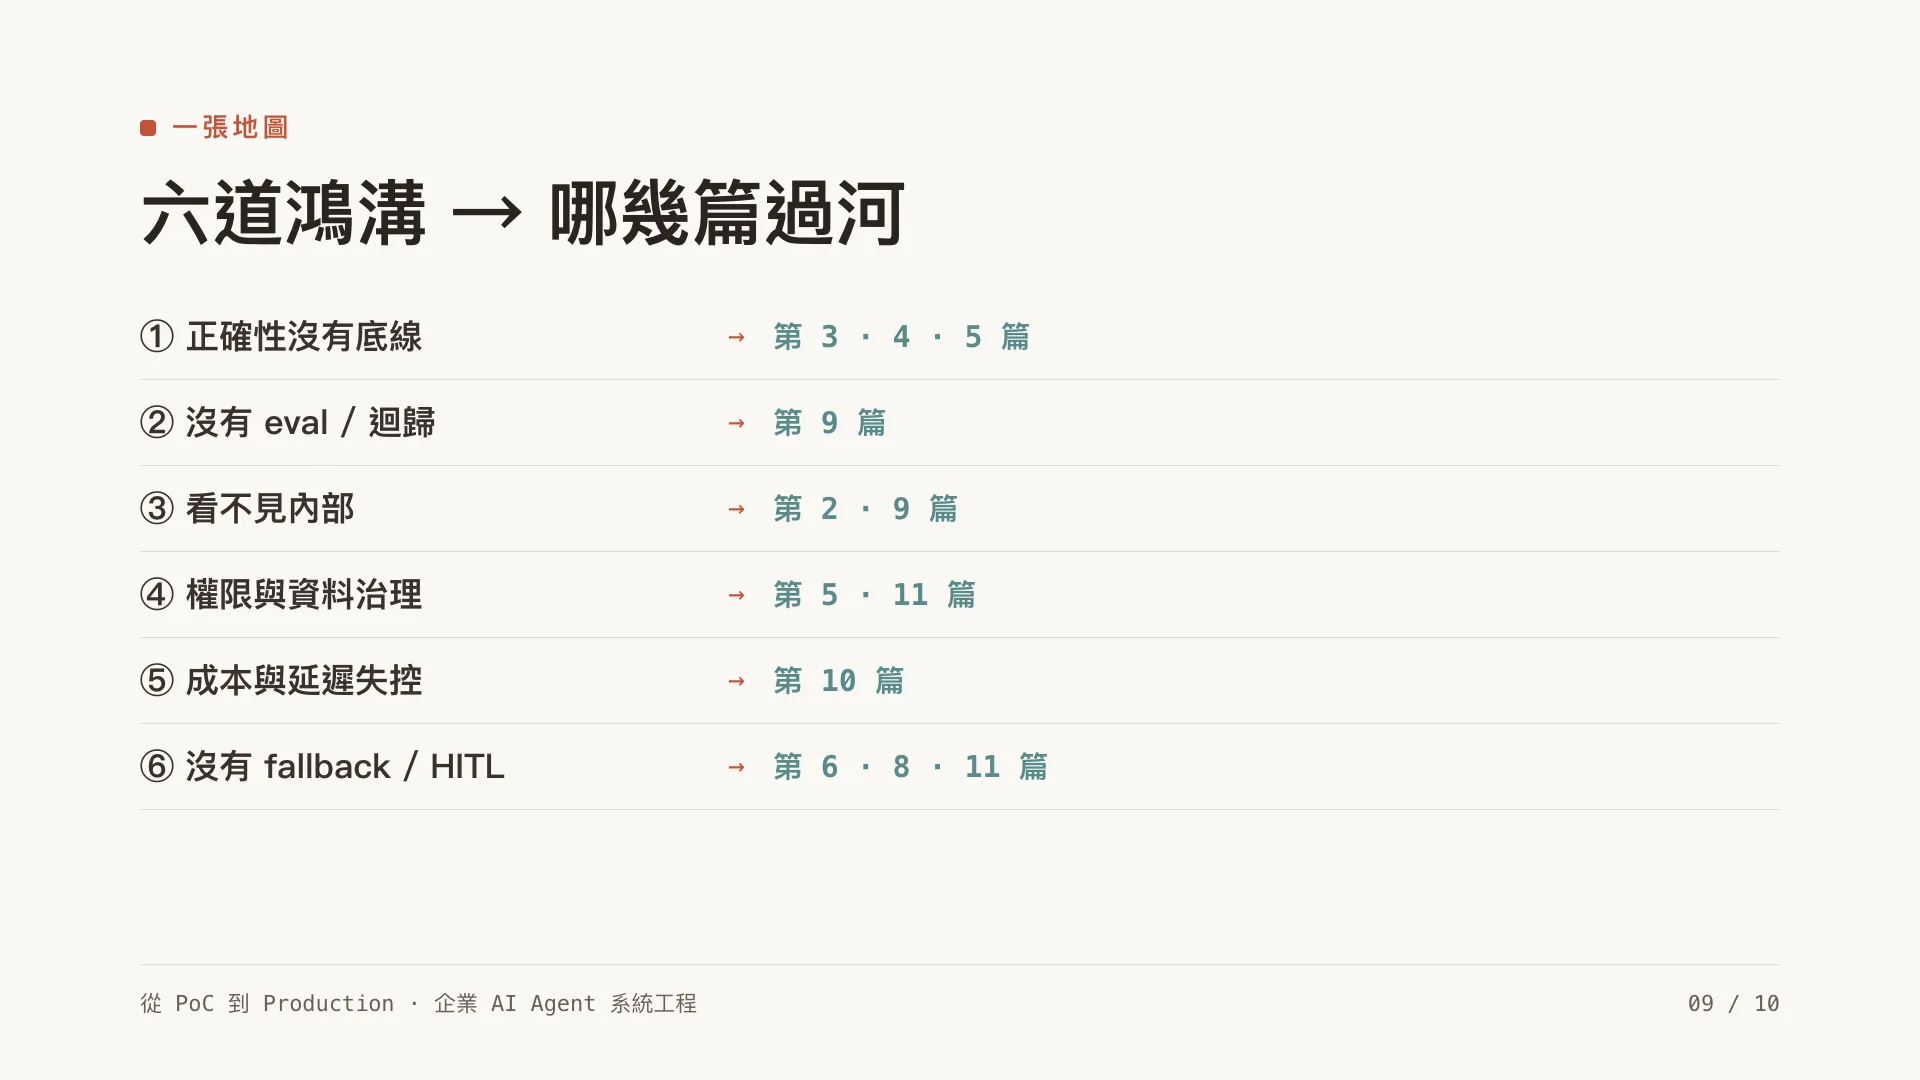
把上面整理起來,這就是這本書的骨架——每一道鴻溝,對應後面一到幾篇:
| # | 鴻溝 | 在哪幾篇過河 |
|---|---|---|
| 1 | 正確性沒有底線 | 第 3、4、5 篇(RAG / 向量檢索 / 權限) |
| 2 | 沒有 eval / 迴歸 | 第 9 篇(可觀測性與評估) |
| 3 | 看不見內部 | 第 2、9 篇(架構 / trace) |
| 4 | 權限與資料治理 | 第 5、11 篇(權限檢索 / 治理) |
| 5 | 成本與延遲失控 | 第 10 篇(系統權衡) |
| 6 | 沒有 fallback / HITL | 第 6、8、11 篇(tool use / 多代理 / 治理) |
表格看不出來的是交叉——同一篇常常同時在補好幾道鴻溝,畫成圖就一目了然:
flowchart LR
    G1["鴻溝 1<br/>正確性沒有底線"] --> C345["第 3、4、5 篇<br/>RAG / 向量檢索 / 權限"]
    G2["鴻溝 2<br/>沒有 eval 與迴歸"] --> C9["第 9 篇<br/>可觀測性與評估"]
    G3["鴻溝 3<br/>看不見內部"] --> C9
    G3 --> C2["第 2 篇<br/>系統架構藍圖"]
    G4["鴻溝 4<br/>權限與資料治理"] --> C345
    G4 --> C11["第 11 篇<br/>治理框架"]
    G5["鴻溝 5<br/>成本與延遲失控"] --> C10["第 10 篇<br/>系統權衡"]
    G6["鴻溝 6<br/>沒有 fallback 與人類介入"] --> C6["第 6 篇<br/>tool use"]
    G6 --> C8["第 8 篇<br/>多代理"]
    G6 --> C11
看右邊那幾個匯流點就知道哪幾篇最吃重:第 9 篇同時接住鴻溝 2 和 3、第 11 篇接住鴻溝 4 和 6、第 3–5 篇則同時是正確性和治理的基礎。如果你時間有限只能先讀幾篇,從匯流點下手效益最高。
還有一個工程師容易忽略、但在 2026 越來越硬的視角:這六道鴻溝不只是你內部會卡的工程問題。其中正確性、資料治理、可追溯、人類介入這幾道,剛好就是 EU AI Act、NIST AI RMF、ISO/IEC 42001 正在要求企業做到的事——而像 ISO/IEC 42001 這種 AI 管理系統認證,已經開始被寫進大型企業的採購盡職調查清單。所以過這幾道河,不只是讓系統能被信任,也是在替合規鋪路。第 11 篇會把這層治理視角收成一張框架圖,也會把法規時間表講清楚。
下一篇(第 2 篇),我會把這六道鴻溝收斂成一張企業 AI Agent 的系統架構藍圖——一張圖看懂一個能上 production 的 agent 系統長什麼樣,每個元件為什麼存在、少了它會怎樣。先講清楚,那是一張參考架構(設計提案),不是哪個已經部署好的成品;但它背後的每一個取捨,都是從上面這六道鴻溝推出來的。
如果手上正好有一個 demo 很漂亮、團隊卻一直不敢上線的 agent,可以先拿這六項逐一檢查。多半不是再換一個更強的模型就能解決,而是該補的工程還沒補齊。
文章簡報
延伸閱讀
- Agentic Engineering 是什麼?為什麼 Karpathy 要發明這個詞——先搞懂「用 agent 工作」和「打造 agent 系統」是兩件事
- 從「寫 code 的人」到「管 agent 的人」——角色轉換的心理那一面
- 下一篇:《AI Agent 系統架構:正式上線前要補齊哪些元件》